Varför bildbehandling i webbläsaren är en vinst för integriteten
Hur moderna webb-API:er låter dig bygga bildverktyg som faktiskt är privata — och vad det betyder för människorna som använder dem.
 The Wux Webtools Team
5 min läsning
Innehållsförteckning
- Standardförväntningen är fel
- Vad "klientsidan" faktiskt betyder
- Varför detta spelar roll i praktiken
- Var kompromisserna fortfarande finns
- Kallstarten är tyngre
- Användarens hårdvara sätter taket
- Du kan inte batcha över användare
- Vissa operationer behöver en server
- En liten etisk poäng
- Vart du går härifrån
Standardförväntningen är fel
Under större delen av de senaste tjugo åren innebar allt icke-trivialt arbete med en bild på webben att den laddades upp till en server. Konvertera ett HEIC-foto, ta bort dess EXIF-metadata, generera en favicon — alla dessa verktyg låg historiskt bakom ett multipart-formulär. Användaren klickade på ladda upp, filen färdades över det öppna internet och en server någonstans gjorde jobbet.
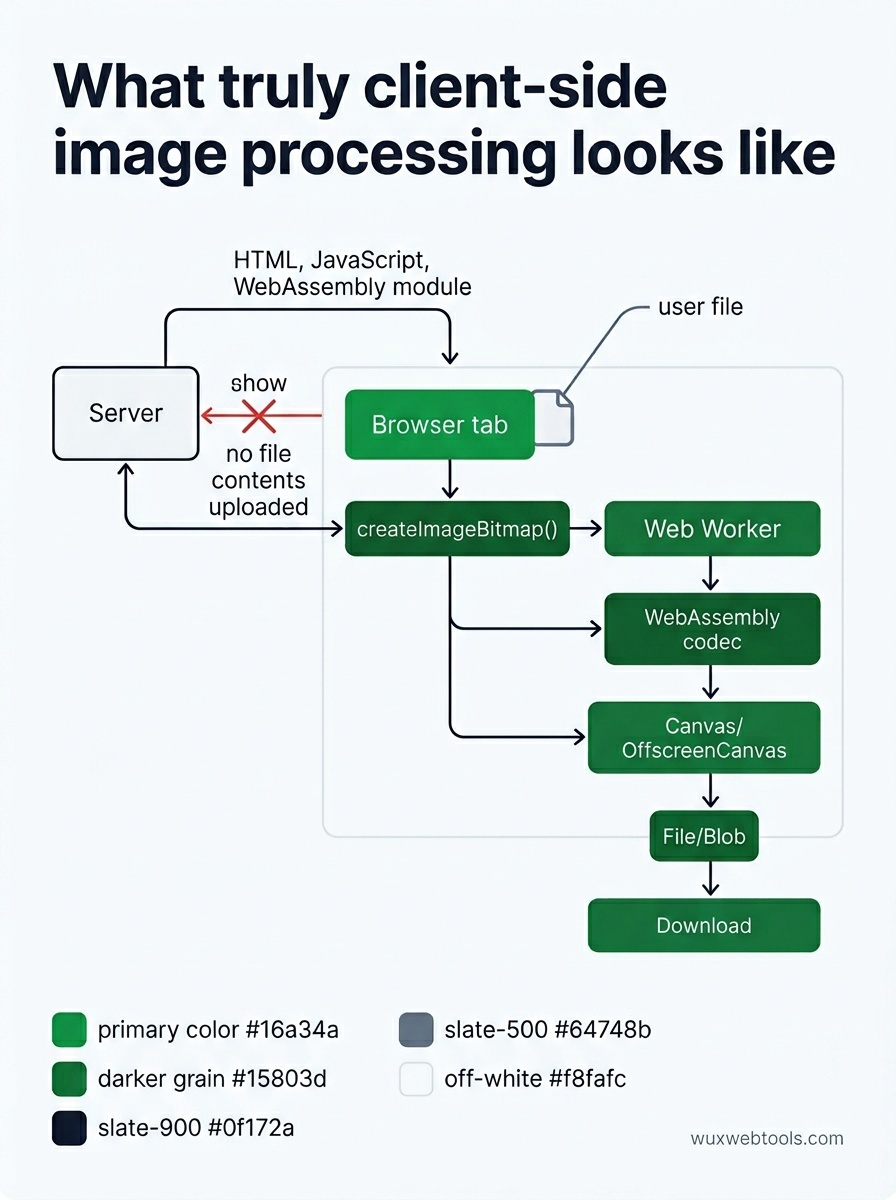
Den standardlösningen är inte längre tekniskt nödvändig. Webbläsare har sedan flera år API:er som gör att hela kedjan kan köras lokalt:
<canvas>ochOffscreenCanvasför arbete på pixelnivåcreateImageBitmap()för snabb avkodning utanför huvudtrådenFileochBlobför att läsa uppladdningar utan att skicka dem någonstans- WebAssembly för bibliotek som libheif, libwebp och ffmpeg
- Web Workers för att hålla gränssnittet responsivt medan tungt arbete körs
Om du sätter ihop dessa delar lämnar filen aldrig enheten. Servern ser den aldrig. Det finns inget att logga, inget att läcka, inget att begära ut.
Vad "klientsidan" faktiskt betyder
Det är värt att vara precis, eftersom marknadstexten för många "privata" verktyg är slarvig.
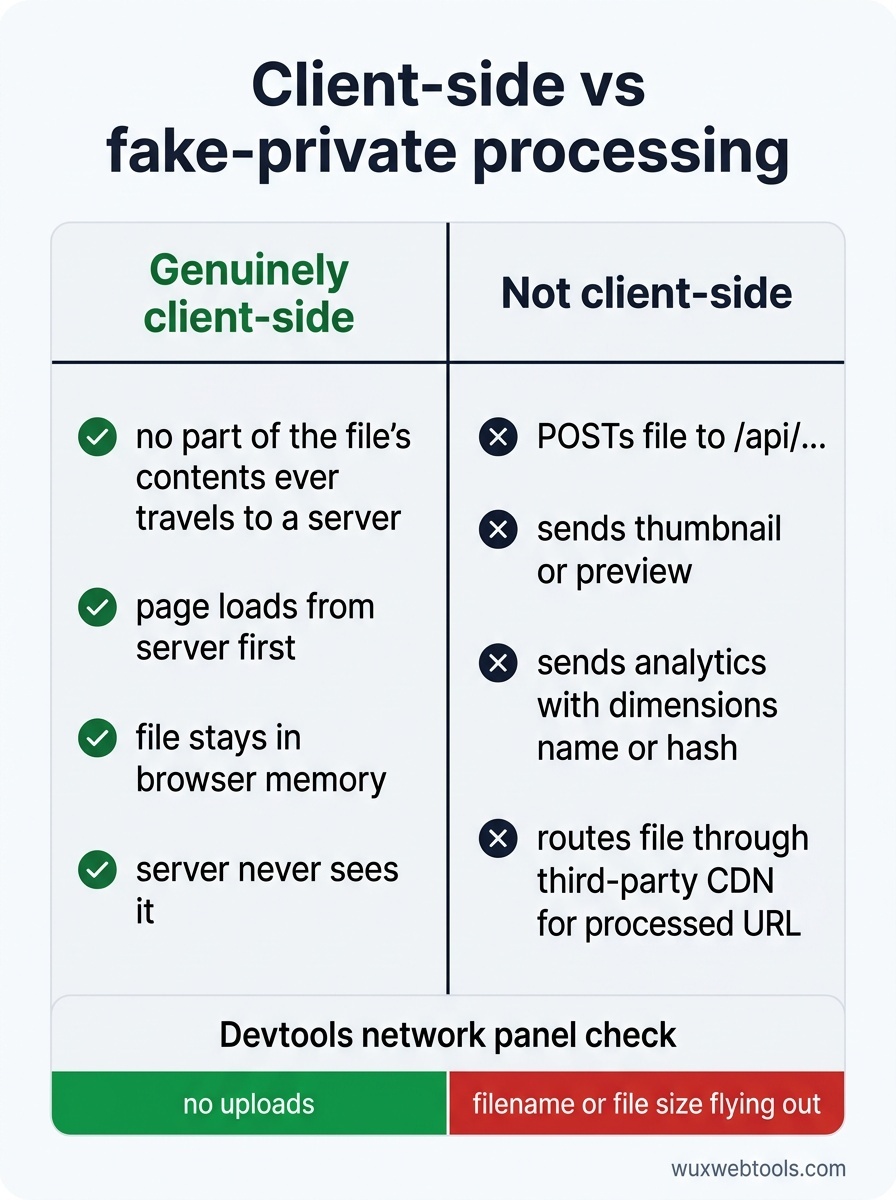
Ett verktyg är verkligen klientbaserat när, efter att sidan har laddats, ingen del av filens innehåll någonsin skickas till en server. Själva sidan laddas från en server (HTML, JavaScript, kanske en WebAssembly-modul). Därefter hamnar din fil i webbläsarens minne och stannar där tills du stänger fliken.
Ett verktyg är inte klientbaserat om det:
- POSTar filen till en
/api/...-endpoint - Skickar en miniatyrbild eller förhandsvisning till en server
- Anropar en analys-endpoint med filmetadata (dimensioner, namn, hash)
- Skickar filen via ett tredjeparts-CDN som returnerar en bearbetad URL
Nätverkspanelen i webbläsarens utvecklarverktyg talar sanning. Öppna den, släpp in en fil och kontrollera vad som laddas upp. Om du ser ditt filnamn eller din filstorlek flyga iväg är verktyget inte så privat som det påstår.
Varför detta spelar roll i praktiken
Tre grupper människor gynnas i det tysta när bildbehandling flyttas in i webbläsaren.
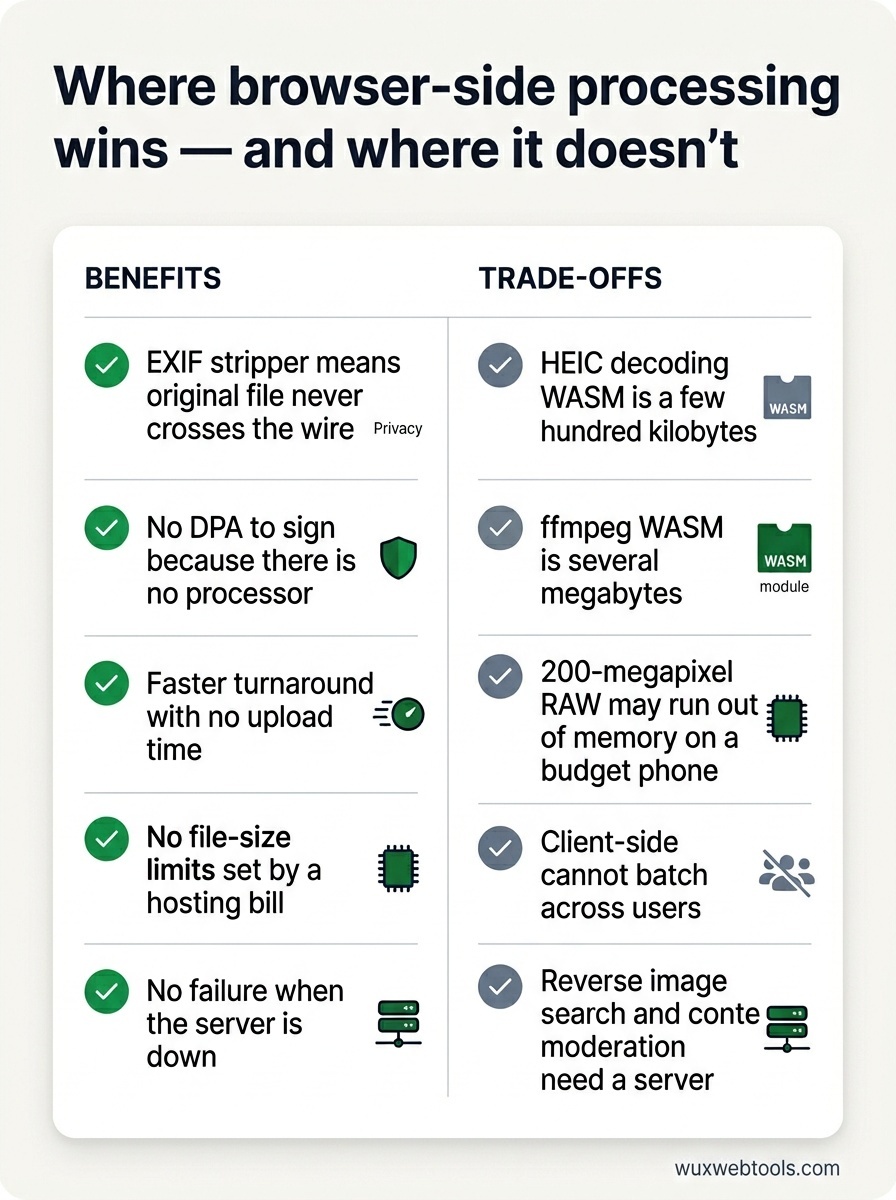
Journalister, aktivister och forskare hanterar källmaterial som kan vara farligt om det läcker. EXIF-metadata kan innehålla GPS-koordinater från enheten som tog fotot. En EXIF-rensare i webbläsaren innebär att originalfilen aldrig skickas över nätet.
Företag under reglering — vård, finans, juridik — skulle annars behöva ett personuppgiftsbiträdesavtal med den som driver verktyget. En statisk sida som gör arbetet lokalt har inget DPA att skriva under, eftersom det inte finns något biträde.
Alla andra får de uppenbara fördelarna: snabbare resultat (ingen uppladdningstid), inga filstorleksgränser satta av en hostingnota, inga avbrott när servern ligger nere.
Var kompromisserna fortfarande finns
Klientsidan är inte magi. Det finns verkliga kostnader som du bör tänka igenom innan du väljer den för ett visst problem.
Kallstarten är tyngre
Ett WebAssembly-paket för HEIC-avkodning är några hundra kilobyte. ffmpeg kompilerat till WASM är flera megabyte. Första besöket betalar den kostnaden. Cache hjälper, och koddelning hjälper ännu mer — ladda bara den codec som användaren faktiskt valde.
Användarens hårdvara sätter taket
En RAW-fil på 200 megapixlar får slut på minne i en budgettelefon långt innan den gör det på en server. Var ärlig i gränssnittet om vad som är realistiskt på enheten.
Du kan inte batcha över användare
Serverbaserad bearbetning kan deduplicera och fördela kostnaden. Om en miljon användare konverterar samma stockbild kan en server bearbeta den en gång. På klientsidan görs det en miljon gånger. För de flesta arbetsflöden i personliga verktyg är det här inget problem — arbetet är ändå unikt — men det är värt att känna till.
Vissa operationer behöver en server
Omvänd bildsökning behöver ett index. Innehållsmoderering behöver en modell som är för stor för att skicka ut. Allt som jämför din fil med en samling du inte äger behöver en backend.
En liten etisk poäng
Om ditt verktyg verkligen är klientbaserat, säg det tydligt och bevisa det. Länka till källkoden, peka på nätverkspanelen, förklara vad som körs var. Formuleringar som "vi lagrar inte dina data" betyder ingenting utan en arkitektur som styrker dem — varje serverbaserat verktyg som någonsin läckt kunddata har också sagt exakt det, och menade det då.
Det omvända gäller också. Om ditt verktyg är serverbaserat, låtsas inte något annat. Användare har lärt sig känna igen mönstret, och förtroendeskadan när de kommer på dig är permanent.
<!-- tool-cta:start -->
💡 Prova detta: Se klientsidesbearbetning i praktiken med Image Compressor, som krymper bilder helt i din webbläsare så att ingenting någonsin laddas upp till en server.
<!-- tool-cta:end -->
Vart du går härifrån
Om du bygger ett litet bildverktyg i dag, välj klientsidan som standard och ta bara till en server när du har ett konkret skäl. Webbläsaren kommer att överraska dig med hur mycket arbete den kan bära — och människorna i andra änden av nätverksanslutningen kommer i det tysta att tacka dig för de byte som aldrig lämnade deras maskin.
Vanliga frågor
Är klientbaserad bearbetning alltid mer privat än serverbaserad?
Varför fungerar inte alla verktyg så här då?
Gör WebAssembly min dator långsammare?
Hur är det med mycket stora filer?
Källor och vidare läsning