Perché elaborare le immagini nel browser è un vantaggio per la privacy
Come le API web moderne permettono di costruire strumenti per immagini davvero privati — e che cosa significa per le persone che li usano.
 The Wux Webtools Team
4 minuti di lettura
Indice
- L’aspettativa predefinita è sbagliata
- Che cosa significa davvero "lato client"
- Perché questo conta nella pratica
- Dove restano i compromessi
- L’avvio a freddo è più pesante
- L’hardware dell’utente stabilisce il limite
- Non puoi fare batching tra utenti
- Alcune operazioni richiedono un server
- Un piccolo punto etico
- Da dove continuare
L’aspettativa predefinita è sbagliata
Per gran parte degli ultimi vent’anni, fare qualcosa di non banale con un’immagine sul web significava caricarla su un server. Convertire una foto HEIC, rimuovere i suoi metadati EXIF, generare una favicon — storicamente ognuno di questi strumenti viveva dietro un modulo multipart. L’utente cliccava su upload, il file attraversava l’internet pubblico e un server, da qualche parte, faceva il lavoro.
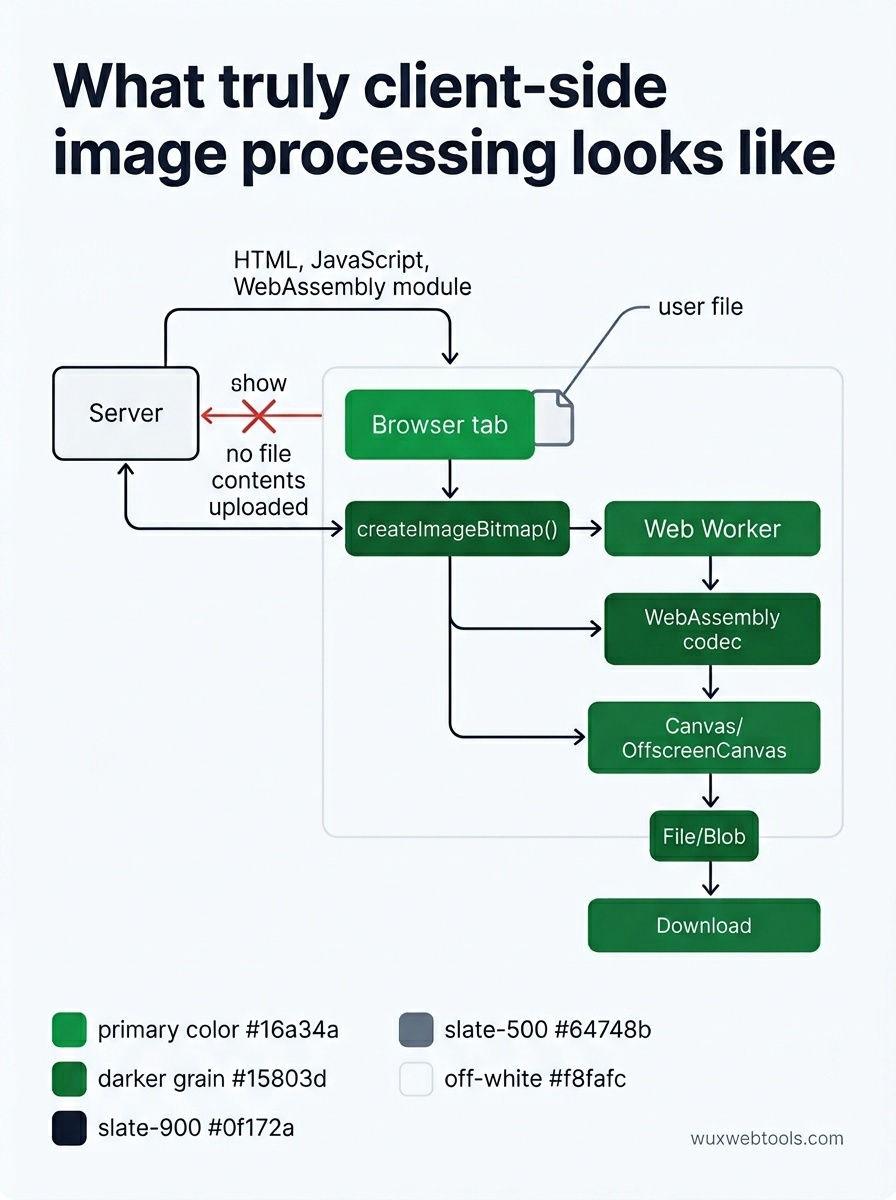
Quel comportamento predefinito non è più tecnicamente necessario. I browser dispongono da anni di API che permettono all’intera pipeline di funzionare in locale:
<canvas>andOffscreenCanvasper il lavoro a livello di pixelcreateImageBitmap()per una decodifica rapida, fuori dal thread principaleFileandBlobper leggere i caricamenti senza inviarli da nessuna parte- WebAssembly per librerie come libheif, libwebp e ffmpeg
- Web Workers per mantenere l’interfaccia reattiva mentre vengono eseguite operazioni pesanti
Se metti insieme questi elementi, il file non lascia mai il dispositivo. Il server non lo vede mai. Non c’è nulla da registrare, nulla da far trapelare, nulla da produrre su ordine dell’autorità.
Che cosa significa davvero "lato client"
Vale la pena essere precisi, perché il linguaggio promozionale di molti strumenti "privati" è approssimativo.
Uno strumento è davvero lato client quando, dopo il caricamento della pagina, nessuna parte del contenuto del file viaggia mai verso un server. La pagina stessa viene caricata da un server (HTML, JavaScript, forse un modulo WebAssembly). Dopo quel momento, il file entra nella memoria del browser e resta lì finché non chiudi la scheda.
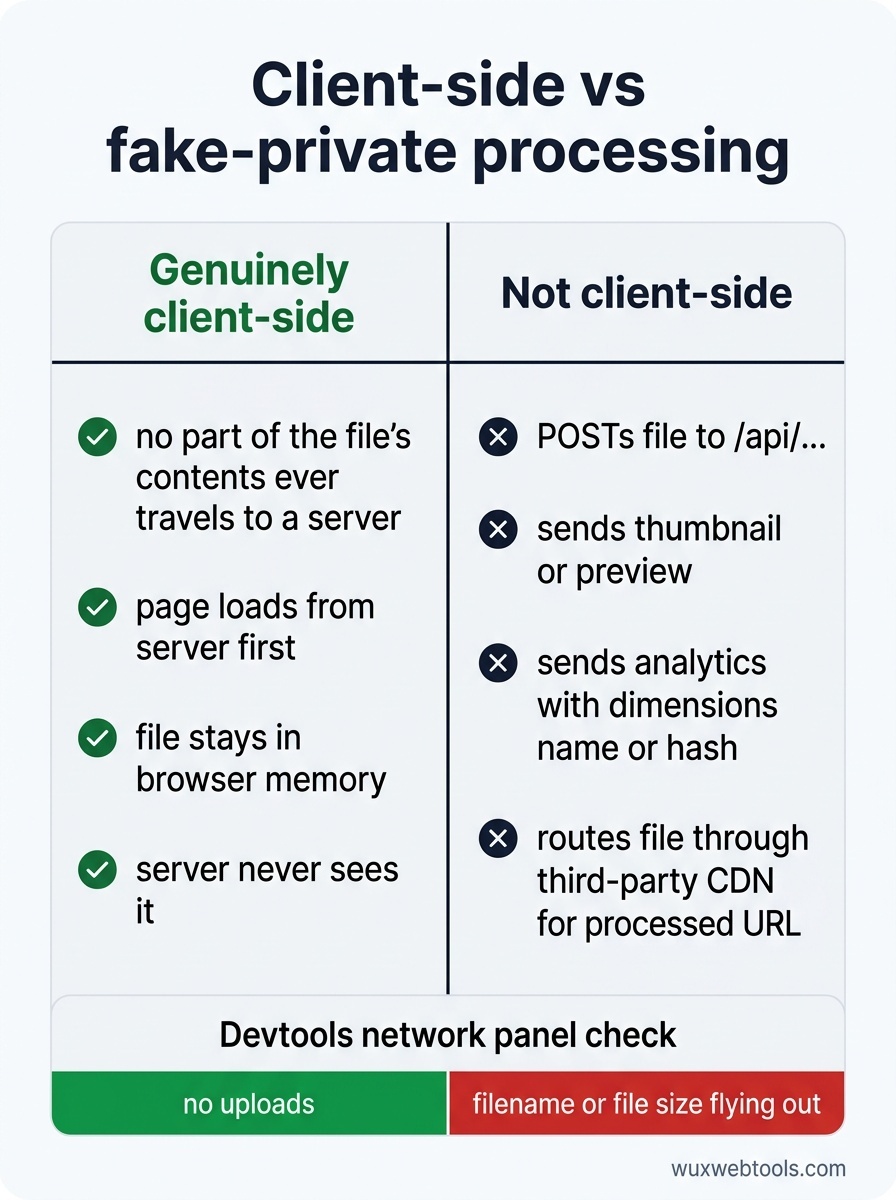
Uno strumento non è lato client se:
- esegue POST del file verso un endpoint
/api/... - invia a un server una miniatura o un’anteprima
- chiama un endpoint di analytics con metadati del file (dimensioni, nome, hash)
- instrada il file attraverso una CDN di terze parti che restituisce un URL elaborato
Il pannello di rete nei devtools del browser è quello che dice la verità. Aprilo, trascina dentro un file e controlla che cosa viene caricato. Se vedi il nome del file o la dimensione del file uscire verso l’esterno, lo strumento non è privato quanto dichiara.
Perché questo conta nella pratica
Tre gruppi di persone traggono benefici silenziosi quando l’elaborazione delle immagini si sposta nel browser.
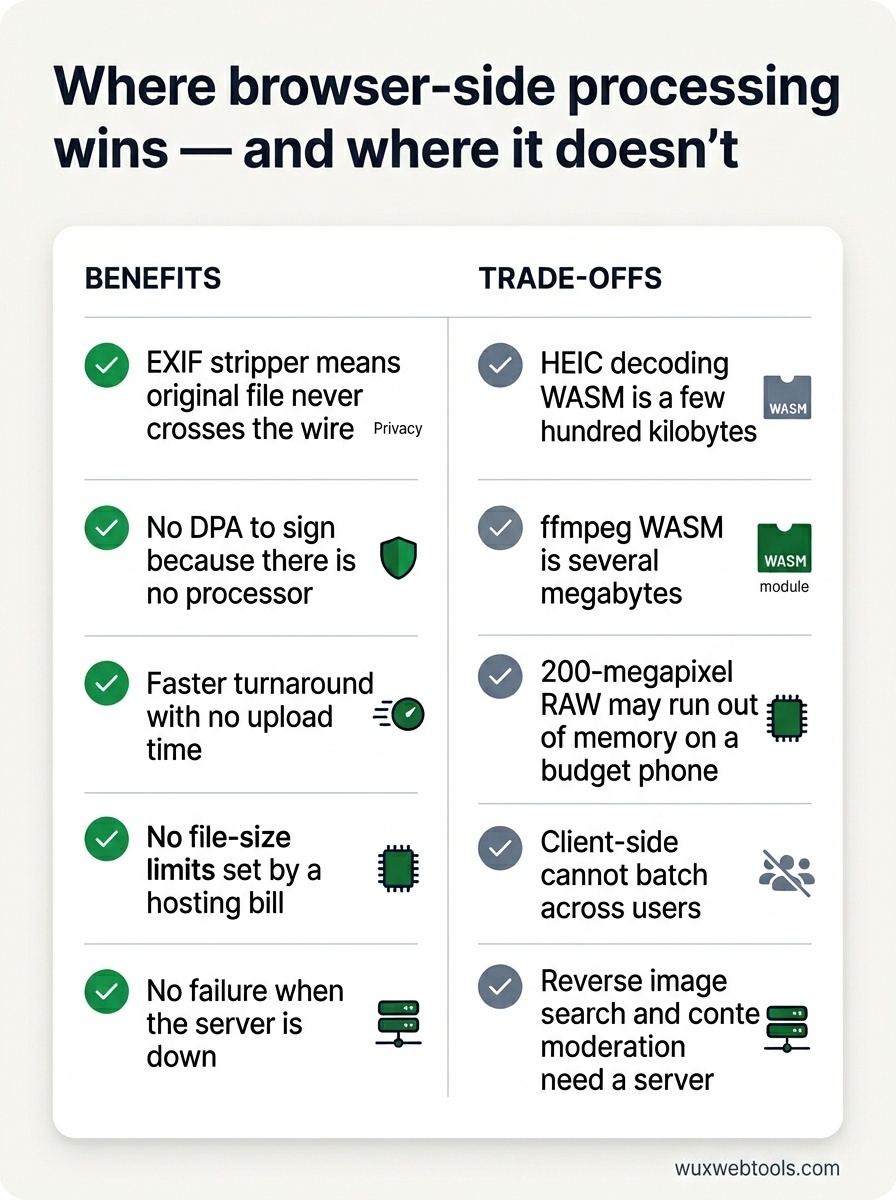
Giornalisti, attivisti e ricercatori gestiscono materiali di origine che sarebbero pericolosi se trapelassero. I metadati EXIF possono includere le coordinate GPS del dispositivo che ha scattato la foto. Uno strumento per rimuovere EXIF lato browser significa che il file originale non attraversa mai la rete.
Aziende soggette a regolamentazione — sanità, finanza, ambito legale — altrimenti avrebbero bisogno di un accordo sul trattamento dei dati con chi gestisce lo strumento. Una pagina statica che svolge il lavoro in locale non richiede alcun DPA da firmare, perché non c’è alcun responsabile del trattamento.
Tutti gli altri ottengono i vantaggi più evidenti: tempi più rapidi (nessun tempo di upload), nessun limite di dimensione imposto dai costi di hosting, nessun errore quando il server non è disponibile.
Dove restano i compromessi
Il lato client non è magia. Ci sono costi reali da valutare prima di sceglierlo per un determinato problema.
L’avvio a freddo è più pesante
Un bundle WebAssembly per decodificare HEIC pesa qualche centinaio di kilobyte. ffmpeg compilato in WASM pesa diversi megabyte. La prima visita paga quel costo. La cache aiuta, e il code-splitting aiuta ancora di più — carica solo il codec che l’utente ha effettivamente scelto.
L’hardware dell’utente stabilisce il limite
Un file RAW da 200 megapixel esaurirà la memoria su un telefono economico molto prima di farlo su un server. Sii trasparente nell’interfaccia su ciò che è realistico per il dispositivo.
Non puoi fare batching tra utenti
L’elaborazione lato server può deduplicare e ammortizzare. Se un milione di utenti converte la stessa immagine stock, un server può elaborarla una sola volta. Lato client, lo fa un milione di volte. Per la maggior parte dei carichi di lavoro degli strumenti personali va bene — il lavoro è comunque unico — ma vale la pena saperlo.
Alcune operazioni richiedono un server
La ricerca inversa per immagini richiede un indice. La moderazione dei contenuti richiede un modello troppo grande da distribuire. Qualunque cosa confronti il tuo file con un corpus che non possiedi richiede un backend.
Un piccolo punto etico
Se il tuo strumento è davvero lato client, dillo chiaramente e dimostralo. Collega il codice sorgente, indica il pannello di rete, spiega che cosa viene eseguito e dove. Frasi come "non archiviamo i tuoi dati" non significano nulla senza un’architettura che le sostenga — ogni strumento lato server che abbia mai fatto trapelare dati dei clienti diceva esattamente la stessa cosa, e in quel momento lo intendeva davvero.
Vale anche l’inverso. Se il tuo strumento è lato server, non fingere il contrario. Gli utenti hanno imparato a riconoscere lo schema, e il colpo alla fiducia quando ti scoprono è permanente.
<!-- tool-cta:start -->
💡 Prova questo: Guarda l'elaborazione lato client in azione con Image Compressor, che riduce le immagini interamente nel tuo browser così nulla viene mai caricato su un server.
<!-- tool-cta:end -->
Da dove continuare
Se oggi stai costruendo una piccola utility per immagini, parti dal lato client e ricorri a un server solo quando hai una ragione concreta. Il browser ti sorprenderà per quanto lavoro riesce a sostenere — e le persone dall’altra parte della connessione di rete ti ringrazieranno silenziosamente per i byte che non hanno mai lasciato la loro macchina.
Domande frequenti
L’elaborazione lato client è sempre più privata di quella lato server?
Allora perché non tutti gli strumenti funzionano così?
WebAssembly rallenta il mio computer?
E i file molto grandi?
Fonti e letture ulteriori