为什么在浏览器中处理图像有助于保护隐私
现代 Web API 如何让你构建真正私密的图像工具——以及这对使用者意味着什么。
 The Wux Webtools Team
4 分钟阅读
默认预期是错的
在过去二十年的大部分时间里,在 Web 上对图像做任何稍微复杂的事情,都意味着要把它上传到服务器。转换一张 HEIC 照片、移除它的 EXIF 元数据、生成一个 favicon——这些工具在历史上几乎都藏在 multipart 表单后面。用户点击 upload,文件穿过公共互联网,然后某处的一台服务器完成处理。
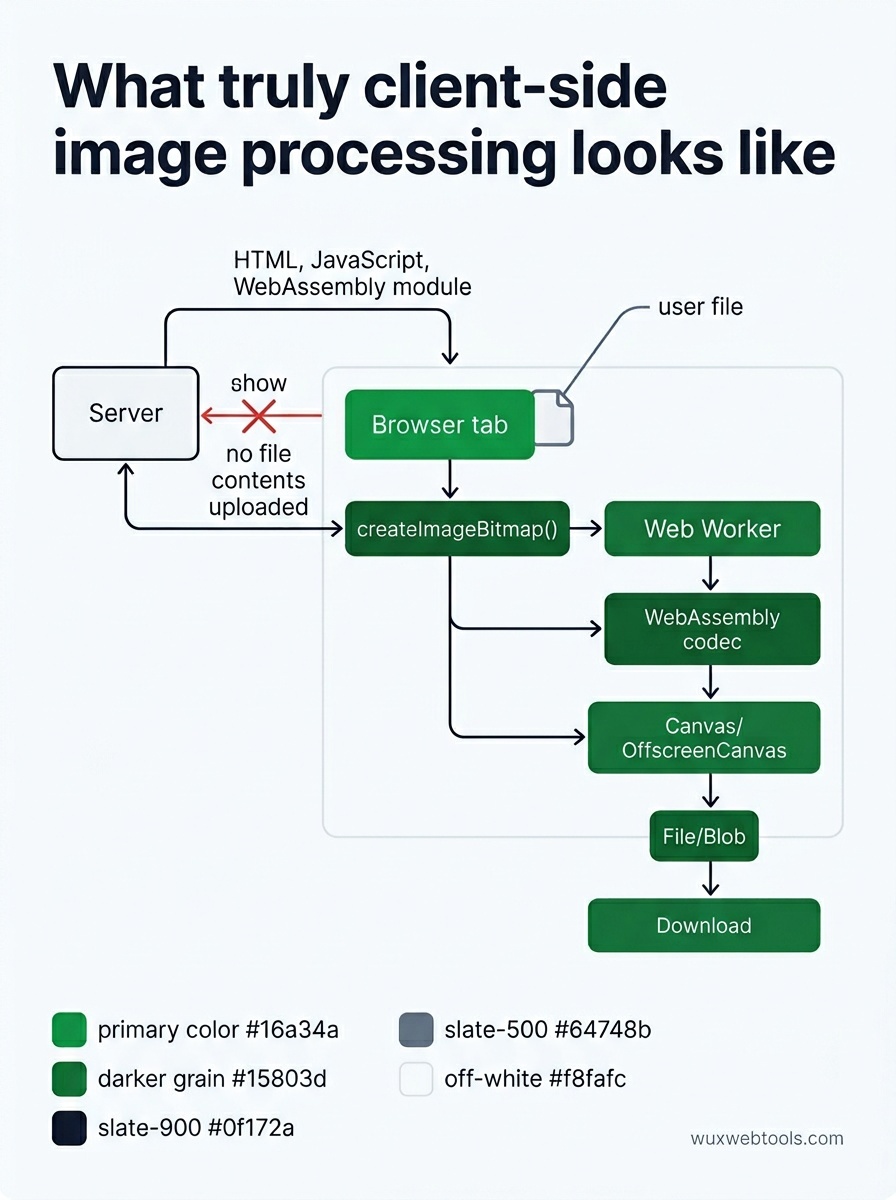
这种默认做法在技术上已经不再必要。多年前,浏览器就已经提供了一些 API,可以让整个流程在本地运行:
<canvas>andOffscreenCanvas用于像素级处理createImageBitmap()用于快速、脱离主线程的解码FileandBlob用于在不发送到任何地方的情况下读取上传文件- WebAssembly 用于 libheif、libwebp 和 ffmpeg 等库
- Web Workers 用于在重型任务运行时保持 UI 响应
如果把这些能力组合起来,文件就永远不会离开设备。服务器永远看不到它。没有可记录的内容,没有可泄露的内容,也没有可被传唤调取的内容。
“客户端”到底是什么意思
这一点值得说清楚,因为很多“私密”工具的营销文案都很含糊。
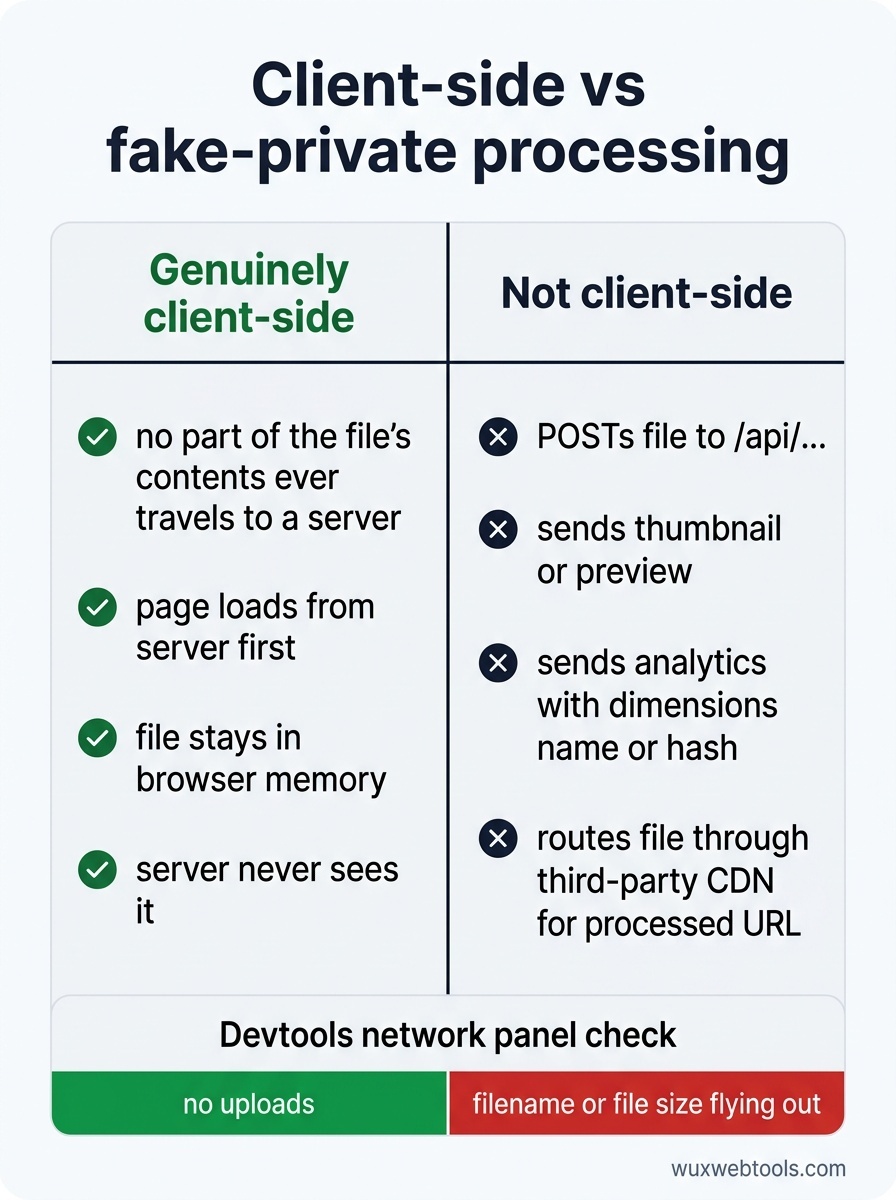
一个工具真正属于客户端处理,是指在页面加载完成后,文件内容的任何部分都不会传输到服务器。页面本身会从服务器加载(HTML、JavaScript,也许还有一个 WebAssembly 模块)。之后,你的文件进入浏览器内存,并一直留在那里,直到你关闭标签页。
如果一个工具做了以下事情,它就不是客户端处理:
- 将文件 POST 到某个
/api/...端点 - 将缩略图或预览图发送到服务器
- 调用分析端点并携带文件元数据(尺寸、名称、哈希)
- 通过第三方 CDN 中转文件,并返回一个处理后的 URL
浏览器 devtools 中的 network panel 才是真相。打开它,拖入一个文件,然后检查有哪些内容被上传了。如果你看到文件名或文件大小被发送出去,这个工具就没有它声称的那么私密。
为什么这在实践中很重要
当图像处理转移到浏览器中时,有三类人会在无声中受益。
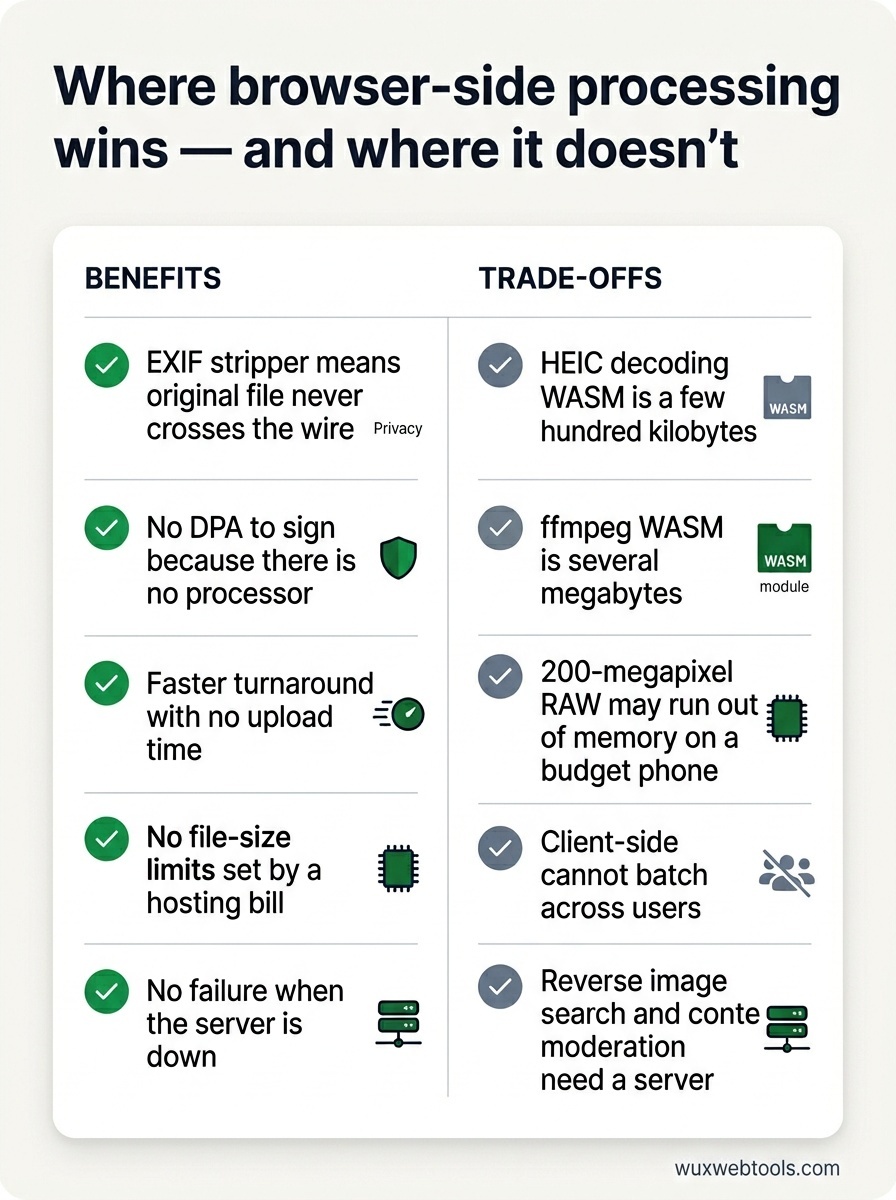
记者、活动人士和研究人员会处理一旦泄露就可能带来危险的源材料。EXIF 元数据可能包含拍摄照片设备的 GPS 坐标。浏览器端的 EXIF 移除工具意味着原始文件永远不会经过网络传输。
受监管的公司——医疗、金融、法律等行业——否则通常需要与工具运营方签署数据处理协议。一个在本地完成工作的静态页面不需要签署 DPA,因为根本不存在处理方。
其他所有人则得到显而易见的好处:周转更快(无需上传时间)、不受托管账单设定的文件大小限制、服务器宕机时也不会失败。
取舍仍然存在于哪里
客户端处理并不是魔法。在为某个具体问题选择它之前,有一些真实成本值得认真考虑。
冷启动更重
用于 HEIC 解码的 WebAssembly 包有几百 KB。编译为 WASM 的 ffmpeg 则有数 MB。首次访问需要支付这部分成本。缓存会有所帮助,代码拆分帮助更大——只加载用户实际选择的编解码器。
用户硬件决定上限
一张 2 亿像素的 RAW 文件,在一部入门级手机上会远早于服务器耗尽内存。UI 应该诚实地说明在当前设备上什么是现实可行的。
无法跨用户批处理
服务器端处理可以去重并摊销成本。如果一百万个用户转换同一张素材图,服务器可以只处理一次。客户端处理则会做一百万次。对于大多数个人工具的工作负载来说,这没有问题——工作本来就是独一份的——但这一点值得知道。
有些操作需要服务器
反向图像搜索需要索引。内容审核需要一个过大而无法下发的模型。任何需要将你的文件与一个你并不拥有的语料库进行比较的事情,都需要后端。
一个小小的伦理点
如果你的工具确实是客户端处理,就大声说明并证明它。链接到源码,指向 network panel,解释什么在哪里运行。像“我们不会存储你的数据”这样的说法,如果没有架构支撑,就没有意义——每一个曾经泄露客户数据的服务器端工具也都说过完全一样的话,而且当时也是真心的。
反过来也成立。如果你的工具是服务器端处理,就不要假装不是。用户已经开始识别这种模式;一旦他们发现你在误导他们,信任损失就是永久的。
<!-- tool-cta:start -->
💡 试试这个: 使用 Image Compressor 查看客户端处理的实际效果,它完全在你的浏览器中缩小图片,因此永远不会有任何内容上传到服务器。
<!-- tool-cta:end -->
接下来该怎么做
如果你今天要构建一个小型图像工具,应默认选择客户端处理,只有在有具体理由时才引入服务器。浏览器能承担的工作会超出你的预期——而网络连接另一端的人,也会默默感谢那些从未离开他们机器的字节。
常见问题
客户端处理是否总是比服务器端处理更私密?
那为什么不是所有工具都这样工作?
WebAssembly 会拖慢我的电脑吗?
非常大的文件怎么办?
来源与进一步阅读