De ce procesarea imaginilor în browser este un câștig pentru confidențialitate
Cum îți permit API-urile web moderne să construiești instrumente pentru imagini cu adevărat private — și ce înseamnă asta pentru oamenii care le folosesc.
 The Wux Webtools Team
5 min citire
Cuprins
- Așteptarea implicită este greșită
- Ce înseamnă de fapt "client-side"
- De ce contează asta în practică
- Unde rămân compromisurile
- Pornirea la rece este mai grea
- Hardware-ul utilizatorului stabilește plafonul
- Nu poți face batch între utilizatori
- Unele operațiuni au nevoie de un server
- Un mic punct etic
- Încotro de aici
Așteptarea implicită este greșită
În cea mai mare parte a ultimilor douăzeci de ani, a face ceva non-trivial cu o imagine pe web însemna să o încarci pe un server. Să convertești o fotografie HEIC, să-i elimini metadatele EXIF, să generezi un favicon — toate aceste instrumente au stat, istoric, în spatele unui formular multipart. Utilizatorul făcea clic pe upload, fișierul călătorea prin internetul public, iar un server, undeva, făcea treaba.
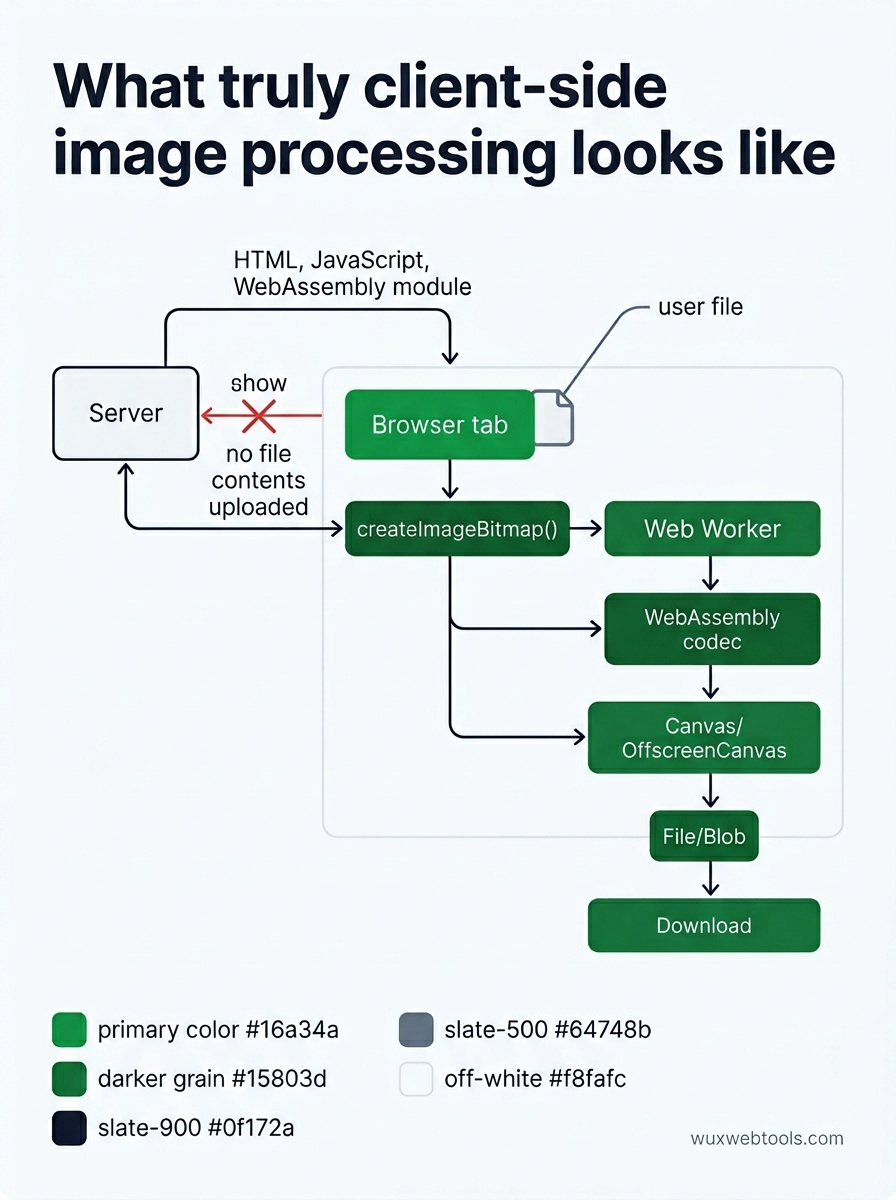
Această abordare implicită nu mai este necesară din punct de vedere tehnic. Browserele au livrat de ani buni API-uri care fac ca întregul flux să ruleze local:
<canvas>andOffscreenCanvasfor pixel-level workcreateImageBitmap()for fast, off-thread decodingFileandBlobfor reading uploads without sending them anywhere- WebAssembly for libraries like libheif, libwebp and ffmpeg
- Web Workers to keep the UI responsive while heavy work runs
Dacă le pui împreună, fișierul nu părăsește niciodată dispozitivul. Serverul nu îl vede niciodată. Nu există nimic de jurnalizat, nimic de scurs, nimic de citat într-o citație judiciară.
Ce înseamnă de fapt "client-side"
Merită să fim preciși, pentru că textele de marketing ale multor instrumente „private” sunt vagi.
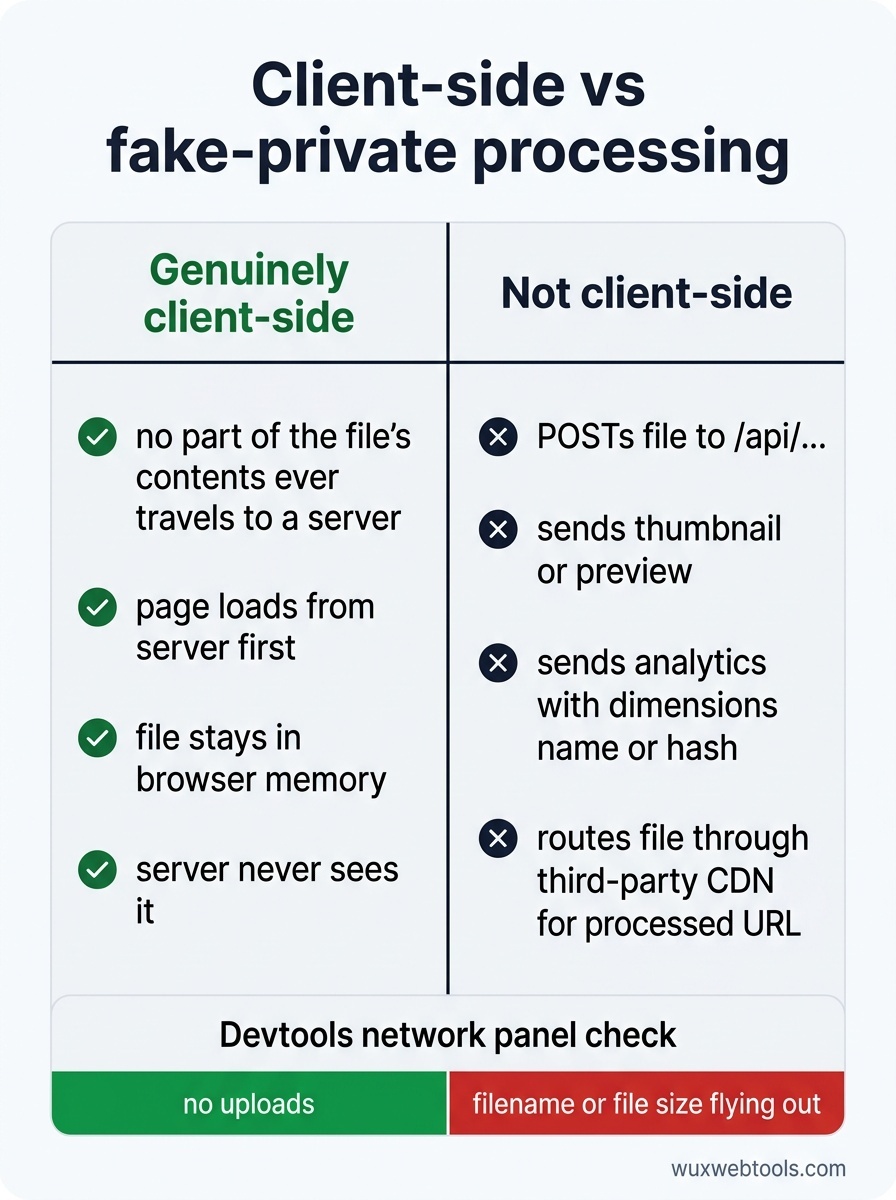
Un instrument este cu adevărat client-side atunci când, după ce pagina s-a încărcat, nicio parte din conținutul fișierului nu călătorește vreodată către un server. Pagina însăși se încarcă de pe un server (HTML, JavaScript, poate un modul WebAssembly). După aceea, fișierul tău intră în memoria browserului și rămâne acolo până închizi fila.
Un instrument nu este client-side dacă:
- Trimite fișierul prin POST către un endpoint
/api/... - Trimite o miniatură sau o previzualizare către un server
- Apelează un endpoint de analytics cu metadatele fișierului (dimensiuni, nume, hash)
- Rutează fișierul printr-un CDN terț care returnează un URL procesat
Panoul de rețea din devtools-ul browserului este cel care spune adevărul. Deschide-l, adaugă un fișier și verifică ce se încarcă. Dacă îți vezi numele fișierului sau dimensiunea fișierului plecând, instrumentul nu este atât de privat pe cât pretinde.
De ce contează asta în practică
Trei grupuri de oameni beneficiază discret atunci când procesarea imaginilor se mută în browser.
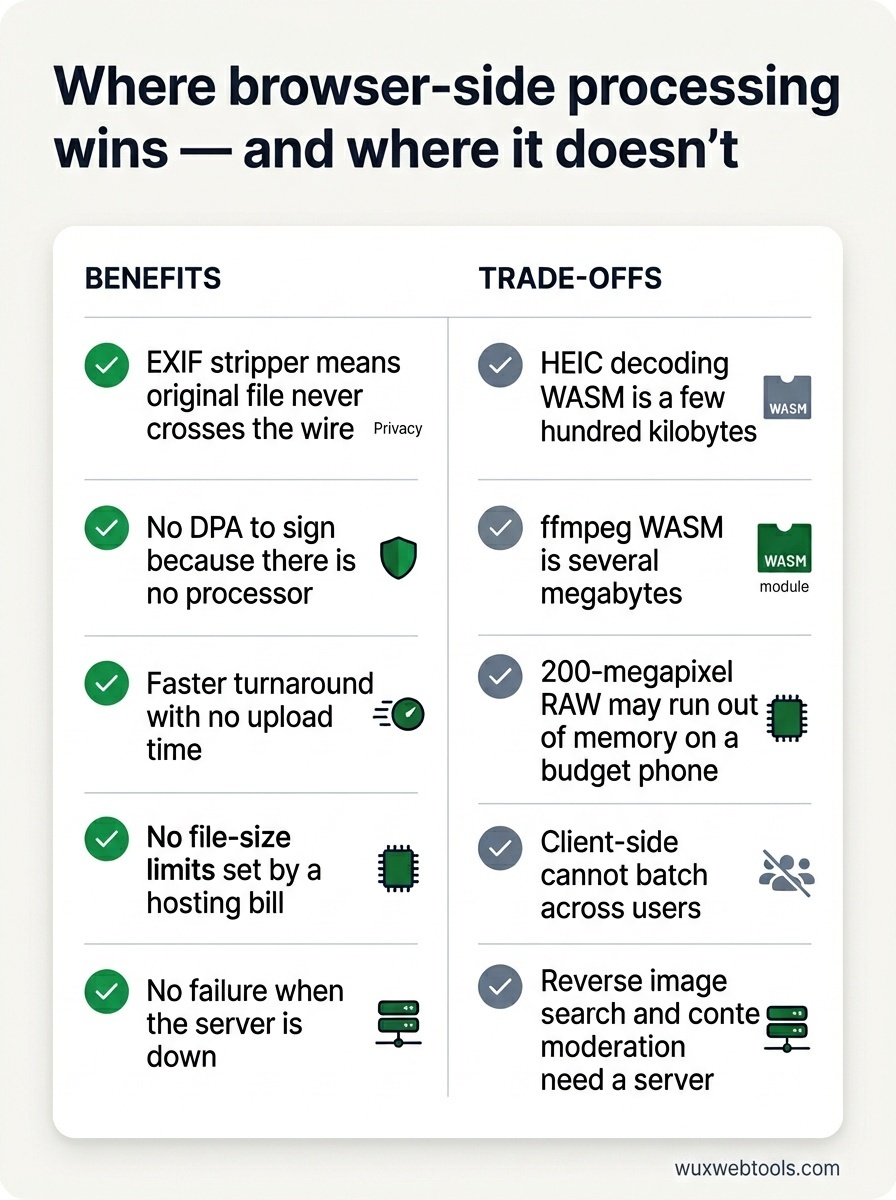
Jurnaliștii, activiștii și cercetătorii lucrează cu materiale-sursă care ar fi periculoase dacă s-ar scurge. Metadatele EXIF pot include coordonate GPS de pe dispozitivul care a făcut fotografia. Un instrument de eliminare EXIF în browser înseamnă că fișierul original nu traversează niciodată rețeaua.
Companiile supuse reglementărilor — sănătate, finanțe, juridic — ar avea altfel nevoie de un acord de prelucrare a datelor cu cine administrează instrumentul. O pagină statică ce face munca local nu are niciun DPA de semnat, pentru că nu există niciun procesator.
Toți ceilalți primesc beneficiile evidente: timp de răspuns mai rapid (fără timp de încărcare), fără limite de dimensiune a fișierelor impuse de o factură de hosting, fără eșec atunci când serverul este căzut.
Unde rămân compromisurile
Client-side nu este magie. Există costuri reale la care ar trebui să te gândești înainte să îl alegi pentru o anumită problemă.
Pornirea la rece este mai grea
Un pachet WebAssembly pentru decodarea HEIC are câteva sute de kilobyți. ffmpeg compilat în WASM are câțiva megabytes. Prima vizită plătește acest cost. Caching-ul ajută, iar code-splitting ajută și mai mult — încarcă doar codecul pe care utilizatorul chiar l-a ales.
Hardware-ul utilizatorului stabilește plafonul
Un fișier RAW de 200 de megapixeli va rămâne fără memorie pe un telefon ieftin cu mult înainte să rămână fără memorie pe un server. Fii sincer în UI cu privire la ce este realist pe dispozitiv.
Nu poți face batch între utilizatori
Procesarea server-side poate deduplica și amortiza. Dacă un milion de utilizatori convertesc aceeași imagine stock, un server o poate procesa o singură dată. Client-side o face de un milion de ori. Pentru majoritatea sarcinilor din instrumente personale, acest lucru este în regulă — oricum munca este unică — dar merită știut.
Unele operațiuni au nevoie de un server
Căutarea inversă de imagini are nevoie de un index. Moderarea conținutului are nevoie de un model prea mare pentru a fi livrat. Orice compară fișierul tău cu un corpus pe care nu îl deții are nevoie de un backend.
Un mic punct etic
Dacă instrumentul tău chiar este client-side, spune asta clar și dovedește-o. Leagă către sursă, indică panoul de rețea, explică ce rulează unde. Formulări precum „nu îți stocăm datele” nu înseamnă nimic fără o arhitectură care să le susțină — fiecare instrument server-side care a scurs vreodată datele clienților a spus exact același lucru și a crezut asta la momentul respectiv.
Și inversul este valabil. Dacă instrumentul tău este server-side, nu pretinde altceva. Utilizatorii au ajuns să recunoască tiparul, iar lovitura de încredere atunci când te prind este permanentă.
<!-- tool-cta:start -->
💡 Încearcă asta: Vezi procesarea pe partea clientului în acțiune cu Image Compressor, care micșorează imaginile complet în browserul tău, astfel încât nimic nu este încărcat vreodată pe un server.
<!-- tool-cta:end -->
Încotro de aici
Dacă construiești astăzi un mic utilitar pentru imagini, pornește implicit de la client-side și apelează la un server doar când ai un motiv concret. Browserul te va surprinde prin cât de departe poate duce munca — iar oamenii de la celălalt capăt al conexiunii de rețea îți vor mulțumi discret pentru bytes care nu le-au părăsit niciodată mașina.
Întrebări frecvente
Procesarea client-side este întotdeauna mai privată decât cea server-side?
Atunci de ce nu funcționează toate instrumentele așa?
Îmi încetinește WebAssembly computerul?
Ce se întâmplă cu fișierele foarte mari?
Surse și lecturi suplimentare