Чому обробка зображень у браузері — це виграш для приватності
Як сучасні веб-API дають змогу створювати справді приватні інструменти для зображень — і що це означає для людей, які ними користуються.
 The Wux Webtools Team
1 хв читання
Зміст
- Типове очікування хибне
- Що насправді означає "client-side"
- Чому це важливо на практиці
- Де все ще залишаються компроміси
- Холодний старт важчий
- Стелю задає обладнання користувача
- Ви не можете пакетно обробляти між користувачами
- Деякі операції потребують сервера
- Невеликий етичний момент
- Куди рухатися далі
Типове очікування хибне
Протягом більшої частини останніх двадцяти років будь-яка нетривіальна робота із зображенням у вебі означала завантаження його на сервер. Конвертувати фото HEIC, видалити його метадані EXIF, згенерувати favicon — історично кожен із таких інструментів існував за multipart-формою. Користувач натискав upload, файл мандрував публічним інтернетом, а десь сервер виконував роботу.
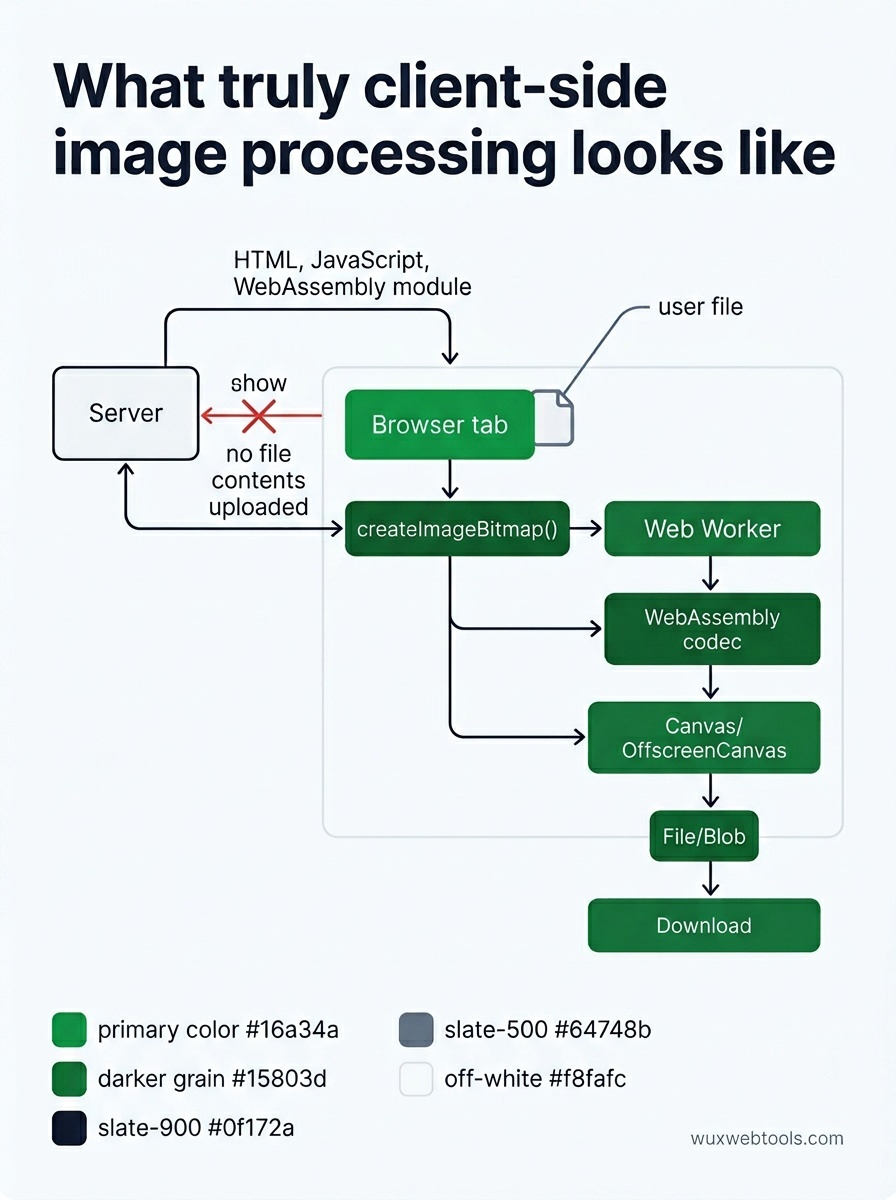
Технічно така модель більше не є необхідною. Браузери вже багато років постачають API, які дають змогу виконувати весь конвеєр локально:
<canvas>andOffscreenCanvasдля роботи на рівні пікселівcreateImageBitmap()для швидкого декодування поза основним потокомFileandBlobдля читання завантажених файлів без надсилання їх будь-куди- WebAssembly для бібліотек на кшталт libheif, libwebp і ffmpeg
- Web Workers щоб інтерфейс залишався чуйним під час важкої роботи
Якщо поєднати ці частини, файл ніколи не залишає пристрій. Сервер його ніколи не бачить. Немає чого записувати в логи, нічому витікати, нічого витребовувати повісткою.
Що насправді означає "client-side"
Тут варто бути точними, бо маркетингові тексти багатьох "приватних" інструментів доволі розмиті.
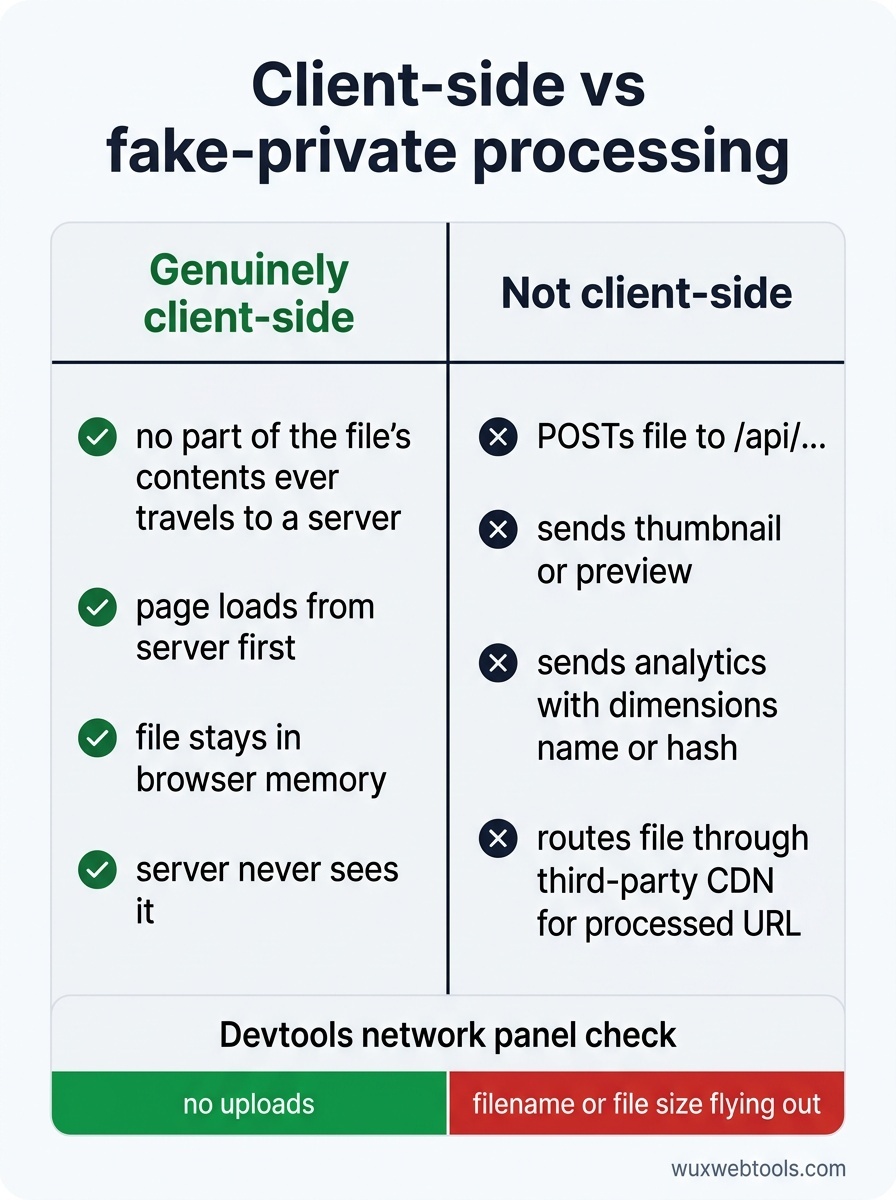
Інструмент справді працює на боці клієнта, коли після завантаження сторінки жодна частина вмісту файлу ніколи не передається на сервер. Сама сторінка завантажується із сервера (HTML, JavaScript, можливо, модуль WebAssembly). Після цього ваш файл потрапляє в пам’ять браузера й залишається там, доки ви не закриєте вкладку.
Інструмент не є клієнтським, якщо він:
- надсилає файл POST-запитом на endpoint
/api/... - надсилає мініатюру або попередній перегляд на сервер
- викликає аналітичний endpoint із метаданими файлу (розміри, назва, hash)
- пропускає файл через сторонній CDN, який повертає оброблений URL
Панель мережі в devtools вашого браузера — це детектор правди. Відкрийте її, перетягніть файл і перевірте, що саме завантажується назовні. Якщо ви бачите, як назва вашого файлу або його розмір вилітають у мережу, інструмент не такий приватний, як стверджує.
Чому це важливо на практиці
Коли обробка зображень переходить у браузер, від цього непомітно виграють три групи людей.
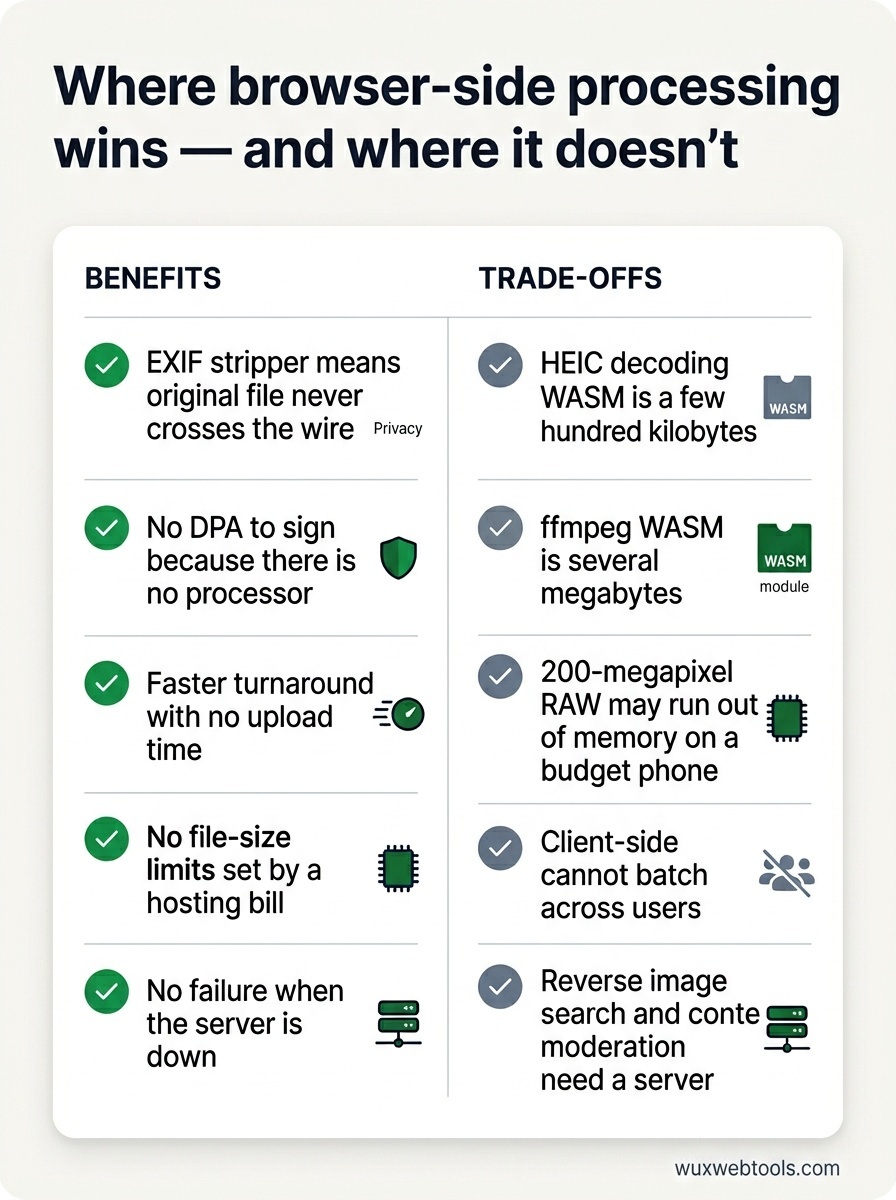
Журналісти, активісти та дослідники працюють із вихідними матеріалами, витік яких міг би бути небезпечним. Метадані EXIF можуть містити GPS-координати пристрою, яким зроблено фото. Засіб видалення EXIF у браузері означає, що оригінальний файл ніколи не перетинає мережу.
Компанії під регуляторними вимогами — охорона здоров’я, фінанси, право — інакше потребували б угоди про обробку даних із тим, хто керує інструментом. Статична сторінка, яка виконує роботу локально, не потребує DPA, бо немає процесора даних.
Усі інші отримують очевидні переваги: швидший результат (немає часу на upload), немає обмежень розміру файлу, продиктованих рахунком за хостинг, немає збою, коли сервер недоступний.
Де все ще залишаються компроміси
Обробка на боці клієнта — не магія. Є реальні витрати, які варто продумати, перш ніж обирати її для конкретної задачі.
Холодний старт важчий
Bundle WebAssembly для декодування HEIC важить кілька сотень кілобайтів. ffmpeg, скомпільований у WASM, — кілька мегабайтів. Перший візит оплачує цю ціну. Кешування допомагає, а code-splitting допомагає ще більше — завантажуйте лише той codec, який користувач справді вибрав.
Стелю задає обладнання користувача
200-мегапіксельний RAW-файл вичерпає пам’ять на бюджетному телефоні значно раніше, ніж на сервері. Будьте чесними в інтерфейсі щодо того, що реалістично для цього пристрою.
Ви не можете пакетно обробляти між користувачами
Серверна обробка може дедуплікувати й амортизувати витрати. Якщо мільйон користувачів конвертує одне й те саме стокове зображення, сервер може обробити його один раз. На боці клієнта це станеться мільйон разів. Для більшості навантажень персональних інструментів це нормально — робота все одно унікальна, — але про це варто знати.
Деякі операції потребують сервера
Зворотний пошук зображень потребує індексу. Модерація контенту потребує моделі, надто великої, щоб її постачати користувачу. Усе, що порівнює ваш файл із корпусом, яким ви не володієте, потребує backend.
Невеликий етичний момент
Якщо ваш інструмент справді працює на боці клієнта, скажіть про це голосно й доведіть це. Дайте посилання на source, вкажіть на панель мережі, поясніть, що де виконується. Фрази на кшталт "we don't store your data" нічого не означають без архітектури, яка це підтверджує, — кожен серверний інструмент, з якого колись витекли дані клієнтів, теж казав саме це і на той момент щиро це мав на увазі.
Зворотне також справедливе. Якщо ваш інструмент є серверним, не вдавайте інакше. Користувачі вже навчилися розпізнавати цей патерн, а удар по довірі, коли вони вас викриють, буде незворотним.
<!-- tool-cta:start -->
💡 Спробуйте це: Подивіться на клієнтську обробку в дії з Image Compressor, який зменшує зображення повністю у вашому браузері, тож нічого ніколи не завантажується на сервер.
<!-- tool-cta:end -->
Куди рухатися далі
Якщо сьогодні ви створюєте невелику утиліту для зображень, за замовчуванням обирайте роботу на боці клієнта й звертайтеся до сервера лише тоді, коли маєте конкретну причину. Браузер здивує вас тим, як багато роботи він здатен взяти на себе, — а люди на іншому кінці мережевого з’єднання мовчки подякують вам за байти, які так і не залишили їхній комп’ютер.
Часто задавані питання
Чи завжди обробка на боці клієнта приватніша за серверну?
Чому тоді не всі інструменти працюють саме так?
Чи WebAssembly сповільнює мій комп’ютер?
А як щодо дуже великих файлів?
Джерела та подальше читання