Pourquoi le traitement des images dans le navigateur est un gain pour la confidentialité
Comment les API web modernes permettent de créer des outils d’image réellement privés — et ce que cela signifie pour les personnes qui les utilisent.
 The Wux Webtools Team
5 min de lecture
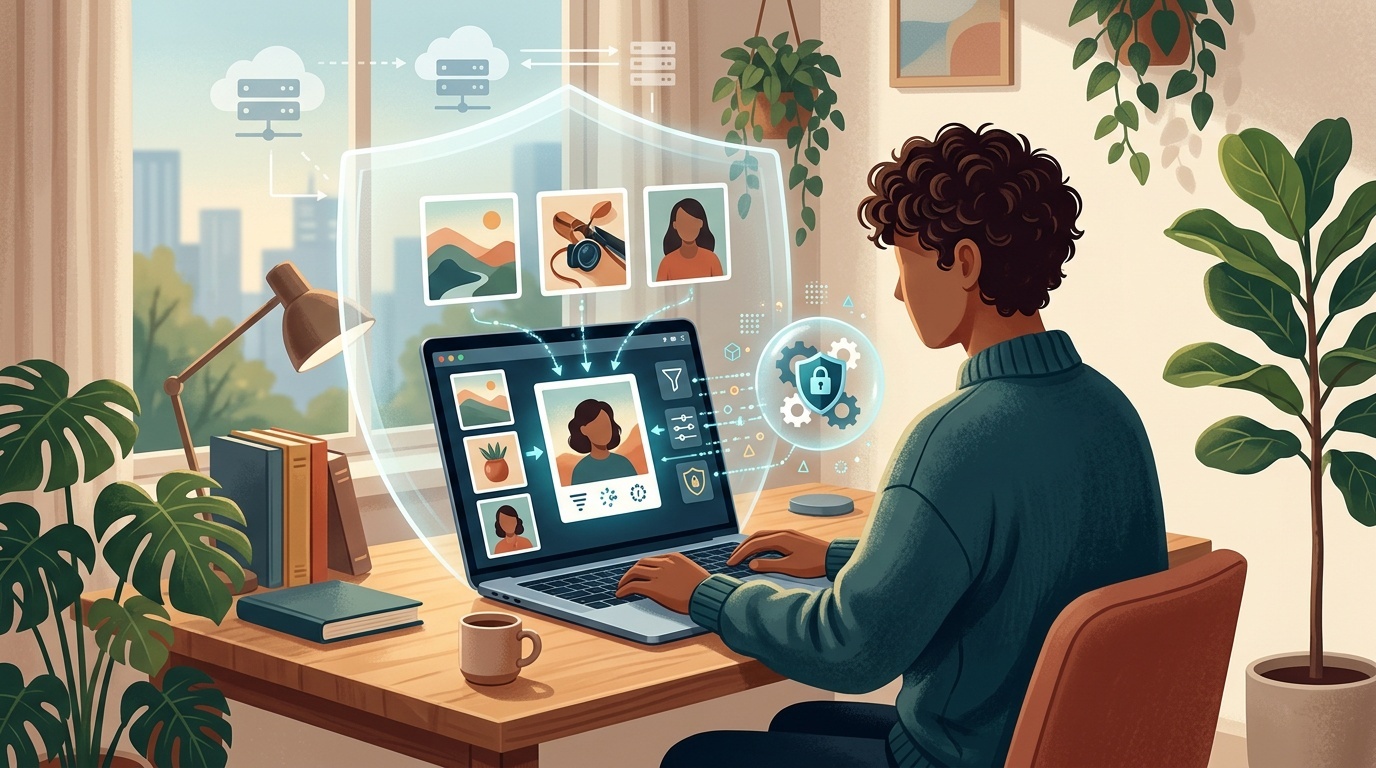
Table des matières
- L’attente par défaut est erronée
- Ce que signifie réellement « côté client »
- Pourquoi c’est important en pratique
- Où se situent encore les compromis
- Le démarrage à froid est plus lourd
- Le matériel de l’utilisateur fixe le plafond
- Vous ne pouvez pas mutualiser entre utilisateurs
- Certaines opérations nécessitent un serveur
- Un petit point d’éthique
- Où aller à partir d’ici
L’attente par défaut est erronée
Pendant la majeure partie des vingt dernières années, faire quoi que ce soit de non trivial avec une image sur le web impliquait de l’envoyer à un serveur. Convertir une photo HEIC, supprimer ses métadonnées EXIF, générer une favicon — tous ces outils vivaient historiquement derrière un formulaire multipart. L’utilisateur cliquait sur upload, le fichier traversait l’internet public, et un serveur quelque part faisait le travail.
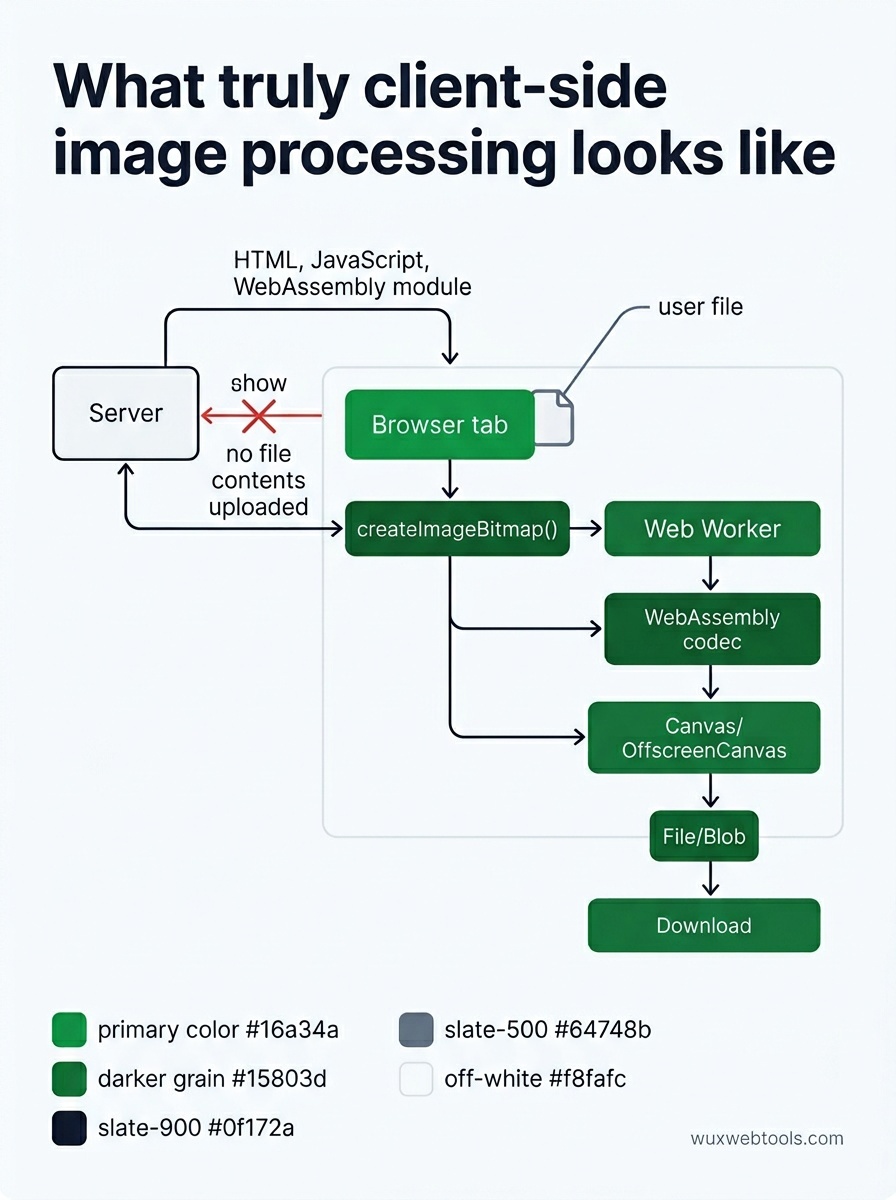
Ce comportement par défaut n’est plus techniquement nécessaire. Les navigateurs ont intégré depuis des années des API qui permettent d’exécuter toute la chaîne localement :
<canvas>andOffscreenCanvaspour le travail au niveau des pixelscreateImageBitmap()pour un décodage rapide, hors du thread principalFileandBlobpour lire des fichiers importés sans les envoyer nulle part- WebAssembly pour des bibliothèques comme libheif, libwebp et ffmpeg
- Web Workers pour garder l’interface réactive pendant les traitements lourds
Si vous assemblez tout cela, le fichier ne quitte jamais l’appareil. Le serveur ne le voit jamais. Il n’y a rien à journaliser, rien à divulguer, rien à assigner en justice.
Ce que signifie réellement « côté client »
Il vaut la peine d’être précis, car le discours marketing de nombreux outils « privés » est approximatif.
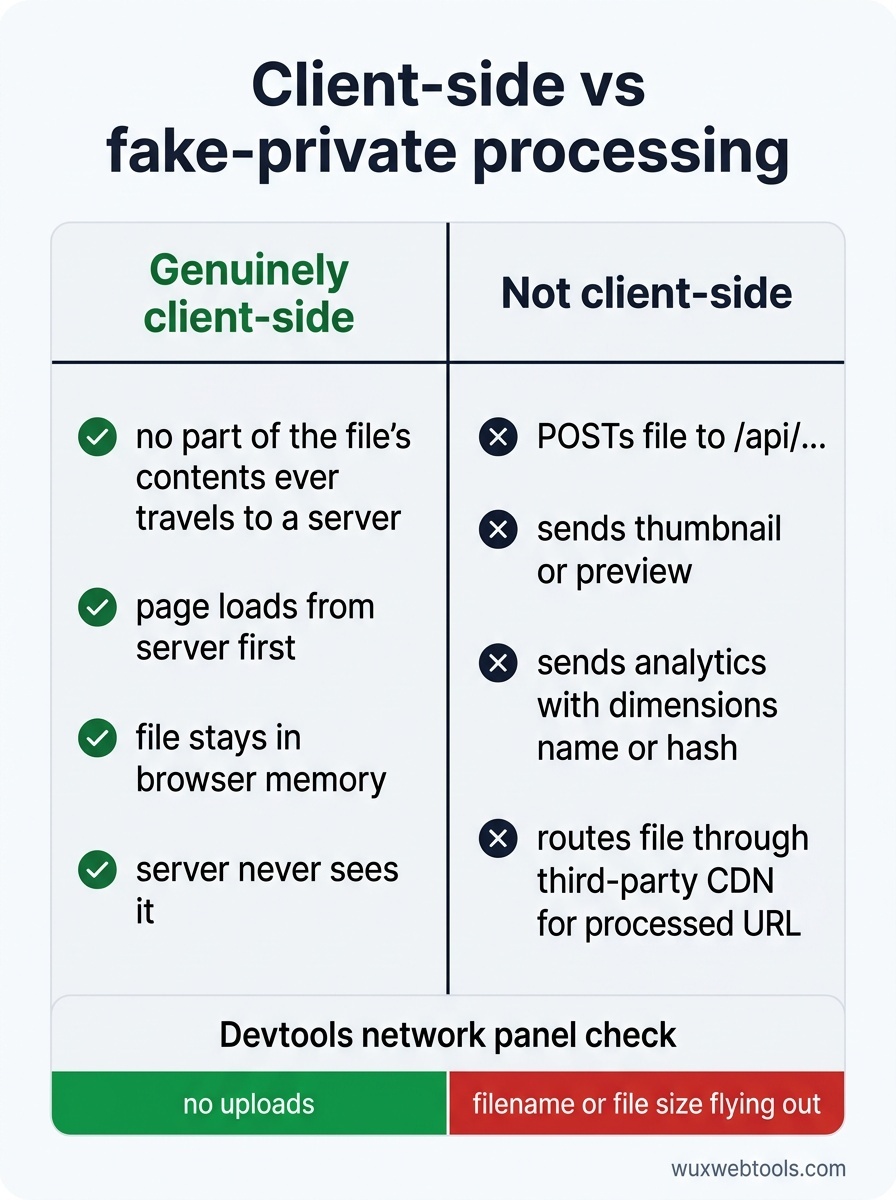
Un outil est réellement côté client lorsque, une fois la page chargée, aucune partie du contenu du fichier n’est jamais envoyée à un serveur. La page elle-même est chargée depuis un serveur (HTML, JavaScript, peut-être un module WebAssembly). Après cela, votre fichier entre dans la mémoire du navigateur et y reste jusqu’à ce que vous fermiez l’onglet.
Un outil n’est pas côté client s’il :
- envoie le fichier en POST vers un endpoint
/api/... - envoie une vignette ou un aperçu à un serveur
- appelle un endpoint d’analytics avec les métadonnées du fichier (dimensions, nom, hash)
- fait transiter le fichier par un CDN tiers qui renvoie une URL traitée
Le panneau réseau des devtools de votre navigateur est le juge de paix. Ouvrez-le, déposez un fichier, et vérifiez ce qui est envoyé. Si vous voyez votre nom de fichier ou la taille de votre fichier partir, l’outil n’est pas aussi privé qu’il le prétend.
Pourquoi c’est important en pratique
Trois groupes de personnes bénéficient discrètement du déplacement du traitement d’images dans le navigateur.
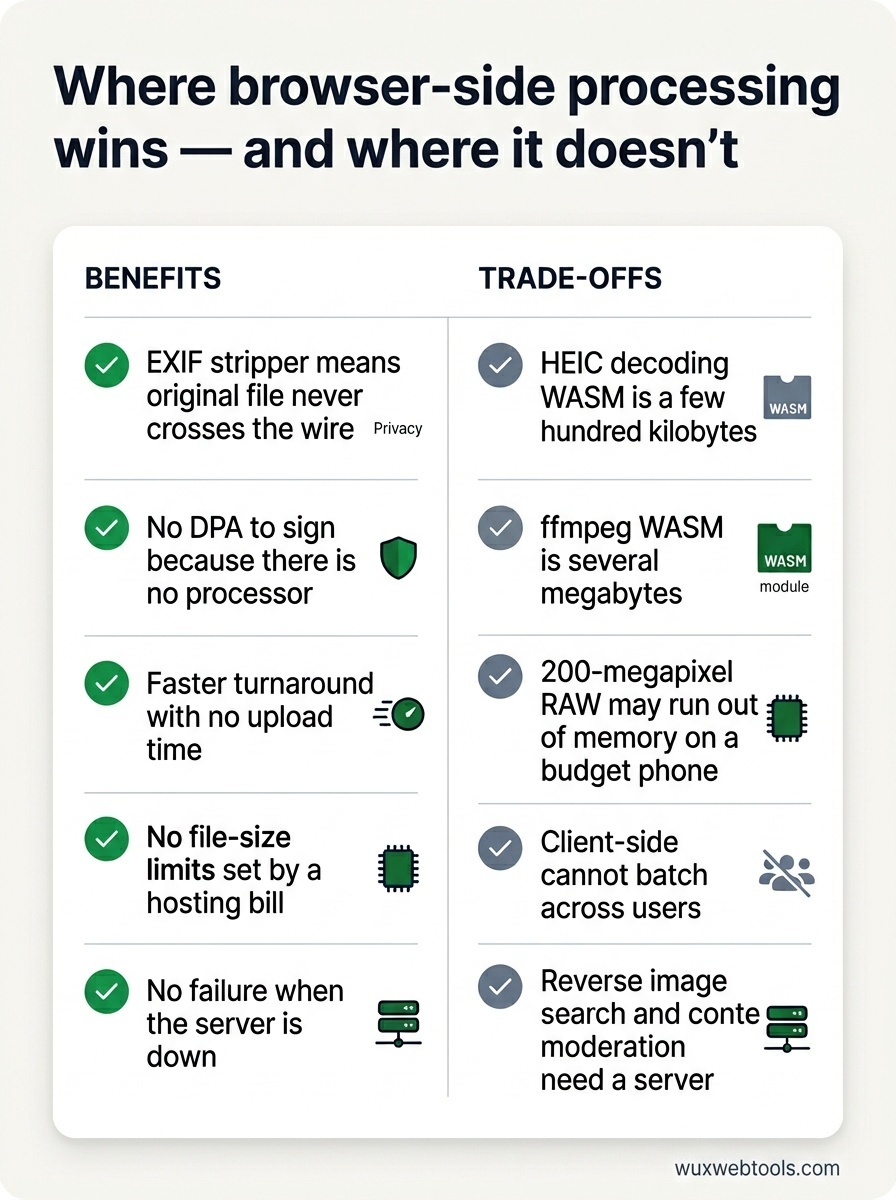
Les journalistes, militants et chercheurs manipulent des sources qui seraient dangereuses si elles fuyaient. Les métadonnées EXIF peuvent inclure les coordonnées GPS de l’appareil qui a pris la photo. Un outil de suppression EXIF côté navigateur signifie que le fichier original ne traverse jamais le réseau.
Les entreprises soumises à la réglementation — santé, finance, juridique — auraient autrement besoin d’un accord de traitement des données avec l’entité qui exploite l’outil. Une page statique qui fait le travail localement n’a aucun DPA à signer, car il n’y a pas de sous-traitant.
Tous les autres obtiennent les avantages évidents : un résultat plus rapide (pas de temps d’envoi), aucune limite de taille de fichier imposée par une facture d’hébergement, aucune panne lorsque le serveur est indisponible.
Où se situent encore les compromis
Le côté client n’est pas magique. Il existe de vrais coûts auxquels il faut réfléchir avant de le choisir pour un problème donné.
Le démarrage à froid est plus lourd
Un bundle WebAssembly pour décoder du HEIC pèse quelques centaines de kilo-octets. ffmpeg compilé en WASM pèse plusieurs mégaoctets. La première visite paie ce coût. La mise en cache aide, et le code-splitting aide encore davantage — ne chargez que le codec que l’utilisateur a effectivement choisi.
Le matériel de l’utilisateur fixe le plafond
Un fichier RAW de 200 mégapixels épuisera la mémoire d’un téléphone d’entrée de gamme bien avant celle d’un serveur. Soyez honnête dans l’interface sur ce qui est réaliste sur l’appareil.
Vous ne pouvez pas mutualiser entre utilisateurs
Le traitement côté serveur peut dédupliquer et amortir. Si un million d’utilisateurs convertissent la même image de banque d’images, un serveur peut la traiter une seule fois. Le côté client le fait un million de fois. Pour la plupart des usages d’outils personnels, cela va très bien — le travail est de toute façon unique — mais il vaut mieux le savoir.
Certaines opérations nécessitent un serveur
La recherche d’image inversée nécessite un index. La modération de contenu nécessite un modèle trop volumineux pour être livré au navigateur. Tout ce qui compare votre fichier à un corpus que vous ne possédez pas nécessite un backend.
Un petit point d’éthique
Si votre outil est réellement côté client, dites-le clairement et prouvez-le. Mettez un lien vers le code source, renvoyez au panneau réseau, expliquez ce qui s’exécute où. Des phrases comme « nous ne stockons pas vos données » ne veulent rien dire sans une architecture pour les étayer — chaque outil côté serveur qui a un jour laissé fuir des données client a dit exactement la même chose, et le pensait à ce moment-là.
L’inverse vaut aussi. Si votre outil est côté serveur, ne prétendez pas le contraire. Les utilisateurs ont appris à reconnaître le schéma, et la perte de confiance lorsqu’ils vous prennent sur le fait est permanente.
<!-- tool-cta:start -->
💡 Essayez ceci: Découvrez le traitement côté client en action avec Image Compressor, qui réduit les images entièrement dans votre navigateur afin que rien ne soit jamais téléversé vers un serveur.
<!-- tool-cta:end -->
Où aller à partir d’ici
Si vous construisez aujourd’hui un petit utilitaire d’image, choisissez par défaut le côté client et ne recourez à un serveur que lorsque vous avez une raison concrète. Le navigateur vous surprendra par l’ampleur du travail qu’il peut prendre en charge — et les personnes à l’autre bout de la connexion réseau vous remercieront discrètement pour les octets qui n’ont jamais quitté leur machine.
Questions fréquemment posées
Le traitement côté client est-il toujours plus confidentiel que le traitement côté serveur ?
Alors pourquoi tous les outils ne fonctionnent-ils pas ainsi ?
WebAssembly ralentit-il mon ordinateur ?
Qu’en est-il des très grands fichiers ?
Sources et lectures complémentaires