Por que processar imagens no navegador é uma vitória para a privacidade
Como APIs web modernas permitem criar ferramentas de imagem genuinamente privadas — e o que isso significa para as pessoas que as usam.
 The Wux Webtools Team
5 min de leitura
Tabela de conteúdos
- A expectativa padrão está errada
- O que "client-side" realmente significa
- Por que isso importa na prática
- Onde as compensações ainda existem
- O arranque a frio é mais pesado
- O hardware do usuário define o teto
- Você não pode fazer lotes entre usuários
- Algumas operações precisam de um servidor
- Um pequeno ponto ético
- Para onde ir a partir daqui
A expectativa padrão está errada
Durante a maior parte dos últimos vinte anos, fazer qualquer coisa não trivial com uma imagem na web significava enviá-la para um servidor. Converter uma foto HEIC, remover seus metadados EXIF, gerar um favicon — historicamente, cada uma dessas ferramentas vivia atrás de um formulário multipart. O usuário clicava em upload, o arquivo atravessava a internet pública, e um servidor em algum lugar fazia o trabalho.
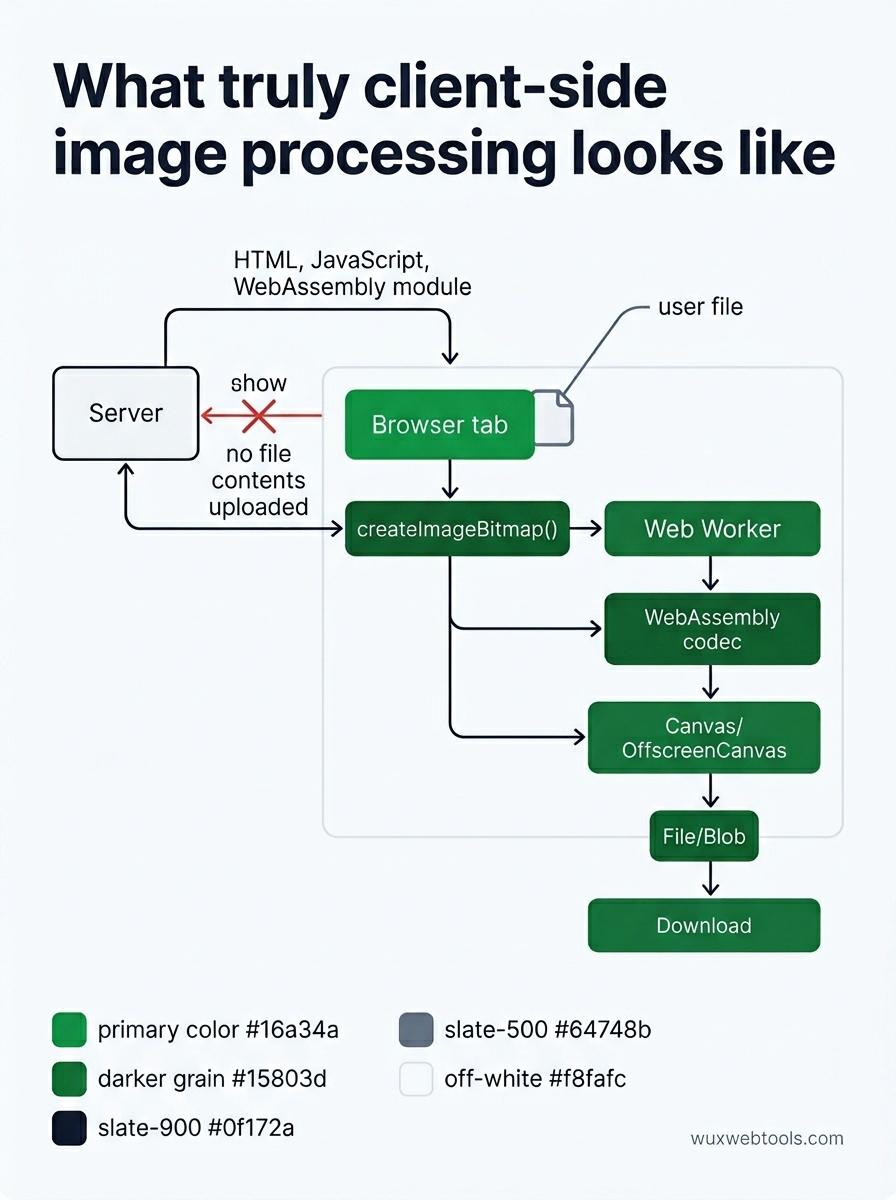
Esse padrão já não é tecnicamente necessário. Há anos os navegadores trazem APIs que permitem executar todo o pipeline localmente:
<canvas>andOffscreenCanvaspara trabalho em nível de pixelcreateImageBitmap()para decodificação rápida e fora da thread principalFileandBlobpara ler uploads sem enviá-los a lugar nenhum- WebAssembly para bibliotecas como libheif, libwebp e ffmpeg
- Web Workers para manter a UI responsiva enquanto tarefas pesadas são executadas
Se você juntar essas peças, o arquivo nunca sai do dispositivo. O servidor nunca o vê. Não há nada para registrar em logs, nada para vazar, nada para entregar por intimação.
O que "client-side" realmente significa
Vale a pena ser preciso, porque o texto de marketing de muitas ferramentas "privadas" é impreciso.
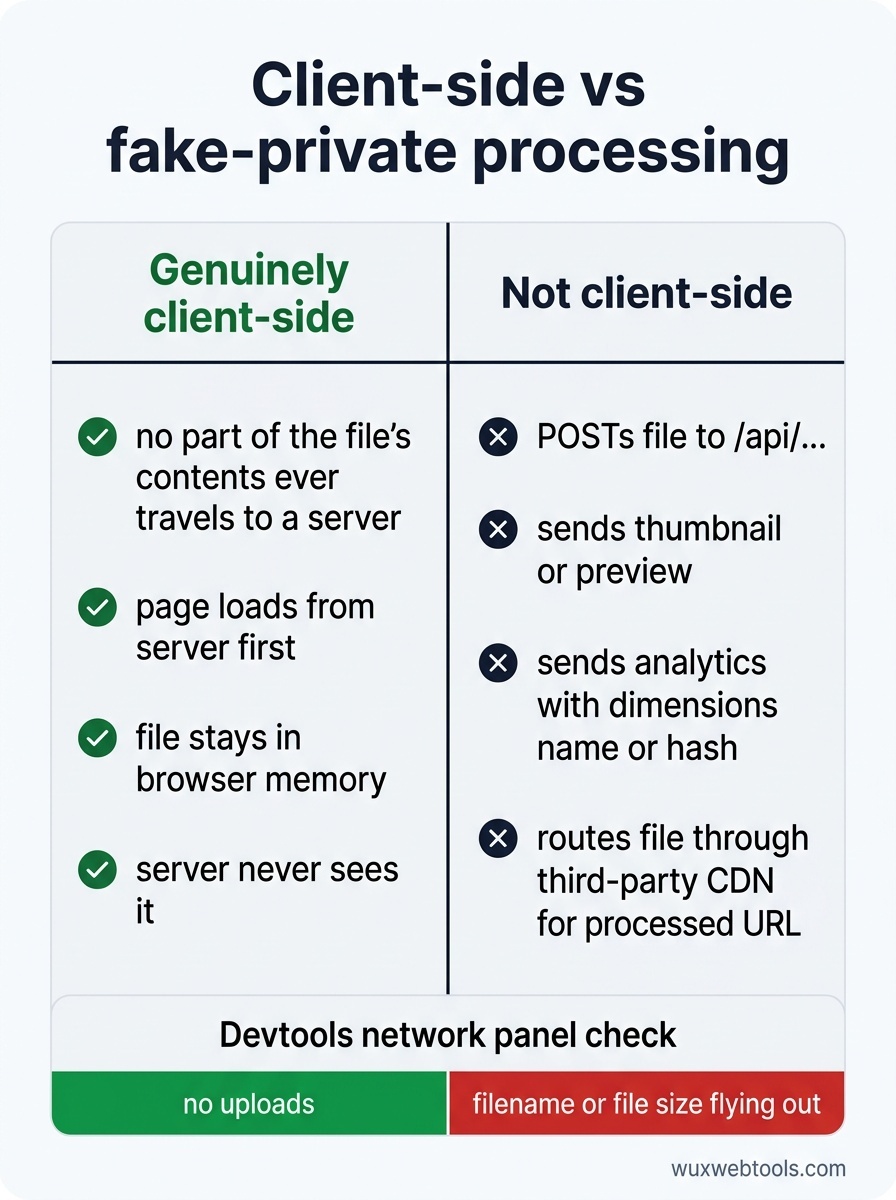
Uma ferramenta é genuinamente client-side quando, depois que a página é carregada, nenhuma parte do conteúdo do arquivo jamais viaja para um servidor. A própria página é carregada de um servidor (HTML, JavaScript, talvez um módulo WebAssembly). Depois disso, seu arquivo entra na memória do navegador e permanece lá até você fechar a aba.
Uma ferramenta não é client-side se ela:
- Faz POST do arquivo para um endpoint
/api/... - Envia uma miniatura ou prévia para um servidor
- Chama um endpoint de analytics com metadados do arquivo (dimensões, nome, hash)
- Encaminha o arquivo por uma CDN de terceiros que retorna uma URL processada
O painel de rede nas ferramentas de desenvolvimento do seu navegador é quem diz a verdade. Abra-o, solte um arquivo e verifique o que é enviado. Se você vir o nome do arquivo ou o tamanho do arquivo saindo, a ferramenta não é tão privada quanto afirma.
Por que isso importa na prática
Três grupos de pessoas se beneficiam discretamente quando o processamento de imagens passa para o navegador.
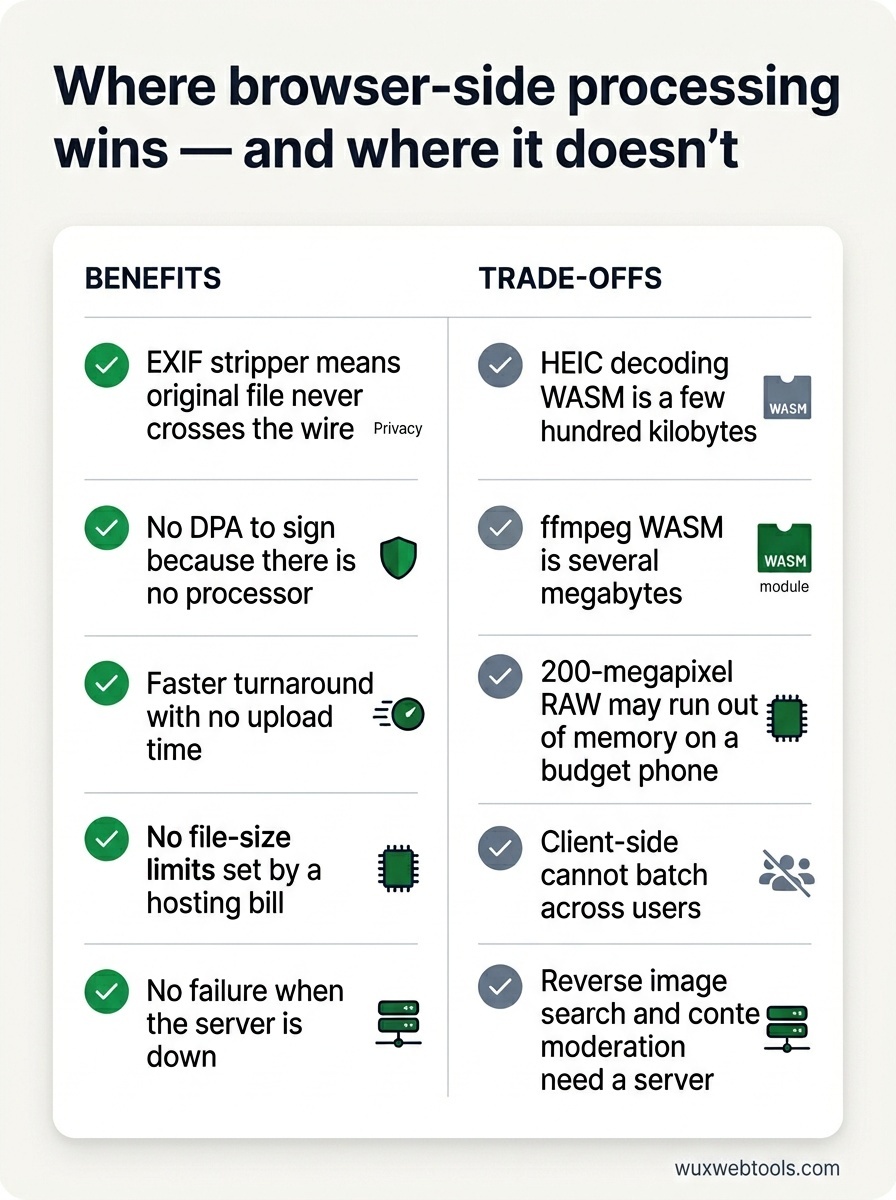
Jornalistas, ativistas e pesquisadores lidam com material de origem que seria perigoso se vazasse. Metadados EXIF podem incluir coordenadas GPS do dispositivo que tirou a foto. Um removedor de EXIF no navegador significa que o arquivo original nunca cruza a rede.
Empresas sujeitas a regulamentação — saúde, finanças, jurídico — caso contrário precisariam de um acordo de processamento de dados com quem opera a ferramenta. Uma página estática que faz o trabalho localmente não tem DPA a assinar porque não há processador.
Todas as outras pessoas recebem os benefícios óbvios: retorno mais rápido (sem tempo de upload), sem limites de tamanho de arquivo definidos por uma conta de hospedagem, sem falha quando o servidor está fora do ar.
Onde as compensações ainda existem
Client-side não é magia. Há custos reais que você deve considerar antes de escolhê-lo para um determinado problema.
O arranque a frio é mais pesado
Um bundle WebAssembly para decodificação de HEIC tem algumas centenas de kilobytes. ffmpeg compilado para WASM tem vários megabytes. A primeira visita paga esse custo. O cache ajuda, e o code-splitting ajuda ainda mais — carregue apenas o codec que o usuário realmente escolheu.
O hardware do usuário define o teto
Um arquivo RAW de 200 megapixels esgotará a memória de um celular básico muito antes de esgotá-la em um servidor. Seja honesto na UI sobre o que é realista naquele dispositivo.
Você não pode fazer lotes entre usuários
O processamento server-side pode deduplicar e amortizar. Se um milhão de usuários converter a mesma imagem de banco de imagens, um servidor pode processá-la uma vez. Client-side faz isso um milhão de vezes. Para a maioria das cargas de trabalho de ferramentas pessoais, isso não é um problema — de qualquer forma, o trabalho é único —, mas vale saber.
Algumas operações precisam de um servidor
Busca reversa de imagens precisa de um índice. Moderação de conteúdo precisa de um modelo grande demais para ser distribuído. Qualquer coisa que compare seu arquivo a um corpus que você não possui precisa de um backend.
Um pequeno ponto ético
Se sua ferramenta é genuinamente client-side, diga isso em alto e bom som e prove. Aponte para o código-fonte, indique o painel de rede, explique o que roda onde. Frases como "não armazenamos seus dados" não significam nada sem uma arquitetura que as sustente — toda ferramenta server-side que já vazou dados de clientes também disse exatamente isso, e acreditava nisso na época.
O inverso também vale. Se sua ferramenta é server-side, não finja o contrário. Os usuários passaram a reconhecer o padrão, e a perda de confiança quando descobrem é permanente.
<!-- tool-cta:start -->
💡 Experimente isto: Veja o processamento no lado do cliente em ação com Image Compressor, que reduz imagens inteiramente no seu navegador para que nada jamais seja enviado a um servidor.
<!-- tool-cta:end -->
Para onde ir a partir daqui
Se você está criando uma pequena utilidade de imagem hoje, adote client-side por padrão e só recorra a um servidor quando tiver um motivo concreto. O navegador vai surpreender você com o quanto consegue levar o trabalho adiante — e as pessoas do outro lado da conexão de rede agradecerão discretamente pelos bytes que nunca saíram de suas máquinas.
Perguntas frequentes
O processamento client-side é sempre mais privado do que o server-side?
Então por que nem todas as ferramentas funcionam assim?
WebAssembly deixa meu computador mais lento?
E arquivos muito grandes?
Fontes e leituras adicionais