ব্রাউজারে ছবি প্রক্রিয়াকরণ কেন গোপনীয়তার জন্য লাভজনক
আধুনিক web APIs কীভাবে সত্যিকারের ব্যক্তিগত ইমেজ টুল তৈরি করতে দেয় — এবং যারা সেগুলো ব্যবহার করেন তাদের জন্য এর মানে কী।
 The Wux Webtools Team
1 মিনিট পড়া
সুচিপত্র
প্রচলিত প্রত্যাশাটি ভুল
গত বিশ বছরের বেশিরভাগ সময়ে, ওয়েবে কোনো ছবির সঙ্গে সামান্য জটিল কিছু করতে হলে সেটি সার্ভারে আপলোড করতে হতো। একটি HEIC ছবি কনভার্ট করা, তার EXIF metadata সরানো, একটি favicon তৈরি করা — ঐতিহাসিকভাবে এসব টুলের প্রতিটিই multipart form-এর পেছনে ছিল। ব্যবহারকারী upload ক্লিক করতেন, ফাইলটি পাবলিক ইন্টারনেট পেরিয়ে যেত, এবং কোথাও একটি সার্ভার কাজটি করত।
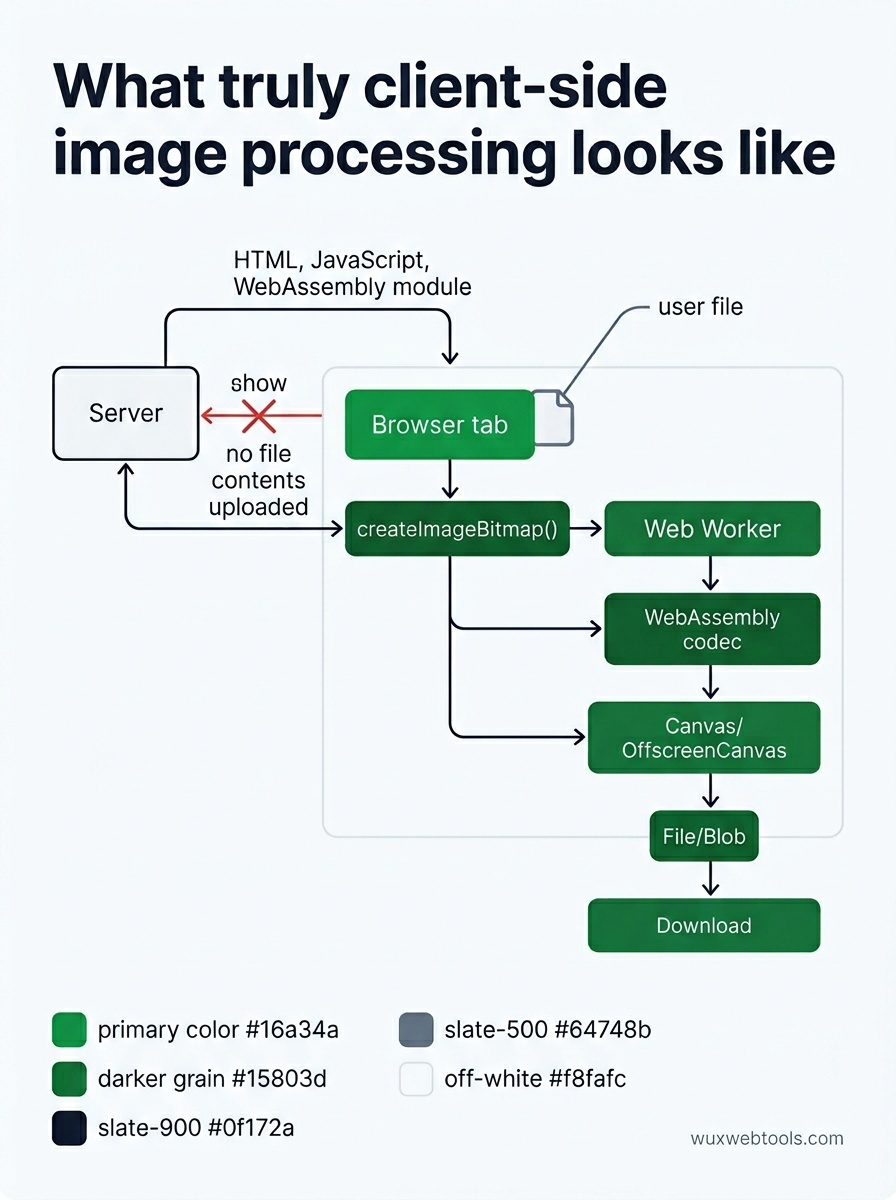
এই ডিফল্টটি এখন আর প্রযুক্তিগতভাবে প্রয়োজনীয় নয়। বহু বছর আগেই ব্রাউজারগুলো এমন APIs এনেছে, যেগুলো পুরো pipeline স্থানীয়ভাবে চালাতে পারে:
<canvas>andOffscreenCanvasপিক্সেল-স্তরের কাজের জন্যcreateImageBitmap()দ্রুত, off-thread decoding-এর জন্যFileandBlobকোথাও না পাঠিয়ে আপলোড পড়ার জন্য- WebAssembly libheif, libwebp and ffmpeg-এর মতো লাইব্রেরির জন্য
- Web Workers ভারী কাজ চলার সময় UI সচল রাখার জন্য
এগুলো একসঙ্গে জুড়ে দিলে, ফাইলটি কখনো ডিভাইস ছাড়ে না। সার্ভার কখনো সেটি দেখে না। লগ করার মতো কিছু নেই, ফাঁস হওয়ার মতো কিছু নেই, আদালতে তলব করার মতোও কিছু নেই।
"client-side" আসলে কী বোঝায়
এখানে সুনির্দিষ্ট হওয়া জরুরি, কারণ অনেক "private" টুলের marketing copy বেশ ঢিলেঢালা।
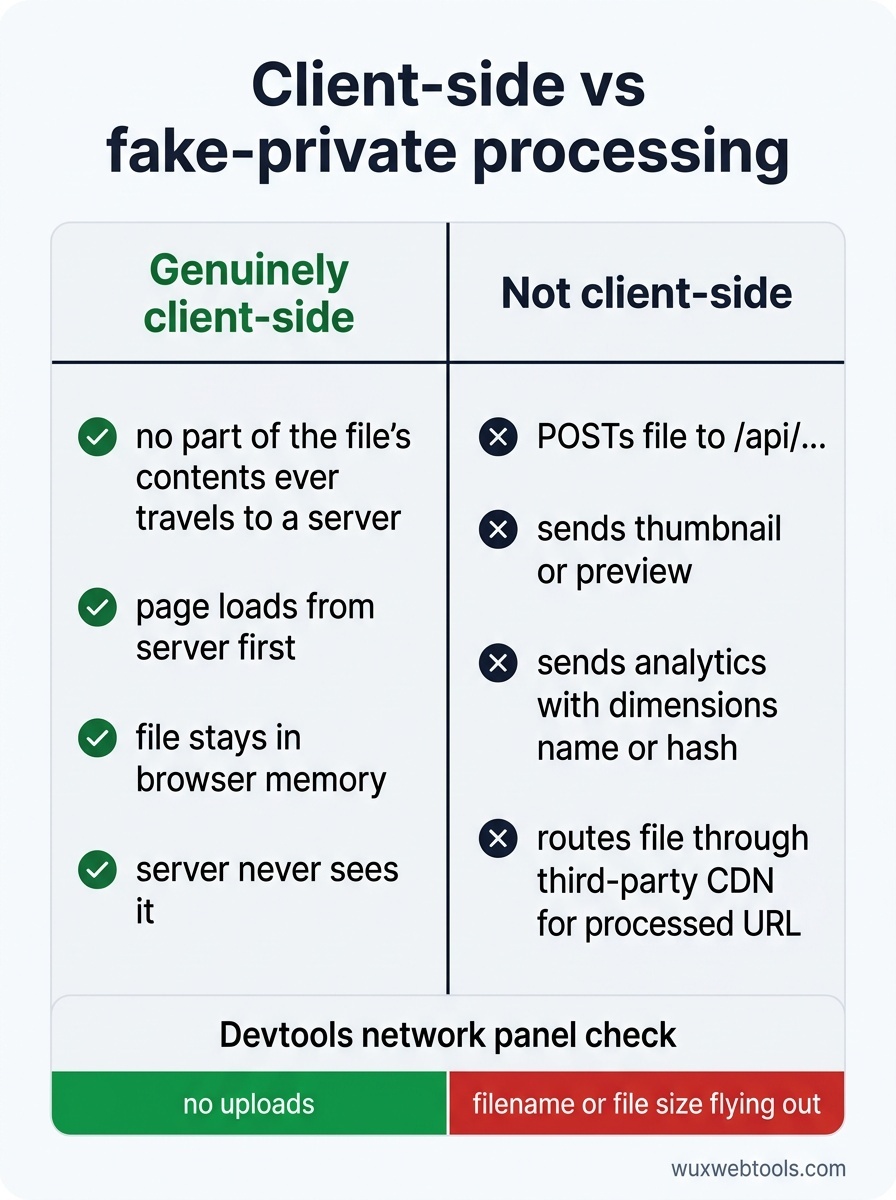
কোনো টুল সত্যিকারের client-side তখনই, যখন পেজ লোড হওয়ার পর ফাইলের কনটেন্টের কোনো অংশই কখনো সার্ভারে যায় না। পেজটি নিজে সার্ভার থেকে লোড হয় (HTML, JavaScript, হয়তো একটি WebAssembly module)। এরপর আপনার ফাইল ব্রাউজারের memory-তে প্রবেশ করে এবং ট্যাব বন্ধ করা পর্যন্ত সেখানেই থাকে।
কোনো টুল client-side নয় যদি এটি:
- ফাইলটি কোনো
/api/...endpoint-এ POST করে - কোনো thumbnail বা preview সার্ভারে পাঠায়
- file metadata (dimensions, name, hash) সহ কোনো analytics endpoint কল করে
- ফাইলটি third-party CDN-এর মধ্য দিয়ে পাঠায়, যা একটি processed URL ফেরত দেয়
আপনার ব্রাউজারের devtools-এর network panel-ই সত্য বলে। সেটি খুলুন, একটি ফাইল ড্রপ করুন, এবং দেখুন কী আপলোড হচ্ছে। আপনার filename বা file size বাইরে যেতে দেখলে, টুলটি তার দাবির মতো ব্যক্তিগত নয়।
বাস্তবে এটি কেন গুরুত্বপূর্ণ
image processing ব্রাউজারে চলে এলে তিনটি গোষ্ঠীর মানুষ নীরবে উপকৃত হন।
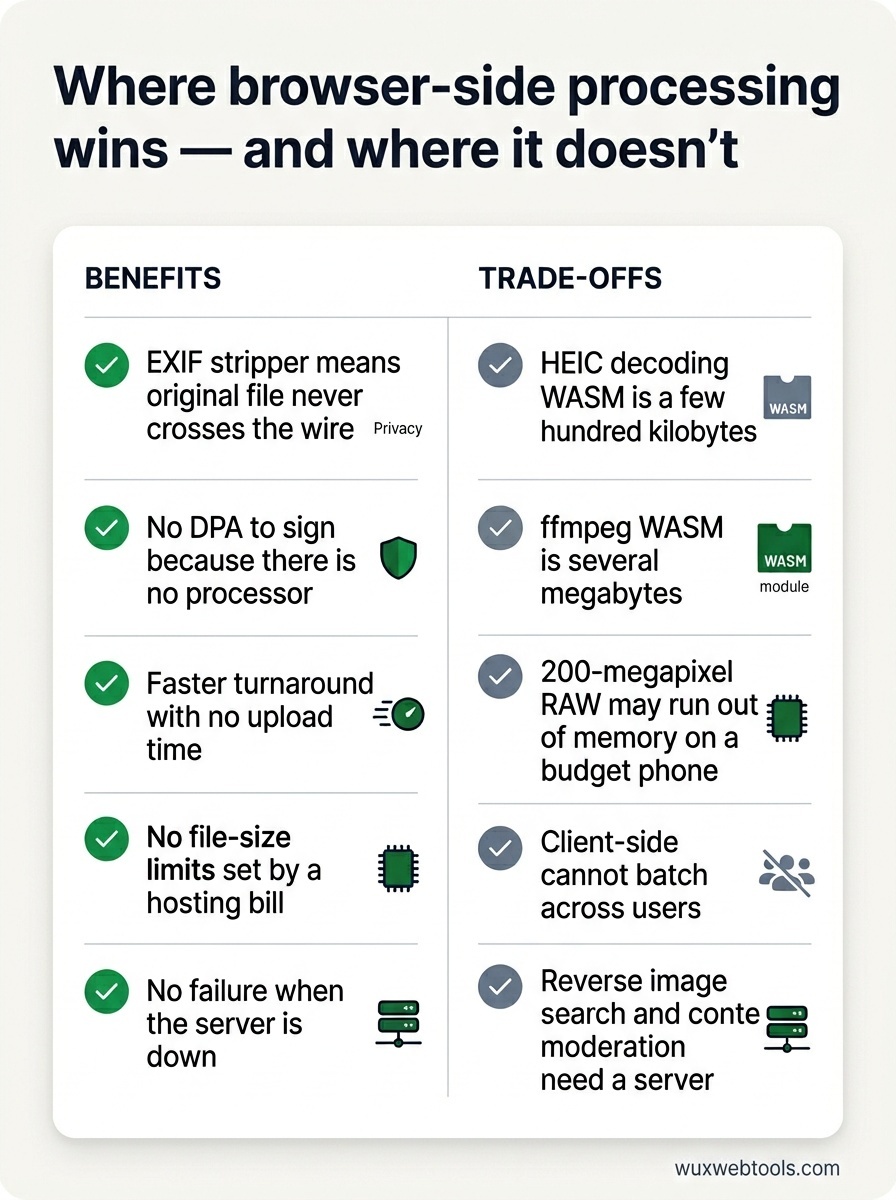
সাংবাদিক, অধিকারকর্মী ও গবেষকরা এমন উৎস উপাদান সামলান, যা ফাঁস হলে বিপজ্জনক হতে পারে। EXIF metadata-তে ছবি তোলা ডিভাইসের GPS coordinates থাকতে পারে। browser-side EXIF stripper মানে আসল ফাইলটি কখনো নেটওয়ার্কে যায় না।
নিয়ন্ত্রণাধীন কোম্পানিগুলো — healthcare, finance, legal — অন্যথায় টুলটি যারা চালায় তাদের সঙ্গে একটি data-processing agreement করতে হতো। স্থানীয়ভাবে কাজ করা একটি static page-এর জন্য কোনো DPA সই করতে হয় না, কারণ এখানে কোনো processor নেই।
বাকি সবাই স্পষ্ট সুবিধাগুলো পান: দ্রুত কাজ শেষ হওয়া (upload time নেই), hosting bill দ্বারা নির্ধারিত file-size limit নেই, সার্ভার ডাউন হলে ব্যর্থতা নেই।
আপসগুলো এখনো কোথায় রয়ে গেছে
Client-side কোনো জাদু নয়। নির্দিষ্ট কোনো সমস্যার জন্য এটি বেছে নেওয়ার আগে ভাবার মতো বাস্তব খরচ আছে।
Cold start ভারী
HEIC decoding-এর জন্য একটি WebAssembly bundle কয়েকশো kilobytes হতে পারে। WASM-এ compiled ffmpeg কয়েক megabytes। প্রথম ভিজিটে এই খরচ দিতে হয়। Caching সাহায্য করে, আর code-splitting আরও বেশি সাহায্য করে — ব্যবহারকারী সত্যিই যে codec বেছে নিয়েছেন শুধু সেটিই লোড করুন।
ব্যবহারকারীর hardware-ই সীমা নির্ধারণ করে
একটি 200-megapixel RAW file সস্তা ফোনে memory শেষ করে ফেলবে, সার্ভারে শেষ হওয়ার অনেক আগেই। ডিভাইসে বাস্তবসম্মত কী, তা UI-তে সৎভাবে জানান।
আপনি ব্যবহারকারীদের জুড়ে batch করতে পারবেন না
Server-side processing deduplicate এবং amortise করতে পারে। এক মিলিয়ন ব্যবহারকারী একই stock image কনভার্ট করলে, সার্ভার সেটি একবারই process করতে পারে। Client-side সেটি এক মিলিয়ন বার করে। বেশিরভাগ personal-tool workload-এর জন্য এটি ঠিক আছে — কাজটি এমনিতেই unique — কিন্তু বিষয়টি জানা মূল্যবান।
কিছু অপারেশনের জন্য সার্ভার দরকার
Reverse image search-এর জন্য index দরকার। Content moderation-এর জন্য এমন model দরকার যা পাঠানোর জন্য খুব বড়। আপনার মালিকানায় নেই এমন কোনো corpus-এর সঙ্গে আপনার ফাইল তুলনা করতে হলে backend দরকার।
একটি ছোট নৈতিক বিষয়
আপনার টুল যদি সত্যিই client-side হয়, তা জোরে বলুন এবং প্রমাণ করুন। source-এ link দিন, network panel দেখান, কোথায় কী চলে তা ব্যাখ্যা করুন। "we don't store your data"-এর মতো বাক্য architecture দিয়ে সমর্থন না করলে অর্থহীন — customer data ফাঁস করা প্রতিটি server-side tool-ও ঠিক সেটাই বলেছিল, এবং সে সময় সত্যিই সেটাই বোঝাতে চেয়েছিল।
এর বিপরীতটিও সত্য। আপনার টুল যদি server-side হয়, অন্য কিছু হওয়ার ভান করবেন না। ব্যবহারকারীরা patternটি চিনতে শিখেছেন, এবং ধরা পড়লে আস্থার যে ক্ষতি হয় তা স্থায়ী।
<!-- tool-cta:start -->
💡 এটি চেষ্টা করুন: Image Compressor দিয়ে ক্লায়েন্ট-সাইড প্রসেসিং কাজ করতে দেখুন, যা সম্পূর্ণ আপনার ব্রাউজারেই ছবিগুলো ছোট করে, তাই কোনো কিছুই কখনও সার্ভারে আপলোড হয় না.
<!-- tool-cta:end -->
এখান থেকে কোথায় যাবেন
আজ যদি আপনি একটি ছোট image utility তৈরি করেন, ডিফল্ট হিসেবে client-side বেছে নিন এবং কেবল স্পষ্ট কারণ থাকলেই সার্ভারের দিকে যান। ব্রাউজার কতদূর কাজ বহন করতে পারে তা আপনাকে অবাক করবে — আর network connection-এর অপর প্রান্তে থাকা মানুষরা নীরবে আপনাকে ধন্যবাদ জানাবেন সেই bytes-এর জন্য, যা কখনো তাদের machine ছাড়েনি।
প্রায়শই জিজ্ঞাসিত প্রশ্ন
Client-side processing কি সবসময় server-side-এর চেয়ে বেশি private?
তাহলে সব টুল এভাবে কাজ করে না কেন?
WebAssembly কি আমার computer ধীর করে দেয়?
খুব বড় ফাইলের ক্ষেত্রে কী হবে?
স्रोत ও আরও পড়া