Hvorfor billedbehandling i browseren er en gevinst for privatlivets fred
Hvordan moderne web-API'er lader dig bygge reelt private billedværktøjer — og hvad det betyder for de mennesker, der bruger dem.
 The Wux Webtools Team
4 min læsning
Indholdsfortegnelse
- Standardforventningen er forkert
- Hvad "klientside" faktisk betyder
- Hvorfor det betyder noget i praksis
- Hvor afvejningerne stadig findes
- Koldstart er tungere
- Brugerens hardware sætter loftet
- Du kan ikke batche på tværs af brugere
- Nogle operationer kræver en server
- En lille etisk pointe
- Hvor du går hen herfra
Standardforventningen er forkert
I det meste af de sidste tyve år betød alt ikke-trivielt arbejde med et billede på nettet, at det skulle uploades til en server. Konverter et HEIC-foto, fjern dets EXIF-metadata, generer en favicon — alle disse værktøjer lå historisk bag en multipart-formular. Brugeren klikkede på upload, filen rejste over det åbne internet, og en server et eller andet sted udførte arbejdet.
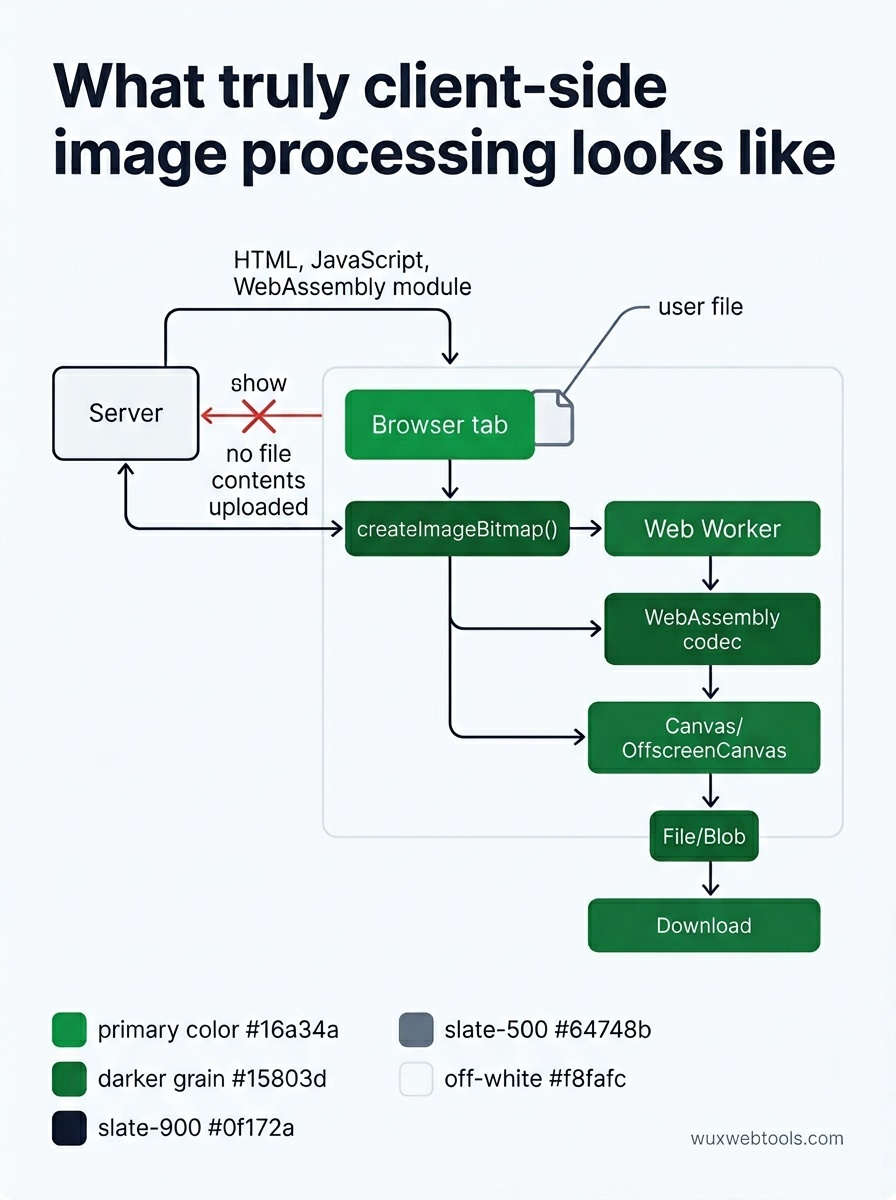
Den standard er ikke længere teknisk nødvendig. Browsere har i årevis leveret API'er, der får hele pipelinen til at køre lokalt:
<canvas>andOffscreenCanvastil arbejde på pixelniveaucreateImageBitmap()til hurtig decoding uden for hovedtrådenFileandBlobtil at læse uploads uden at sende dem nogen steder hen- WebAssembly til biblioteker som libheif, libwebp og ffmpeg
- Web Workers til at holde brugerfladen responsiv, mens tungt arbejde kører
Hvis du sætter dem sammen, forlader filen aldrig enheden. Serveren ser den aldrig. Der er intet at logge, intet at lække, intet at kræve udleveret.
Hvad "klientside" faktisk betyder
Det er værd at være præcis, for markedsføringsteksten på mange "private" værktøjer er upræcis.
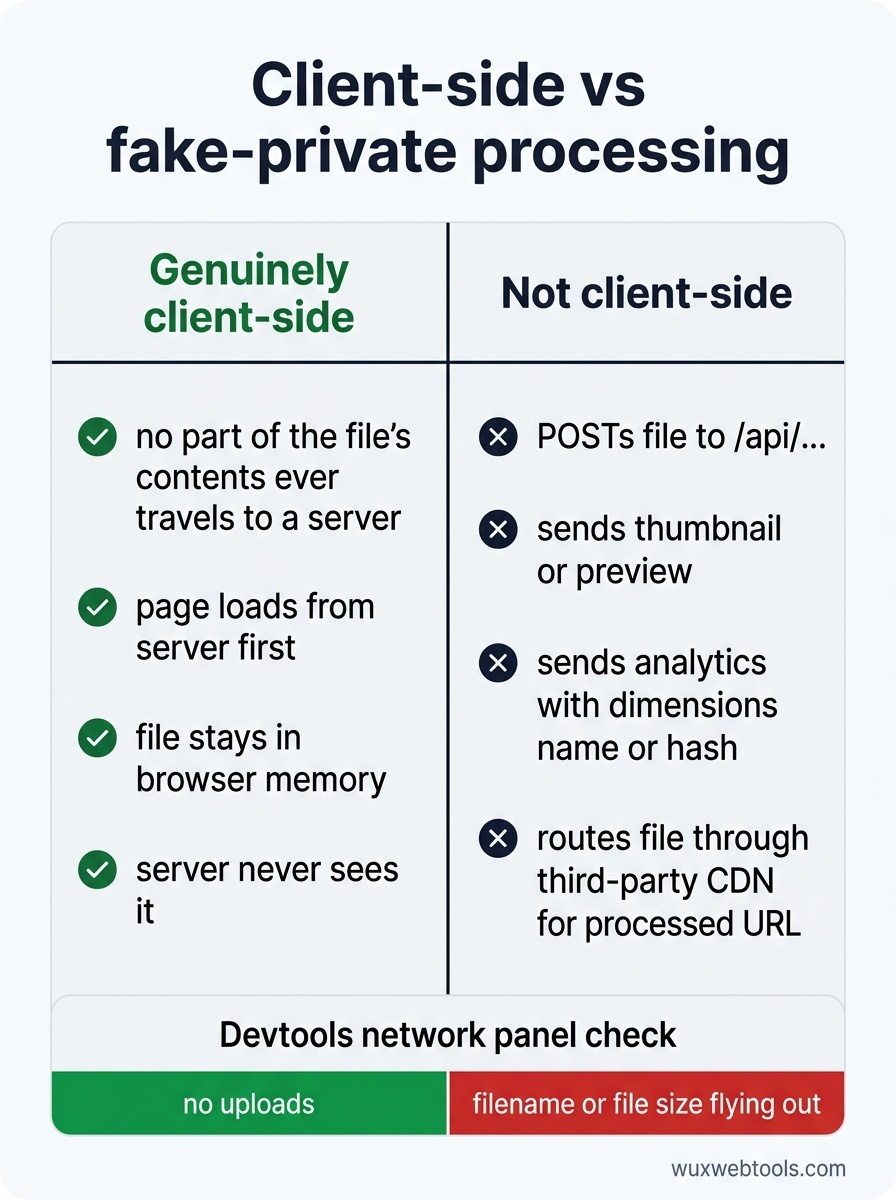
Et værktøj er reelt klientside, når ingen del af filens indhold nogensinde sendes til en server, efter siden er indlæst. Selve siden indlæses fra en server (HTML, JavaScript, måske et WebAssembly-modul). Derefter kommer din fil ind i browserens hukommelse og bliver der, indtil du lukker fanen.
Et værktøj er ikke klientside, hvis det:
- POSTer filen til et
/api/...-endpoint - Sender en thumbnail eller forhåndsvisning til en server
- Kalder et analytics-endpoint med filmetadata (dimensioner, navn, hash)
- Router filen gennem en tredjeparts-CDN, der returnerer en behandlet URL
Netværkspanelet i browserens devtools fortæller sandheden. Åbn det, slip en fil ind, og se, hvad der bliver uploadet. Hvis du ser dit filnavn eller din filstørrelse flyve ud, er værktøjet ikke så privat, som det hævder.
Hvorfor det betyder noget i praksis
Tre grupper af mennesker får stille og roligt gavn af, at billedbehandling flytter ind i browseren.
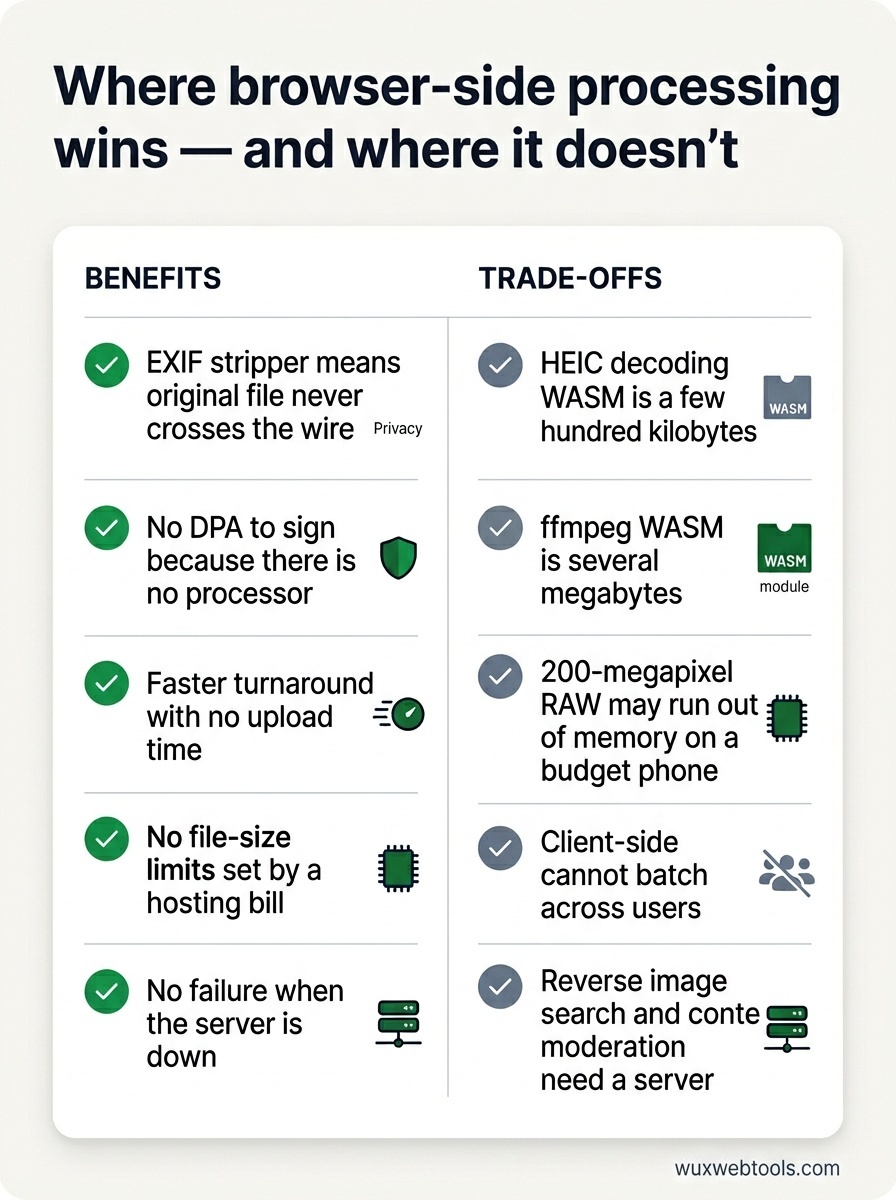
Journalister, aktivister og forskere håndterer kildemateriale, der kan være farligt, hvis det lækker. EXIF-metadata kan indeholde GPS-koordinater fra den enhed, der tog billedet. En EXIF-fjerner i browseren betyder, at den oprindelige fil aldrig krydser netværket.
Virksomheder under regulering — sundhed, finans, jura — ville ellers have brug for en databehandleraftale med den, der driver værktøjet. En statisk side, der udfører arbejdet lokalt, har ingen DPA at underskrive, fordi der ikke er nogen databehandler.
Alle andre får de åbenlyse fordele: hurtigere gennemløb (ingen uploadtid), ingen filstørrelsesgrænser sat af en hostingregning, ingen fejl, når serveren er nede.
Hvor afvejningerne stadig findes
Klientside er ikke magi. Der er reelle omkostninger, du bør tænke igennem, før du vælger det til et bestemt problem.
Koldstart er tungere
En WebAssembly-bundle til HEIC-decoding fylder nogle få hundrede kilobyte. ffmpeg kompileret til WASM fylder flere megabyte. Det betaler det første besøg for. Caching hjælper, og code-splitting hjælper endnu mere — indlæs kun den codec, brugeren faktisk valgte.
Brugerens hardware sætter loftet
En RAW-fil på 200 megapixel løber tør for hukommelse på en billig telefon, længe før den ville gøre det på en server. Vær ærlig i brugerfladen om, hvad der er realistisk på enheden.
Du kan ikke batche på tværs af brugere
Serverside-behandling kan deduplikere og fordele omkostningen. Hvis en million brugere konverterer det samme stockfoto, kan en server behandle det én gang. Klientside gør det en million gange. For de fleste workloads i personlige værktøjer er det fint — arbejdet er alligevel unikt — men det er værd at vide.
Nogle operationer kræver en server
Omvendt billedsøgning kræver et indeks. Indholdsmoderation kræver en model, der er for stor til at sende med. Alt, der sammenligner din fil med et korpus, du ikke ejer, kræver en backend.
En lille etisk pointe
Hvis dit værktøj reelt er klientside, så sig det højt og bevis det. Link til kilden, peg på netværkspanelet, forklar hvad der kører hvor. Formuleringer som "vi gemmer ikke dine data" betyder ingenting uden en arkitektur, der bakker dem op — alle serverside-værktøjer, der nogensinde har lækket kundedata, har også sagt præcis det og mente det på det tidspunkt.
Det omvendte gælder også. Hvis dit værktøj er serverside, så lad være med at foregive andet. Brugere er kommet til at genkende mønsteret, og tillidstabet, når de afslører dig, er permanent.
<!-- tool-cta:start -->
💡 Prøv dette: Se klientsidebehandling i aktion med Image Compressor, som formindsker billeder udelukkende i din browser, så intet nogensinde uploades til en server.
<!-- tool-cta:end -->
Hvor du går hen herfra
Hvis du bygger et lille billedværktøj i dag, så vælg som udgangspunkt klientside, og grib kun efter en server, når du har en konkret grund. Browseren vil overraske dig med, hvor langt den kan bære arbejdet — og menneskene i den anden ende af netværksforbindelsen vil stille takke dig for de bytes, der aldrig forlod deres maskine.
Ofte stillede spørgsmål
Er klientside-behandling altid mere privat end serverside?
Hvorfor fungerer alle værktøjer så ikke sådan?
Gør WebAssembly min computer langsommere?
Hvad med meget store filer?
Kilder & videre læsning