ทำไมการประมวลผลภาพในเบราว์เซอร์จึงเป็นชัยชนะด้านความเป็นส่วนตัว
Web APIs สมัยใหม่ช่วยให้คุณสร้างเครื่องมือจัดการภาพที่เป็นส่วนตัวได้จริงอย่างไร — และสิ่งนั้นหมายถึงอะไรสำหรับผู้ใช้งาน
 The Wux Webtools Team
11 อ่านขั้นต่ำ
สารบัญ
ความคาดหวังเริ่มต้นนั้นผิด
ตลอดช่วงยี่สิบปีที่ผ่านมาเป็นส่วนใหญ่ การทำสิ่งใดก็ตามที่ไม่ใช่เรื่องพื้นฐานกับภาพบนเว็บหมายถึงการอัปโหลดภาพนั้นไปยังเซิร์ฟเวอร์ แปลงภาพ HEIC, ลบ EXIF metadata, สร้าง favicon — เครื่องมือเหล่านี้ในอดีตล้วนอยู่หลังฟอร์มแบบ multipart ผู้ใช้คลิก upload ไฟล์เดินทางผ่านอินเทอร์เน็ตสาธารณะ และเซิร์ฟเวอร์ที่ไหนสักแห่งเป็นผู้ทำงานนั้น
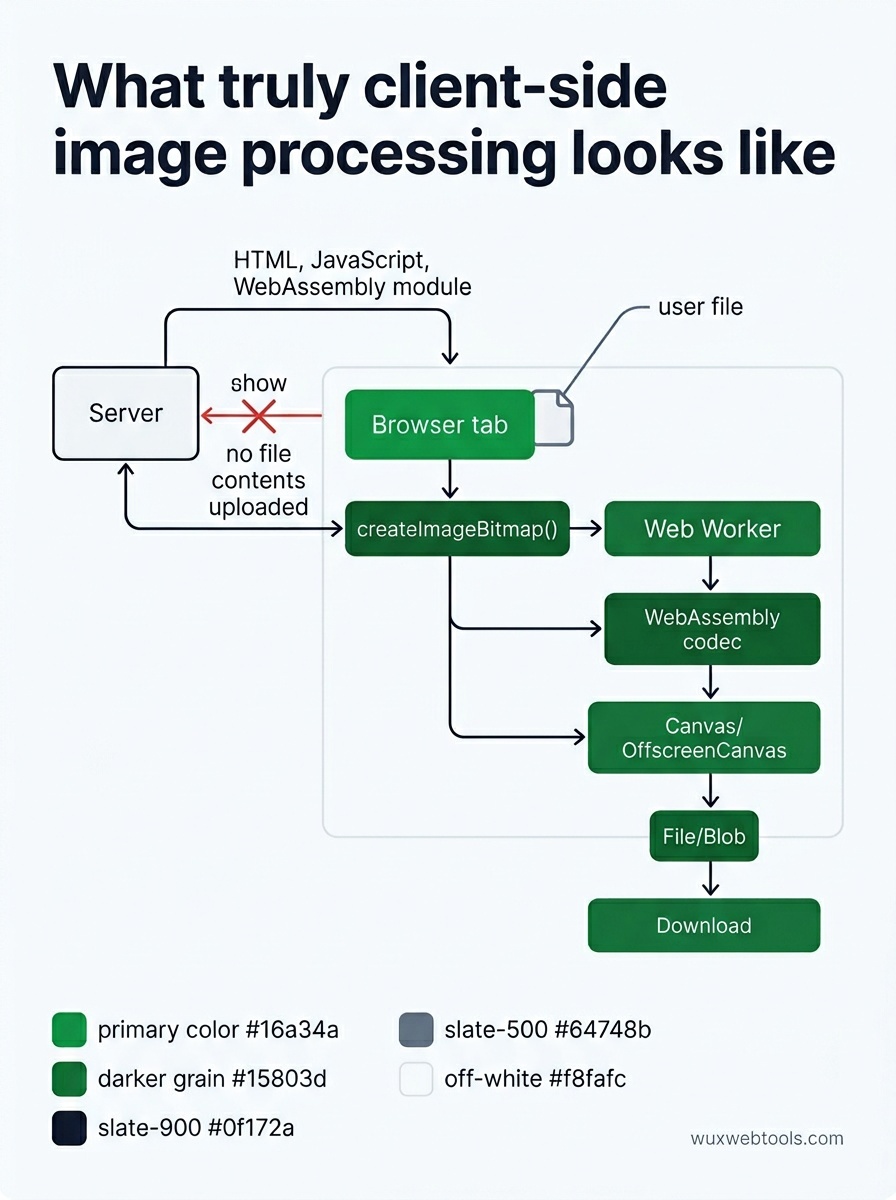
ค่าเริ่มต้นแบบนั้นไม่จำเป็นในเชิงเทคนิคอีกต่อไปแล้ว เบราว์เซอร์มี APIs มาหลายปีแล้วที่ทำให้ทั้ง pipeline ทำงานได้ในเครื่อง:
<canvas>andOffscreenCanvasสำหรับงานระดับพิกเซลcreateImageBitmap()สำหรับการถอดรหัสที่รวดเร็วและทำงานนอกเธรดหลักFileandBlobสำหรับอ่านไฟล์ที่อัปโหลดโดยไม่ต้องส่งไปที่ใด- WebAssembly สำหรับไลบรารีอย่าง libheif, libwebp and ffmpeg
- Web Workers เพื่อให้ UI ยังตอบสนองได้ระหว่างที่งานหนักกำลังทำงาน
หากคุณนำสิ่งเหล่านี้มาต่อเข้าด้วยกัน ไฟล์จะไม่เคยออกจากอุปกรณ์ เซิร์ฟเวอร์ไม่เคยเห็นไฟล์นั้น ไม่มีอะไรให้บันทึกลง log ไม่มีอะไรให้รั่วไหล ไม่มีอะไรให้เรียกตามหมายศาล
ความหมายที่แท้จริงของ "client-side"
ควรพูดให้แม่นยำ เพราะข้อความการตลาดของเครื่องมือ "private" จำนวนมากนั้นคลุมเครือ
เครื่องมือหนึ่งจะเป็น client-side อย่างแท้จริงเมื่อ หลังจากโหลดหน้าแล้ว ไม่มีส่วนใดของเนื้อหาไฟล์เดินทางไปยังเซิร์ฟเวอร์เลย ตัวหน้าเว็บเองโหลดมาจากเซิร์ฟเวอร์ (HTML, JavaScript หรืออาจมี WebAssembly module) หลังจากนั้น ไฟล์ของคุณเข้าสู่หน่วยความจำของเบราว์เซอร์และอยู่ที่นั่นจนกว่าคุณจะปิดแท็บ
เครื่องมือหนึ่ง ไม่ใช่ client-side หากมัน:
- POSTs ไฟล์ไปยัง endpoint
/api/... - ส่ง thumbnail หรือ preview ไปยังเซิร์ฟเวอร์
- เรียก analytics endpoint พร้อม file metadata (dimensions, name, hash)
- ส่งไฟล์ผ่าน CDN ของบุคคลที่สามซึ่งคืน URL ที่ประมวลผลแล้วกลับมา
แผง network ใน devtools ของเบราว์เซอร์คือผู้บอกความจริง เปิดมันขึ้นมา วางไฟล์ลงไป แล้วตรวจสอบว่ามีอะไรถูกอัปโหลดบ้าง หากคุณเห็นชื่อไฟล์หรือขนาดไฟล์ของคุณถูกส่งออกไป เครื่องมือนั้นไม่ได้เป็นส่วนตัวอย่างที่อ้าง
ทำไมสิ่งนี้จึงสำคัญในทางปฏิบัติ
คนสามกลุ่มได้รับประโยชน์อย่างเงียบ ๆ เมื่อการประมวลผลภาพย้ายมาอยู่ในเบราว์เซอร์
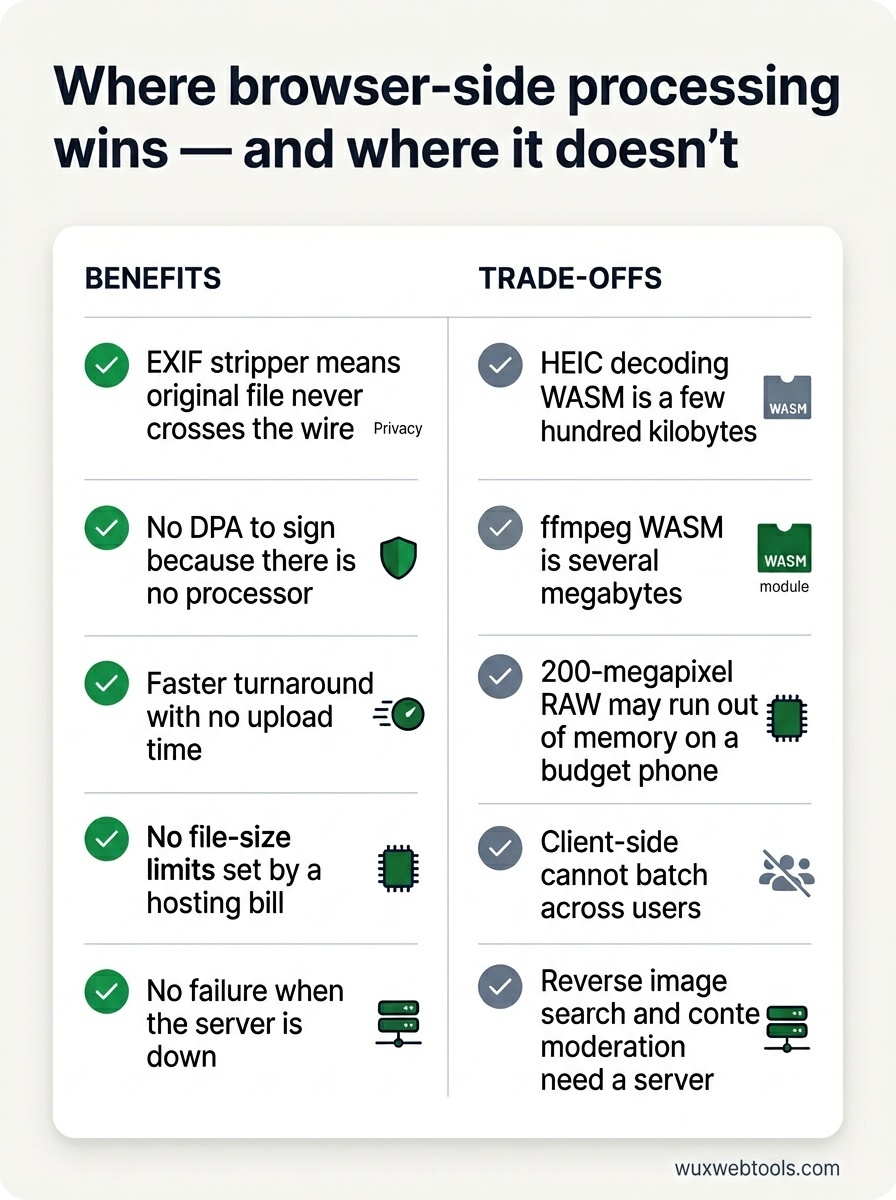
นักข่าว นักกิจกรรม และนักวิจัย จัดการกับต้นฉบับที่อาจเป็นอันตรายหากรั่วไหล EXIF metadata อาจมีพิกัด GPS จากอุปกรณ์ที่ถ่ายภาพนั้น เครื่องมือลบ EXIF ฝั่งเบราว์เซอร์หมายความว่าไฟล์ต้นฉบับไม่เคยข้ามเครือข่ายออกไป
บริษัทที่อยู่ภายใต้กฎระเบียบ — สาธารณสุข การเงิน กฎหมาย — มิฉะนั้นจะต้องมีข้อตกลงการประมวลผลข้อมูลกับผู้ที่ดำเนินการเครื่องมือนั้น หน้าเว็บแบบ static ที่ทำงานในเครื่องไม่มี DPA ให้ลงนาม เพราะไม่มีผู้ประมวลผลข้อมูล
คนอื่น ๆ ทุกคน ได้ประโยชน์ที่เห็นได้ชัด: ทำงานเสร็จเร็วขึ้น (ไม่ต้องรออัปโหลด), ไม่มีขีดจำกัดขนาดไฟล์ที่ถูกกำหนดโดยค่า hosting, ไม่ล้มเหลวเมื่อเซิร์ฟเวอร์ล่ม
จุดที่ข้อแลกเปลี่ยนยังคงมีอยู่
Client-side ไม่ใช่เวทมนตร์ มีต้นทุนจริงที่คุณควรคิดให้รอบคอบก่อนเลือกใช้กับปัญหาใดปัญหาหนึ่ง
Cold start หนักกว่า
WebAssembly bundle สำหรับถอดรหัส HEIC มีขนาดไม่กี่ร้อยกิโลไบต์ ffmpeg ที่คอมไพล์เป็น WASM มีขนาดหลายเมกะไบต์ การเข้าชมครั้งแรกต้องจ่ายต้นทุนนี้ Caching ช่วยได้ และ code-splitting ช่วยได้มากกว่า — โหลดเฉพาะ codec ที่ผู้ใช้เลือกจริง ๆ เท่านั้น
ฮาร์ดแวร์ของผู้ใช้เป็นตัวกำหนดเพดาน
ไฟล์ RAW ขนาด 200 เมกะพิกเซลจะทำให้หน่วยความจำของโทรศัพท์ราคาประหยัดหมดไปนานก่อนที่จะเกิดขึ้นบนเซิร์ฟเวอร์ UI ควรบอกอย่างตรงไปตรงมาว่าอะไรที่เป็นไปได้จริงบนอุปกรณ์นั้น
คุณไม่สามารถ batch ข้ามผู้ใช้ได้
การประมวลผลฝั่งเซิร์ฟเวอร์สามารถ deduplicate และ amortise ได้ หากผู้ใช้หนึ่งล้านคนแปลงภาพ stock เดียวกัน เซิร์ฟเวอร์สามารถประมวลผลเพียงครั้งเดียว Client-side ทำงานนั้นหนึ่งล้านครั้ง สำหรับ workload ของเครื่องมือส่วนบุคคลส่วนใหญ่ นี่ไม่ใช่ปัญหา — งานมักมีความเฉพาะตัวอยู่แล้ว — แต่ก็ควรรู้ไว้
งานบางอย่างต้องมีเซิร์ฟเวอร์
Reverse image search ต้องมี index การดูแลเนื้อหาต้องใช้ model ที่ใหญ่เกินกว่าจะส่งไปยังผู้ใช้ได้ อะไรก็ตามที่เปรียบเทียบไฟล์ของคุณกับ corpus ที่คุณไม่ได้เป็นเจ้าของจำเป็นต้องมี backend
ประเด็นด้านจริยธรรมเล็กน้อย
หากเครื่องมือของคุณเป็น client-side อย่างแท้จริง จงพูดให้ชัดและพิสูจน์ให้เห็น ลิงก์ไปยัง source ชี้ไปที่แผง network อธิบายว่าอะไรทำงานที่ไหน วลีอย่าง "เราไม่จัดเก็บข้อมูลของคุณ" ไม่มีความหมายหากไม่มีสถาปัตยกรรมรองรับ — เครื่องมือฝั่งเซิร์ฟเวอร์ทุกตัวที่เคยทำข้อมูลลูกค้ารั่วไหลก็พูดเช่นนั้นเหมือนกัน และในเวลานั้นก็หมายความตามนั้นจริง ๆ
ในทางกลับกันก็เช่นกัน หากเครื่องมือของคุณ เป็น server-side อย่าแสร้งว่าไม่ใช่ ผู้ใช้เริ่มจดจำรูปแบบนี้ได้แล้ว และเมื่อพวกเขาจับได้ ความเสียหายต่อความไว้วางใจจะถาวร
<!-- tool-cta:start -->
💡 ลองใช้สิ่งนี้: ดูการประมวลผลฝั่งไคลเอนต์ทำงานจริงด้วย Image Compressor ซึ่งย่อรูปภาพทั้งหมดในเบราว์เซอร์ของคุณเพื่อไม่ให้มีสิ่งใดถูกอัปโหลดไปยังเซิร์ฟเวอร์เลย
<!-- tool-cta:end -->
จะไปต่อจากตรงนี้อย่างไร
หากคุณกำลังสร้างเครื่องมือภาพขนาดเล็กในวันนี้ ให้เริ่มต้นที่ client-side และใช้เซิร์ฟเวอร์ก็ต่อเมื่อคุณมีเหตุผลที่เป็นรูปธรรมเท่านั้น เบราว์เซอร์จะทำให้คุณประหลาดใจว่ามันรับภาระงานได้ไกลเพียงใด — และผู้คนที่อยู่อีกปลายหนึ่งของการเชื่อมต่อเครือข่ายจะขอบคุณคุณอย่างเงียบ ๆ สำหรับ bytes ที่ไม่เคยออกจากเครื่องของพวกเขา

คำถามที่พบบ่อย
การประมวลผลแบบ client-side เป็นส่วนตัวมากกว่า server-side เสมอหรือไม่?
แล้วทำไมเครื่องมือทั้งหมดไม่ทำงานแบบนี้?
WebAssembly ทำให้คอมพิวเตอร์ของฉันช้าลงหรือไม่?
แล้วไฟล์ขนาดใหญ่มากล่ะ?
แหล่งข้อมูล & การอ่านเพิ่มเติม