ब्राउज़र में इमेज प्रोसेसिंग गोपनीयता के लिए क्यों फायदेमंद है
आधुनिक web APIs आपको सचमुच निजी इमेज टूल बनाने देती हैं — और इसका उन्हें इस्तेमाल करने वाले लोगों के लिए क्या अर्थ है।
 The Wux Webtools Team
1 मिनट पढ़ें
सामग्री की तालिका
डिफ़ॉल्ट अपेक्षा गलत है
पिछले बीस वर्षों के अधिकांश समय में, वेब पर किसी इमेज के साथ कुछ भी गैर-तुच्छ करने का मतलब था उसे सर्वर पर अपलोड करना। HEIC फोटो कन्वर्ट करना, उसका EXIF metadata हटाना, favicon बनाना — ऐसे हर टूल ऐतिहासिक रूप से multipart form के पीछे रहते थे। यूज़र ने अपलोड पर क्लिक किया, फ़ाइल सार्वजनिक इंटरनेट के पार गई, और कहीं एक सर्वर ने काम किया।
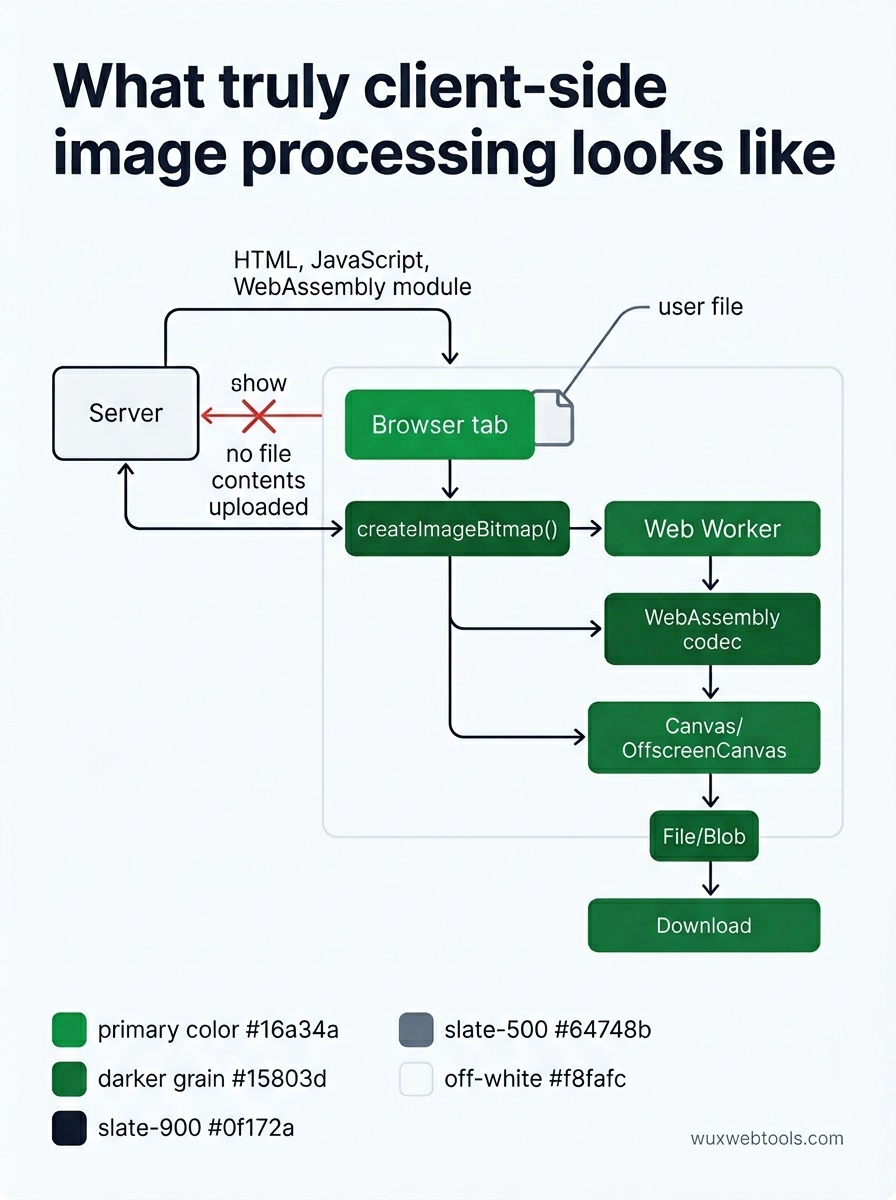
यह डिफ़ॉल्ट अब तकनीकी रूप से आवश्यक नहीं है। ब्राउज़रों ने वर्षों पहले ऐसे APIs शिप किए थे जो पूरी पाइपलाइन को स्थानीय रूप से चला सकते हैं:
<canvas>औरOffscreenCanvasपिक्सेल-स्तर के काम के लिएcreateImageBitmap()तेज़, off-thread decoding के लिएFileऔरBlobअपलोड को कहीं भेजे बिना पढ़ने के लिए- WebAssembly libheif, libwebp और ffmpeg जैसी लाइब्रेरी के लिए
- Web Workers भारी काम चलते समय UI को responsive रखने के लिए
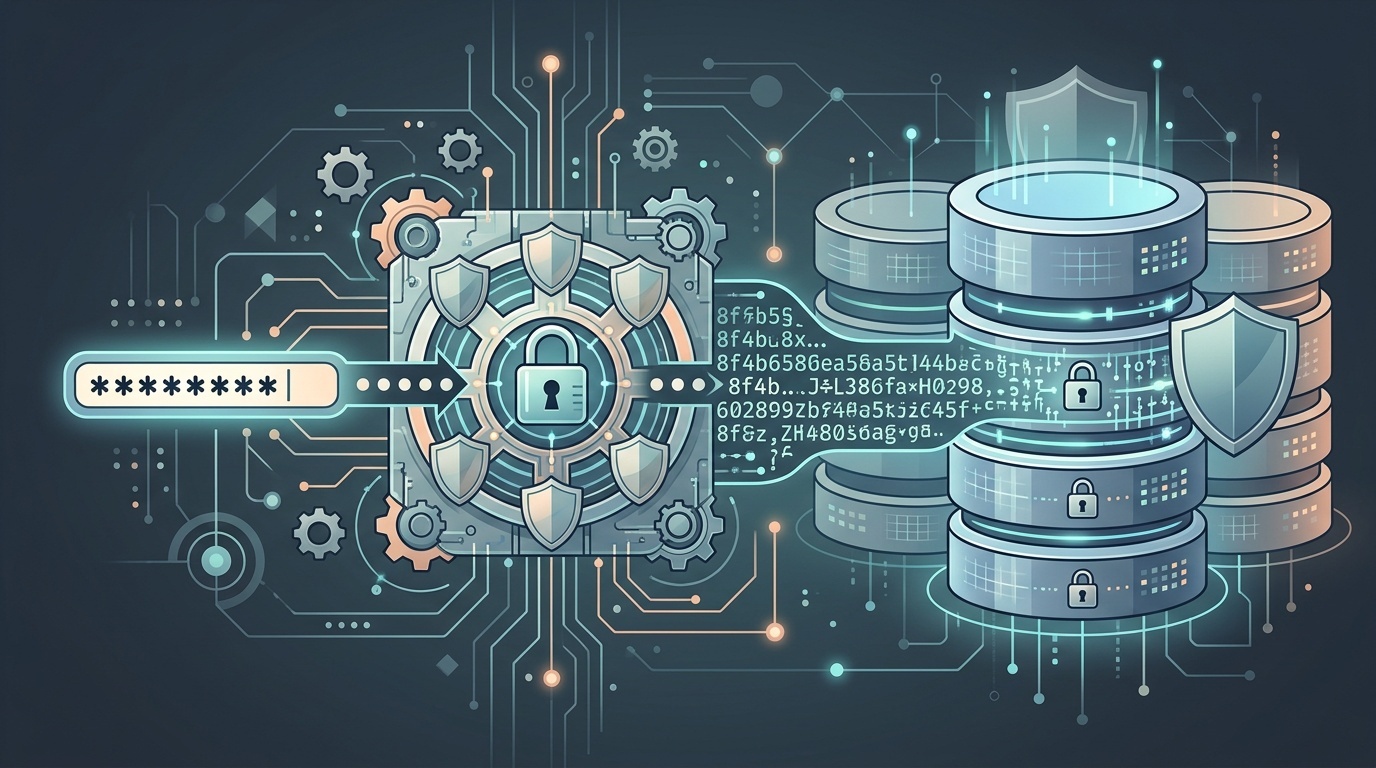
अगर आप इन्हें साथ जोड़ दें, तो फ़ाइल डिवाइस से कभी बाहर नहीं जाती। सर्वर उसे कभी नहीं देखता। लॉग करने के लिए कुछ नहीं, लीक करने के लिए कुछ नहीं, subpoena करने के लिए कुछ नहीं।
"क्लाइंट-साइड" का असल अर्थ क्या है
सटीक होना ज़रूरी है, क्योंकि बहुत से "private" टूल्स की marketing copy ढीली होती है।
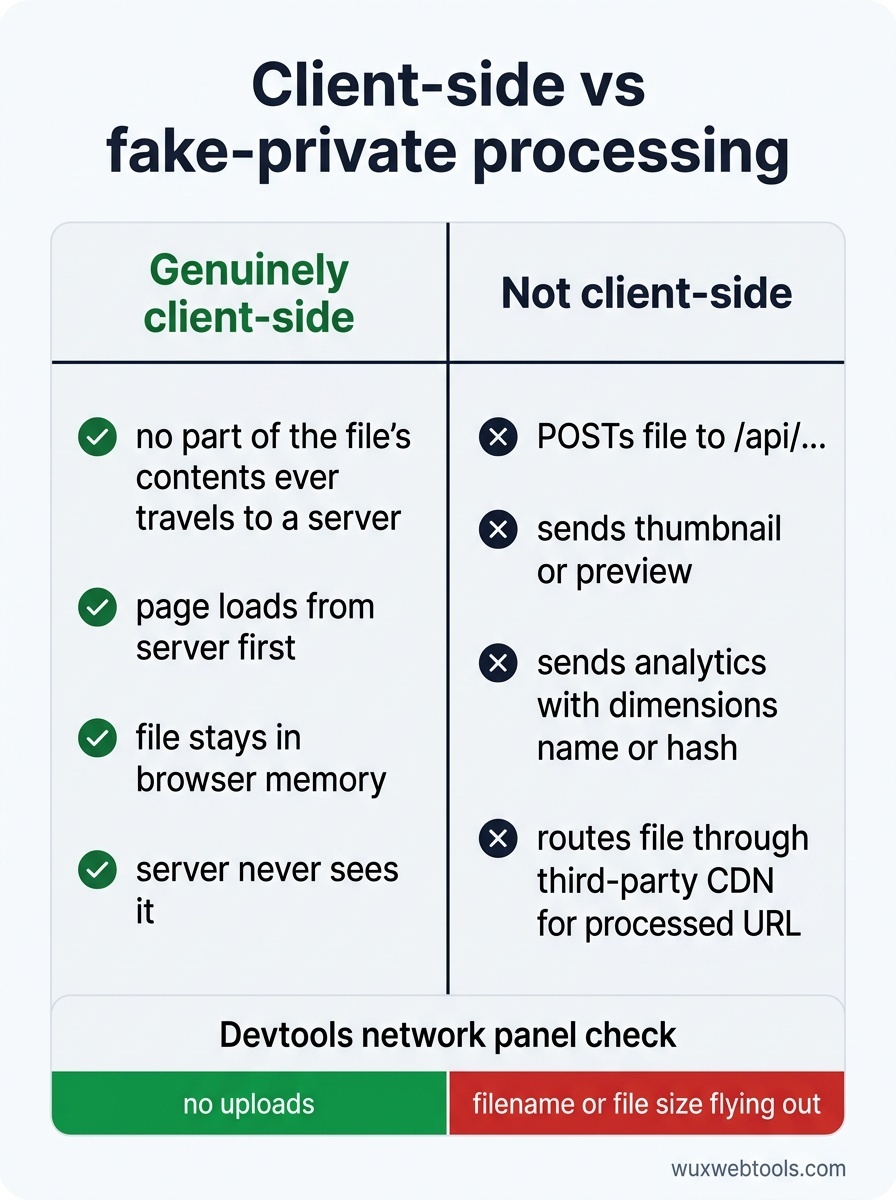
कोई टूल सचमुच क्लाइंट-साइड तब होता है जब पेज लोड होने के बाद फ़ाइल की सामग्री का कोई भी हिस्सा कभी सर्वर तक नहीं जाता। पेज खुद सर्वर से लोड होता है (HTML, JavaScript, शायद कोई WebAssembly module)। उसके बाद आपकी फ़ाइल ब्राउज़र की memory में जाती है और टैब बंद करने तक वहीं रहती है।
कोई टूल क्लाइंट-साइड नहीं है अगर वह:
- फ़ाइल को किसी
/api/...endpoint पर POST करता है - thumbnail या preview सर्वर को भेजता है
- फ़ाइल metadata (dimensions, नाम, hash) के साथ analytics endpoint कॉल करता है
- फ़ाइल को किसी third-party CDN से होकर route करता है जो processed URL लौटाता है
आपके ब्राउज़र के devtools में network panel सच बताने वाला है। उसे खोलें, कोई फ़ाइल डालें, और देखें कि क्या upload होता है। अगर आपको अपना filename या file size बाहर जाता दिखे, तो टूल उतना private नहीं है जितना दावा करता है।
व्यवहार में यह क्यों मायने रखता है
जब इमेज प्रोसेसिंग ब्राउज़र में चली जाती है, तो लोगों के तीन समूह चुपचाप लाभ पाते हैं।
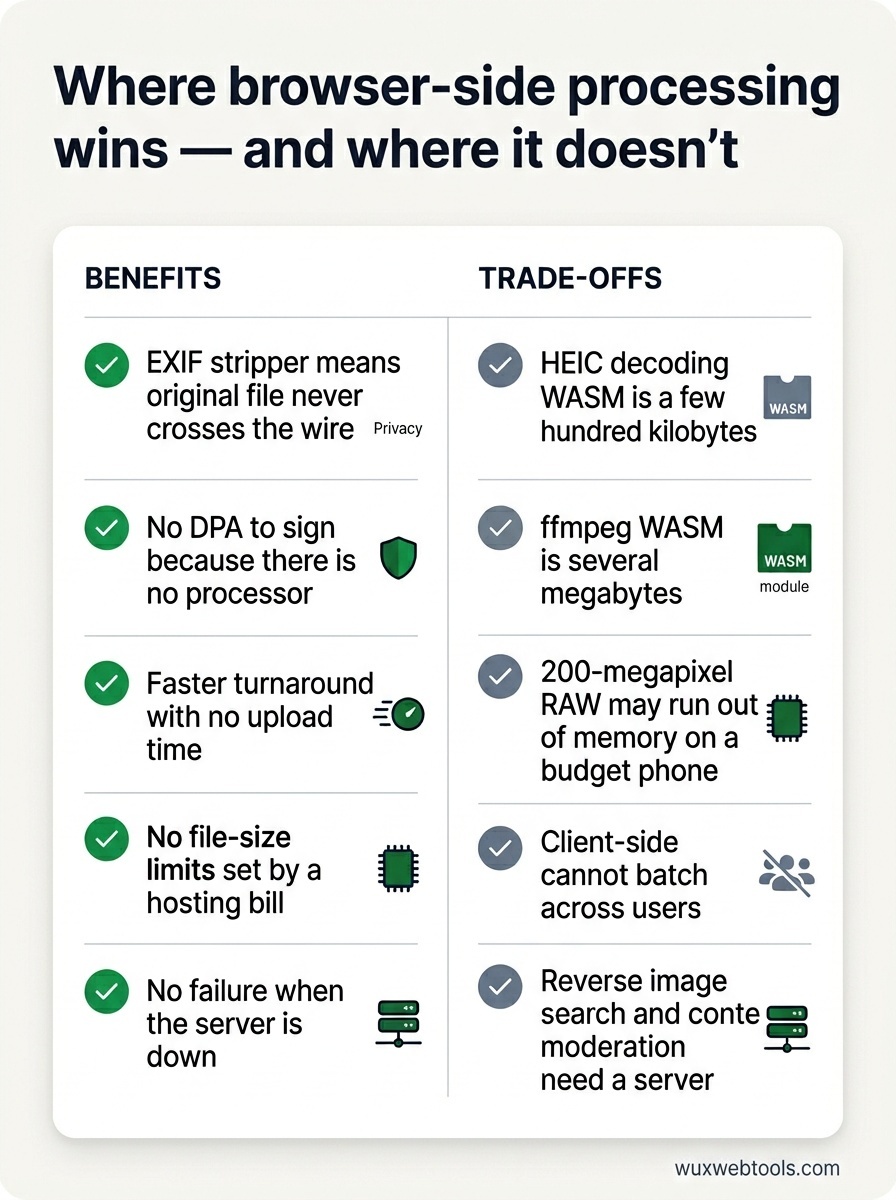
पत्रकार, कार्यकर्ता और शोधकर्ता ऐसी source material संभालते हैं जिसका लीक होना खतरनाक हो सकता है। EXIF metadata में उस डिवाइस के GPS coordinates शामिल हो सकते हैं जिससे फोटो ली गई थी। ब्राउज़र-साइड EXIF stripper का मतलब है कि original file कभी नेटवर्क पार नहीं करती।
नियमन के अधीन कंपनियाँ — healthcare, finance, legal — अन्यथा टूल चलाने वाले के साथ data-processing agreement करने की आवश्यकता रखतीं। स्थानीय रूप से काम करने वाले static page के लिए sign करने को कोई DPA नहीं होता क्योंकि कोई processor ही नहीं है।
बाकी सभी को स्पष्ट लाभ मिलते हैं: तेज़ turnaround (upload time नहीं), hosting bill से तय file-size limits नहीं, server down होने पर failure नहीं।
समझौते अब भी कहाँ मौजूद हैं
क्लाइंट-साइड कोई जादू नहीं है। किसी दिए गए समस्या के लिए इसे चुनने से पहले आपको वास्तविक लागतों पर विचार करना चाहिए।
Cold start भारी होता है
HEIC decoding के लिए WebAssembly bundle कुछ सौ kilobytes का होता है। WASM में compiled ffmpeg कई megabytes का होता है। पहली visit वह लागत चुकाती है। Caching मदद करती है, और code-splitting और भी मदद करता है — केवल वही codec load करें जिसे यूज़र ने वास्तव में चुना है।
यूज़र का hardware सीमा तय करता है
200-megapixel RAW file किसी budget phone पर memory से बहुत पहले बाहर हो जाएगी, जबकि server पर ऐसा नहीं होगा। UI में ईमानदारी से बताइए कि device पर क्या realistic है।
आप users के बीच batch नहीं कर सकते
Server-side processing deduplicate और amortise कर सकती है। अगर दस लाख users वही stock image convert करते हैं, तो server उसे एक बार process कर सकता है। Client-side इसे दस लाख बार करता है। ज़्यादातर personal-tool workloads के लिए यह ठीक है — काम वैसे भी unique होता है — लेकिन यह जानना ज़रूरी है।
कुछ operations को server चाहिए
Reverse image search को index चाहिए। Content moderation को ऐसा model चाहिए जो ship करने के लिए बहुत बड़ा है। ऐसी कोई भी चीज़ जो आपकी फ़ाइल की तुलना ऐसे corpus से करती है जिसका मालिकाना हक़ आपका नहीं है, उसे backend चाहिए।
एक छोटा ethical point
अगर आपका टूल सचमुच क्लाइंट-साइड है, तो इसे ज़ोर से कहें और साबित करें। Source से link करें, network panel की ओर इशारा करें, समझाएँ कि क्या कहाँ चलता है। "हम आपका data store नहीं करते" जैसे वाक्य architecture के बिना कुछ नहीं कहते — हर server-side tool जिसने कभी customer data leak किया, उसने भी ठीक यही कहा था, और उस समय उसका यही मतलब था।
इसका उलटा भी सच है। अगर आपका टूल server-side है, तो अन्यथा pretend न करें। Users pattern को पहचानना सीख चुके हैं, और जब वे आपको पकड़ते हैं तो trust पर लगा धक्का स्थायी होता है।
<!-- tool-cta:start -->
💡 इसे आज़माएँ: Image Compressor के साथ क्लाइंट-साइड प्रोसेसिंग को काम करते देखें, जो आपके ब्राउज़र में ही छवियों को छोटा करता है ताकि कुछ भी कभी सर्वर पर अपलोड न हो।
<!-- tool-cta:end -->
यहाँ से आगे कहाँ जाएँ
अगर आप आज कोई छोटा image utility बना रहे हैं, तो default रूप से client-side चुनें और server तक तभी जाएँ जब आपके पास कोई ठोस कारण हो। ब्राउज़र आपको चौंका देगा कि वह काम को कितनी दूर तक ले जा सकता है — और network connection के दूसरे छोर पर मौजूद लोग उन bytes के लिए चुपचाप आपका धन्यवाद करेंगे जो उनकी machine से कभी बाहर नहीं गए।
अक्सर पूछे जाने वाले प्रश्न
क्या client-side processing हमेशा server-side से अधिक private होती है?
तो सभी tools इसी तरह काम क्यों नहीं करते?
क्या WebAssembly मेरे computer को slow कर देता है?
बहुत बड़ी files का क्या?
स्रोत और आगे की पढ़ाई