Miért adatvédelmi előny a képfeldolgozás a böngészőben
Hogyan teszik lehetővé a modern webes API-k valóban privát képeszközök építését — és mit jelent ez azoknak, akik használják őket.
 The Wux Webtools Team
6 min olvasás
Tartalomjegyzék
- Az alapértelmezett elvárás téves
- Mit jelent valójában a "kliensoldali"
- Miért számít ez a gyakorlatban
- Hol maradnak meg a kompromisszumok
- A hidegindítás nehezebb
- A felhasználó hardvere szabja meg a plafont
- Nem lehet felhasználók között kötegelni
- Egyes műveletekhez szerver kell
- Egy kis etikai megjegyzés
- Merre tovább
Az alapértelmezett elvárás téves
Az elmúlt húsz év nagy részében, ha valaki bármi nem triviálisat akart csinálni egy képpel a weben, fel kellett töltenie egy szerverre. HEIC-fotó konvertálása, EXIF-metaadatok eltávolítása, favicon generálása — ezek az eszközök történetileg mind egy multipart űrlap mögött éltek. A felhasználó rákattintott a feltöltésre, a fájl átutazott a nyilvános interneten, és valahol egy szerver elvégezte a munkát.
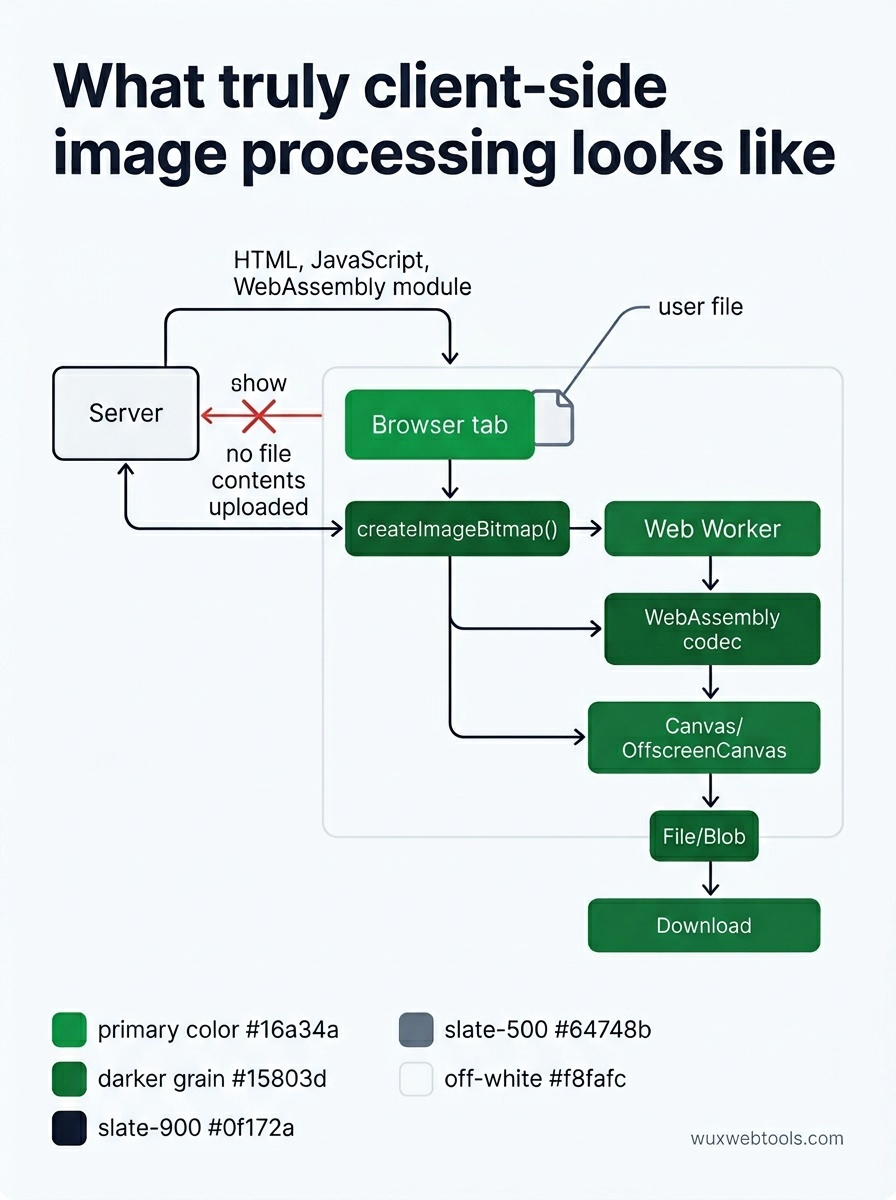
Ez az alapértelmezés technikailag már nem szükségszerű. A böngészők évekkel ezelőtt olyan API-kat kaptak, amelyekkel a teljes folyamat helyben futtatható:
<canvas>andOffscreenCanvaspixelszintű munkáhozcreateImageBitmap()gyors, fő szálon kívüli dekódoláshozFileandBlobfeltöltött fájlok olvasásához anélkül, hogy bárhová elküldenénk őket- WebAssembly olyan könyvtárakhoz, mint a libheif, a libwebp és az ffmpeg
- Web Workers hogy a felület reszponzív maradjon, miközben nehéz műveletek futnak
Ha ezeket összekapcsolja, a fájl soha nem hagyja el az eszközt. A szerver soha nem látja. Nincs mit naplózni, nincs minek kiszivárognia, nincs mit bírósági idézéssel bekérni.
Mit jelent valójában a "kliensoldali"
Érdemes pontosnak lenni, mert sok "privát" eszköz marketingnyelve laza.
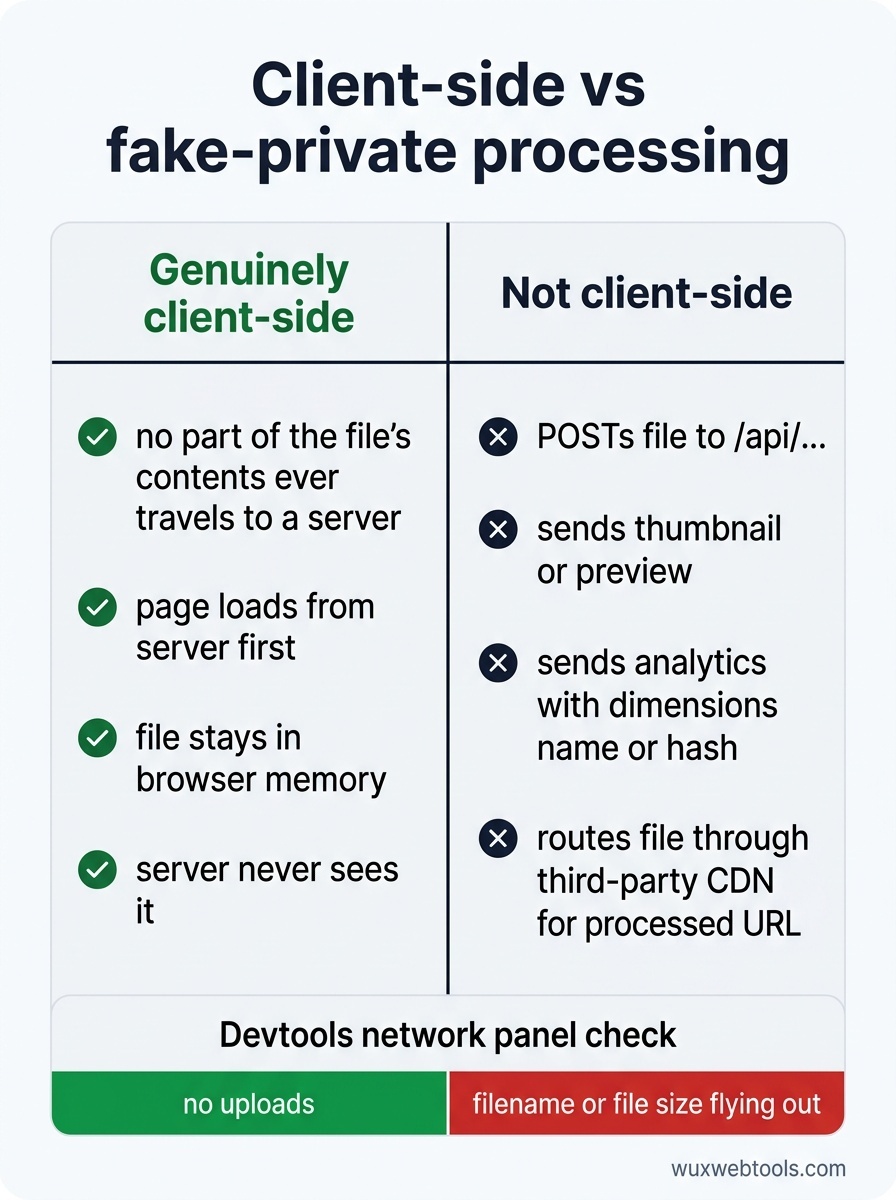
Egy eszköz akkor valóban kliensoldali, ha az oldal betöltése után a fájl tartalmának egyetlen része sem jut el szerverre. Maga az oldal szerverről töltődik be (HTML, JavaScript, esetleg egy WebAssembly modul). Ezután a fájl a böngésző memóriájába kerül, és ott marad, amíg be nem zárja a lapot.
Egy eszköz nem kliensoldali, ha:
- POST kéréssel elküldi a fájlt egy
/api/...végpontra - Miniatűrt vagy előnézetet küld egy szerverre
- Elemzési végpontot hív fájlmetaadatokkal (méret, név, hash)
- Egy harmadik féltől származó CDN-en keresztül irányítja a fájlt, amely feldolgozott URL-t ad vissza
A böngésző fejlesztői eszközeiben a hálózati panel mondja meg az igazat. Nyissa meg, dobjon be egy fájlt, és nézze meg, mi kerül feltöltésre. Ha azt látja, hogy a fájlnév vagy a fájlméret kifelé utazik, az eszköz nem olyan privát, mint állítja.
Miért számít ez a gyakorlatban
Három csoport csendben sokat nyer abból, ha a képfeldolgozás a böngészőbe költözik.
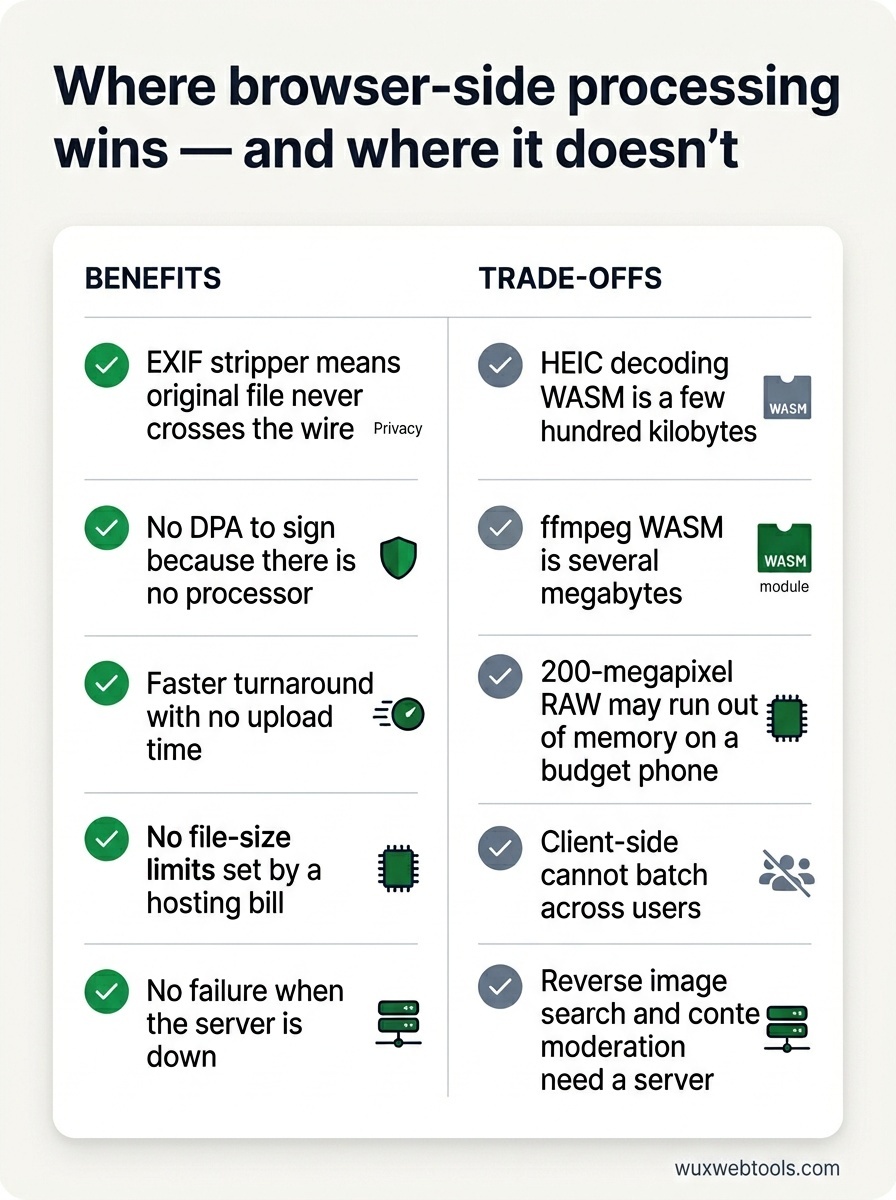
Újságírók, aktivisták és kutatók olyan forrásanyagokkal dolgoznak, amelyek kiszivárgása veszélyes lehet. Az EXIF-metaadatok tartalmazhatják annak az eszköznek a GPS-koordinátáit, amellyel a fotó készült. Egy böngészőoldali EXIF-eltávolító azt jelenti, hogy az eredeti fájl soha nem megy át a hálózaton.
Szabályozás alatt álló vállalatoknak — egészségügy, pénzügy, jog — különben adatfeldolgozási megállapodásra lenne szükségük azzal, aki az eszközt üzemelteti. Egy statikus oldal, amely helyben végzi a munkát, nem igényel aláírandó DPA-t, mert nincs adatfeldolgozó.
Mindenki más megkapja a nyilvánvaló előnyöket: gyorsabb átfutás (nincs feltöltési idő), nincsenek tárhelyszámla által diktált fájlméret-korlátok, és nincs hiba csak azért, mert a szerver éppen leállt.
Hol maradnak meg a kompromisszumok
A kliensoldali működés nem varázslat. Valódi költségei vannak, amelyeket érdemes végiggondolni, mielőtt egy adott problémára ezt választja.
A hidegindítás nehezebb
Egy HEIC-dekódoláshoz használt WebAssembly csomag néhány száz kilobájt. A WASM-re fordított ffmpeg több megabájt. Az első látogatás megfizeti ezt a költséget. A gyorsítótárazás segít, a kódfelosztás pedig még többet — csak azt a kodeket töltse be, amelyet a felhasználó ténylegesen kiválasztott.
A felhasználó hardvere szabja meg a plafont
Egy 200 megapixeles RAW fájl egy olcsó telefonon jóval előbb kifut a memóriából, mint egy szerveren. Legyen őszinte a felületen azzal kapcsolatban, mi reális az adott eszközön.
Nem lehet felhasználók között kötegelni
A szerveroldali feldolgozás képes deduplikálni és szétteríteni a költségeket. Ha egymillió felhasználó ugyanazt a stockfotót konvertálja, egy szerver egyszer is feldolgozhatja. Kliensoldalon ez egymilliószor történik meg. A legtöbb személyes eszköz jellegű terhelésnél ez rendben van — a munka úgyis egyedi —, de érdemes tudni róla.
Egyes műveletekhez szerver kell
A fordított képkereséshez indexre van szükség. A tartalommoderáláshoz olyan modell kell, amely túl nagy ahhoz, hogy kiszállítsuk. Bármi, ami a fájlt egy nem Ön által birtokolt korpuszhoz hasonlítja, backendet igényel.
Egy kis etikai megjegyzés
Ha az eszköze valóban kliensoldali, mondja ki hangosan, és bizonyítsa is. Hivatkozzon a forrásra, mutasson rá a hálózati panelre, magyarázza el, mi hol fut. Az olyan kifejezések, mint hogy "nem tároljuk az adatait", semmit sem jelentenek olyan architektúra nélkül, amely ezt alátámasztja — minden szerveroldali eszköz, amelyből valaha ügyféladat szivárgott ki, pontosan ugyanezt mondta, és akkor komolyan is gondolta.
Az ellenkezője is igaz. Ha az eszköze szerveroldali, ne tegyen úgy, mintha nem az lenne. A felhasználók megtanulták felismerni ezt a mintát, és ha rajtakapják, a bizalmi veszteség tartós lesz.
<!-- tool-cta:start -->
💡 Próbálja ki ezt: Nézze meg a kliensoldali feldolgozást működés közben az Image Compressor segítségével, amely teljes egészében a böngészőjében kicsinyíti a képeket, így soha semmi nem kerül feltöltésre szerverre.
<!-- tool-cta:end -->
Merre tovább
Ha ma egy kis képes segédeszközt épít, alapértelmezésként válassza a kliensoldali működést, és csak akkor nyúljon szerverhez, ha konkrét oka van rá. A böngésző meg fogja lepni azzal, milyen messzire elviszi a munkát — a hálózati kapcsolat másik végén lévő emberek pedig csendben hálásak lesznek azokért a bájtokért, amelyek soha nem hagyták el a gépüket.
Gyakran ismételt kérdések
A kliensoldali feldolgozás mindig privátabb, mint a szerveroldali?
Akkor miért nem működik minden eszköz így?
A WebAssembly lelassítja a számítógépemet?
Mi a helyzet a nagyon nagy fájlokkal?
Források és további olvasmányok