Vì sao xử lý hình ảnh trong trình duyệt là một lợi thế về quyền riêng tư
Cách các API web hiện đại cho phép bạn xây dựng những công cụ hình ảnh thực sự riêng tư — và điều đó có ý nghĩa gì với những người sử dụng chúng.
 The Wux Webtools Team
9 phút đọc
Mục lục
- Kỳ vọng mặc định là sai
- "client-side" thực sự có nghĩa là gì
- Vì sao điều này quan trọng trong thực tế
- Những đánh đổi vẫn còn ở đâu
- Lần khởi động đầu nặng hơn
- Phần cứng của người dùng đặt ra giới hạn trên
- Bạn không thể xử lý theo lô giữa nhiều người dùng
- Một số thao tác cần máy chủ
- Một điểm nhỏ về đạo đức
- Nên đi tiếp từ đây như thế nào
Kỳ vọng mặc định là sai
Trong phần lớn hai mươi năm qua, làm bất kỳ việc gì không tầm thường với một hình ảnh trên web đều đồng nghĩa với việc tải nó lên máy chủ. Chuyển đổi một ảnh HEIC, loại bỏ metadata EXIF, tạo favicon — tất cả những công cụ đó trong lịch sử đều nằm sau một biểu mẫu multipart. Người dùng nhấp vào upload, tệp đi qua internet công cộng, và một máy chủ nào đó thực hiện công việc.
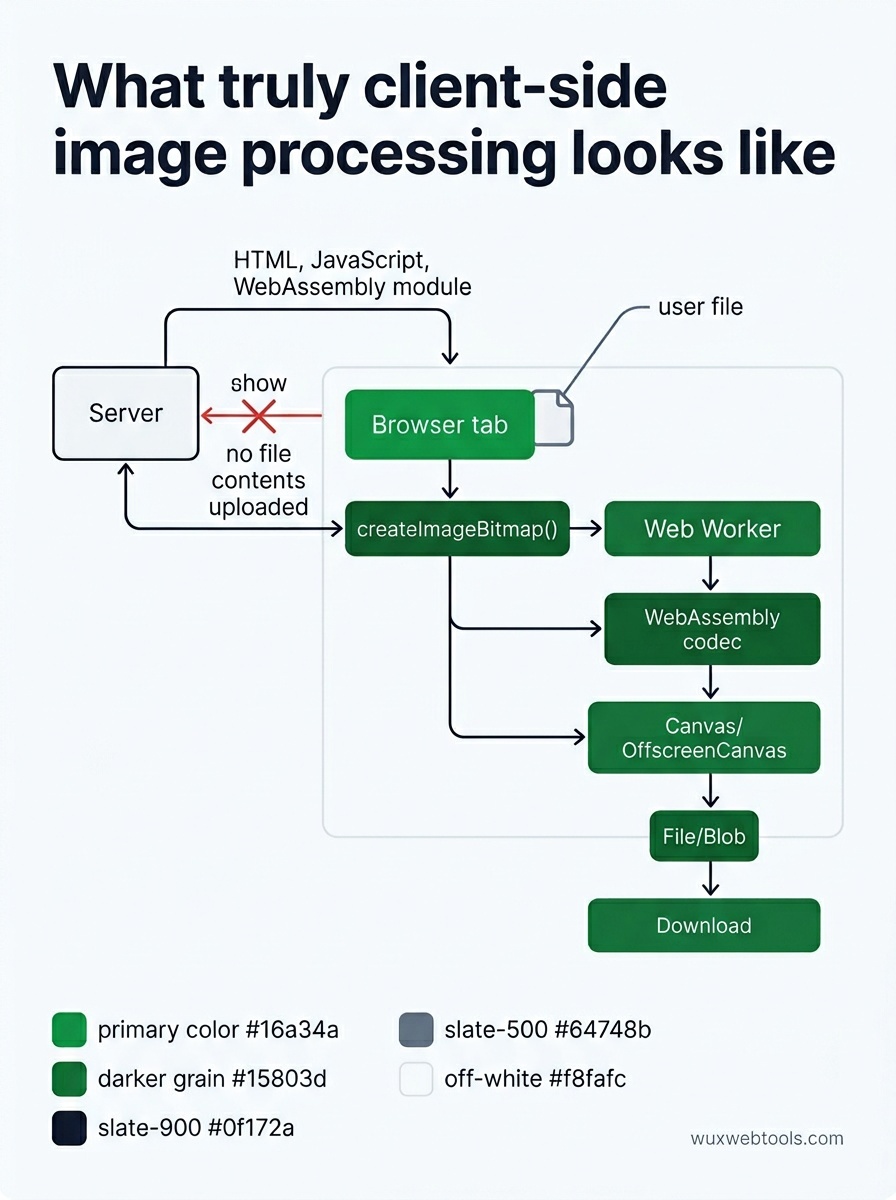
Mặc định đó không còn cần thiết về mặt kỹ thuật. Từ nhiều năm trước, trình duyệt đã cung cấp các API cho phép toàn bộ quy trình chạy cục bộ:
<canvas>vàOffscreenCanvascho công việc ở cấp độ pixelcreateImageBitmap()để giải mã nhanh, ngoài luồngFilevàBlobđể đọc tệp tải lên mà không gửi chúng đi đâu cả- WebAssembly cho các thư viện như libheif, libwebp và ffmpeg
- Web Workers để giữ UI phản hồi tốt trong khi chạy các tác vụ nặng
Nếu bạn kết hợp những phần đó lại, tệp sẽ không bao giờ rời khỏi thiết bị. Máy chủ không bao giờ nhìn thấy nó. Không có gì để ghi log, không có gì để rò rỉ, không có gì để bị trát đòi cung cấp.
"client-side" thực sự có nghĩa là gì
Cần nói cho chính xác, vì phần lời quảng bá của rất nhiều công cụ "riêng tư" thường khá lỏng lẻo.
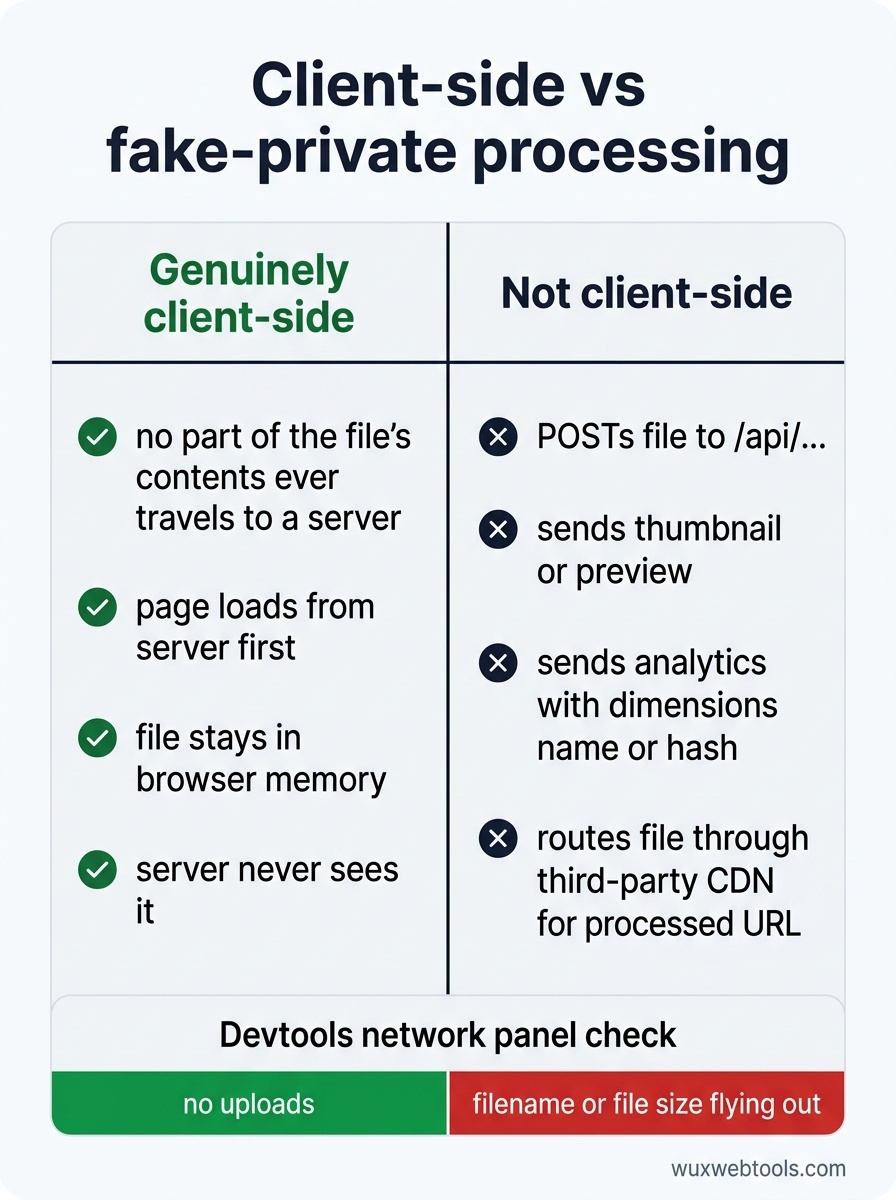
Một công cụ thực sự là client-side khi, sau khi trang được tải, không có phần nào trong nội dung của tệp từng đi tới máy chủ. Bản thân trang được tải từ máy chủ (HTML, JavaScript, có thể là một module WebAssembly). Sau đó, tệp của bạn đi vào bộ nhớ của trình duyệt và ở lại đó cho đến khi bạn đóng tab.
Một công cụ không phải là client-side nếu nó:
- POST tệp tới một endpoint
/api/... - Gửi thumbnail hoặc bản xem trước tới máy chủ
- Gọi một endpoint analytics kèm metadata của tệp (kích thước ảnh, tên, hash)
- Định tuyến tệp qua một CDN bên thứ ba rồi trả về một URL đã xử lý
Network panel trong devtools của trình duyệt là nơi nói thật. Mở nó ra, thả một tệp vào, rồi kiểm tra xem thứ gì được tải lên. Nếu bạn thấy tên tệp hoặc kích thước tệp của mình bay ra ngoài, công cụ đó không riêng tư như nó tuyên bố.
Vì sao điều này quan trọng trong thực tế
Có ba nhóm người âm thầm hưởng lợi khi việc xử lý hình ảnh chuyển vào trình duyệt.
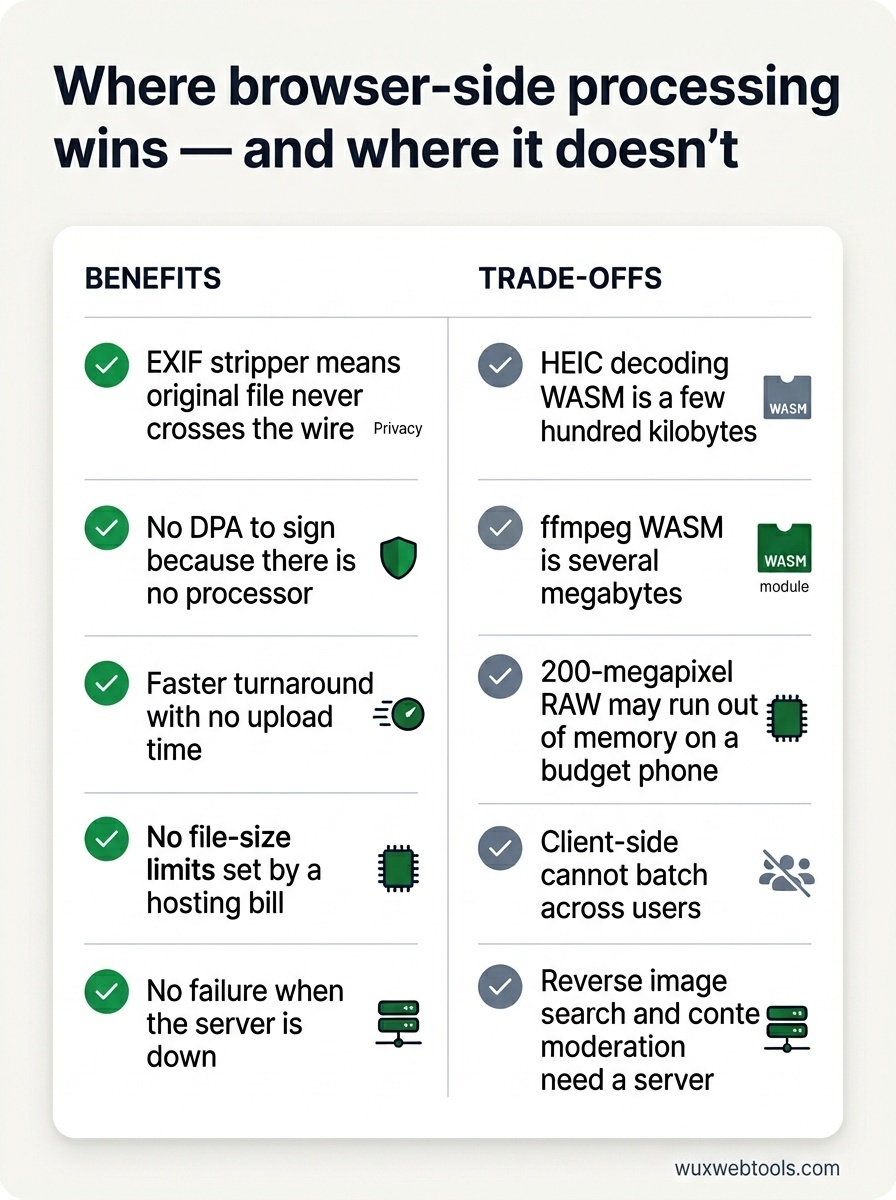
Nhà báo, nhà hoạt động và nhà nghiên cứu xử lý tư liệu nguồn có thể gây nguy hiểm nếu bị rò rỉ. Metadata EXIF có thể bao gồm tọa độ GPS từ thiết bị đã chụp ảnh. Một công cụ loại bỏ EXIF chạy trong trình duyệt nghĩa là tệp gốc không bao giờ đi qua mạng.
Các công ty chịu sự quản lý theo quy định — y tế, tài chính, pháp lý — nếu không sẽ cần một thỏa thuận xử lý dữ liệu với bên vận hành công cụ. Một trang tĩnh thực hiện công việc cục bộ không có DPA nào để ký, vì không có bên xử lý dữ liệu.
Tất cả những người còn lại nhận được các lợi ích hiển nhiên: xử lý nhanh hơn (không mất thời gian tải lên), không có giới hạn dung lượng tệp do hóa đơn hosting đặt ra, không thất bại khi máy chủ ngừng hoạt động.
Những đánh đổi vẫn còn ở đâu
Client-side không phải là phép màu. Có những chi phí thực tế bạn nên cân nhắc trước khi chọn nó cho một vấn đề cụ thể.
Lần khởi động đầu nặng hơn
Một bundle WebAssembly để giải mã HEIC có dung lượng vài trăm kilobyte. ffmpeg biên dịch sang WASM có dung lượng vài megabyte. Lần truy cập đầu tiên phải trả chi phí đó. Caching giúp ích, và code-splitting còn giúp nhiều hơn — chỉ tải codec mà người dùng thực sự chọn.
Phần cứng của người dùng đặt ra giới hạn trên
Một tệp RAW 200 megapixel sẽ hết bộ nhớ trên một điện thoại giá rẻ rất lâu trước khi điều đó xảy ra trên máy chủ. Hãy thành thật trong UI về những gì thực tế có thể làm trên thiết bị.
Bạn không thể xử lý theo lô giữa nhiều người dùng
Xử lý phía máy chủ có thể khử trùng lặp và phân bổ chi phí. Nếu một triệu người dùng chuyển đổi cùng một ảnh stock, máy chủ có thể xử lý nó một lần. Client-side làm việc đó một triệu lần. Với hầu hết khối lượng công việc của công cụ cá nhân, điều này vẫn ổn — dù sao công việc thường là duy nhất — nhưng đây là điều đáng biết.
Một số thao tác cần máy chủ
Tìm kiếm ảnh ngược cần một chỉ mục. Kiểm duyệt nội dung cần một mô hình quá lớn để gửi xuống trình duyệt. Bất cứ thứ gì so sánh tệp của bạn với một kho dữ liệu mà bạn không sở hữu đều cần backend.
Một điểm nhỏ về đạo đức
Nếu công cụ của bạn thực sự là client-side, hãy nói rõ điều đó và chứng minh nó. Liên kết tới mã nguồn, chỉ vào network panel, giải thích phần nào chạy ở đâu. Những cụm từ như "chúng tôi không lưu trữ dữ liệu của bạn" chẳng có ý nghĩa gì nếu không có kiến trúc để hậu thuẫn — mọi công cụ phía máy chủ từng làm rò rỉ dữ liệu khách hàng cũng từng nói chính xác như vậy, và lúc đó họ cũng thực sự tin như vậy.
Điều ngược lại cũng đúng. Nếu công cụ của bạn là server-side, đừng giả vờ khác đi. Người dùng đã học cách nhận ra mô thức này, và cú đánh vào niềm tin khi họ phát hiện ra là vĩnh viễn.
<!-- tool-cta:start -->
💡 Thử tính năng này: Xem xử lý phía máy khách hoạt động với Image Compressor, công cụ thu nhỏ hình ảnh hoàn toàn trong trình duyệt của bạn để không có gì từng được tải lên máy chủ.
<!-- tool-cta:end -->
Nên đi tiếp từ đây như thế nào
Nếu hôm nay bạn đang xây dựng một tiện ích hình ảnh nhỏ, hãy mặc định chọn client-side và chỉ dùng máy chủ khi bạn có một lý do cụ thể. Trình duyệt sẽ khiến bạn ngạc nhiên về mức độ công việc mà nó có thể gánh — và những người ở đầu bên kia của kết nối mạng sẽ âm thầm cảm ơn bạn vì những byte chưa bao giờ rời khỏi máy của họ.
Câu hỏi thường gặp
Xử lý client-side có luôn riêng tư hơn server-side không?
Vậy vì sao không phải mọi công cụ đều hoạt động theo cách này?
WebAssembly có làm máy tính của tôi chậm đi không?
Còn các tệp rất lớn thì sao?
Nguồn & tài liệu tham khảo thêm