ブラウザで画像を処理することがプライバシー面で有利な理由
現代の Web API によって、本当にプライベートな画像ツールをどのように構築できるのか。そして、それが利用者にとって何を意味するのか。
目次
デフォルトの思い込みは間違っている
この 20 年の大半において、Web 上で画像に対して少しでも本格的な処理を行うには、サーバーへアップロードする必要がありました。HEIC 写真を変換する、EXIF メタデータを削除する、favicon を生成する——そうしたツールは歴史的に、どれも multipart form の向こう側にありました。ユーザーが アップロード をクリックすると、ファイルは公共のインターネットを通って移動し、どこかのサーバーが処理を行っていたのです。
その前提は、もはや技術的には必要ありません。ブラウザには何年も前から、パイプライン全体をローカルで実行できる API が搭載されています。
<canvas>とOffscreenCanvasによるピクセル単位の処理createImageBitmap()による高速なオフスレッドデコードFileとBlobによる、どこにも送信しないアップロードファイルの読み取り- WebAssembly による libheif、libwebp、ffmpeg のようなライブラリの実行
- Web Workers による、重い処理中でも UI の応答性を保つ仕組み
これらを組み合わせれば、ファイルはデバイスから一切出ません。サーバーはファイルを見ることがありません。ログに残すものも、漏えいするものも、召喚令状の対象になるものもありません。
「クライアントサイド」が実際に意味すること
正確にしておく価値があります。多くの「プライベート」ツールのマーケティング文言は曖昧だからです。
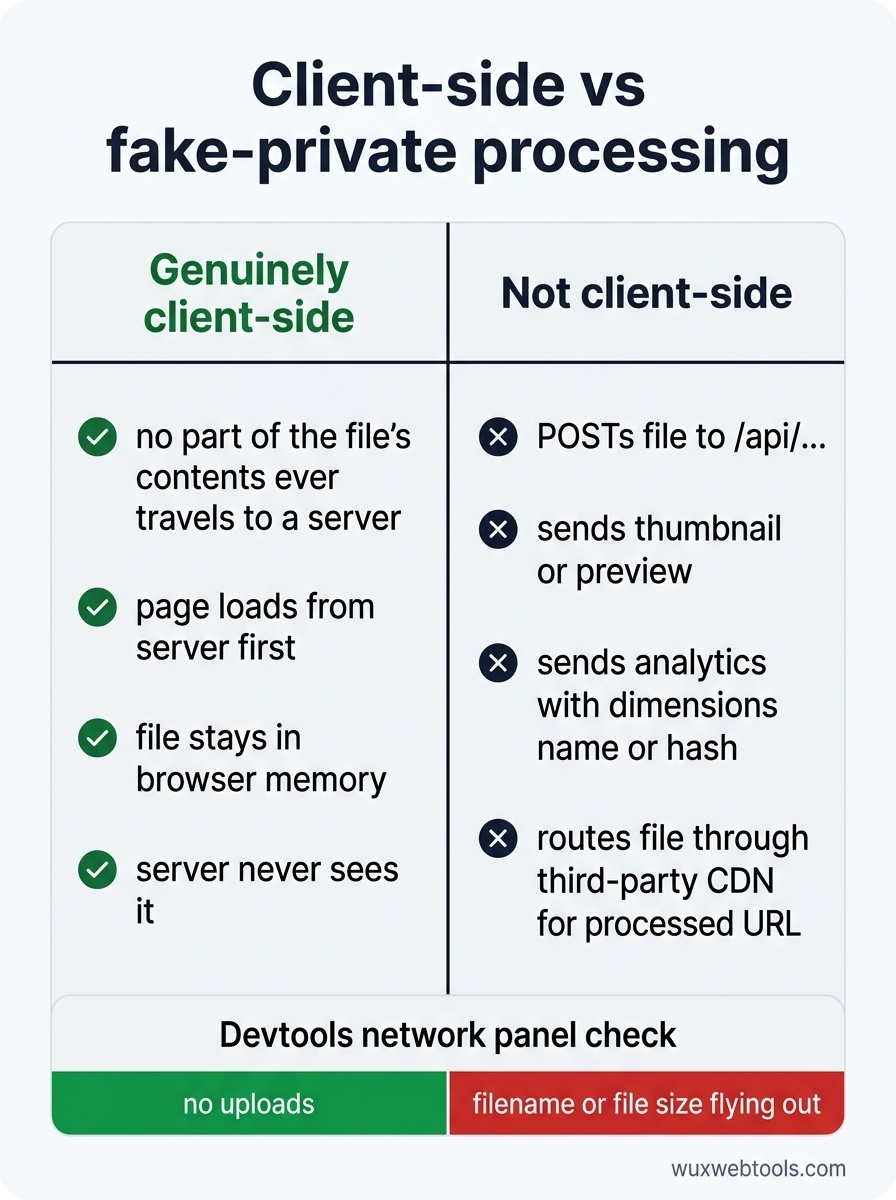
ページが読み込まれた後、ファイルの内容のどの部分もサーバーへ送られない場合、そのツールは本当にクライアントサイドだと言えます。ページ自体はサーバーから読み込まれます(HTML、JavaScript、場合によっては WebAssembly モジュール)。その後、あなたのファイルはブラウザのメモリに入り、タブを閉じるまでそこにとどまります。
次のような場合、そのツールはクライアントサイドではありません。
- ファイルを
/api/...エンドポイントへ POST する - サムネイルやプレビューをサーバーへ送る
- ファイルのメタデータ(寸法、名前、ハッシュ)を分析用エンドポイントへ送る
- ファイルをサードパーティ CDN 経由で処理し、処理済み URL を返す
ブラウザの devtools にあるネットワークパネルが、正直な判定役です。開いて、ファイルをドロップし、何がアップロードされるかを確認してください。ファイル名やファイルサイズが外へ飛んでいくのが見えるなら、そのツールは主張するほどプライベートではありません。
実務上なぜ重要なのか
画像処理がブラウザに移ると、静かに恩恵を受ける人たちが 3 つのグループに分けられます。
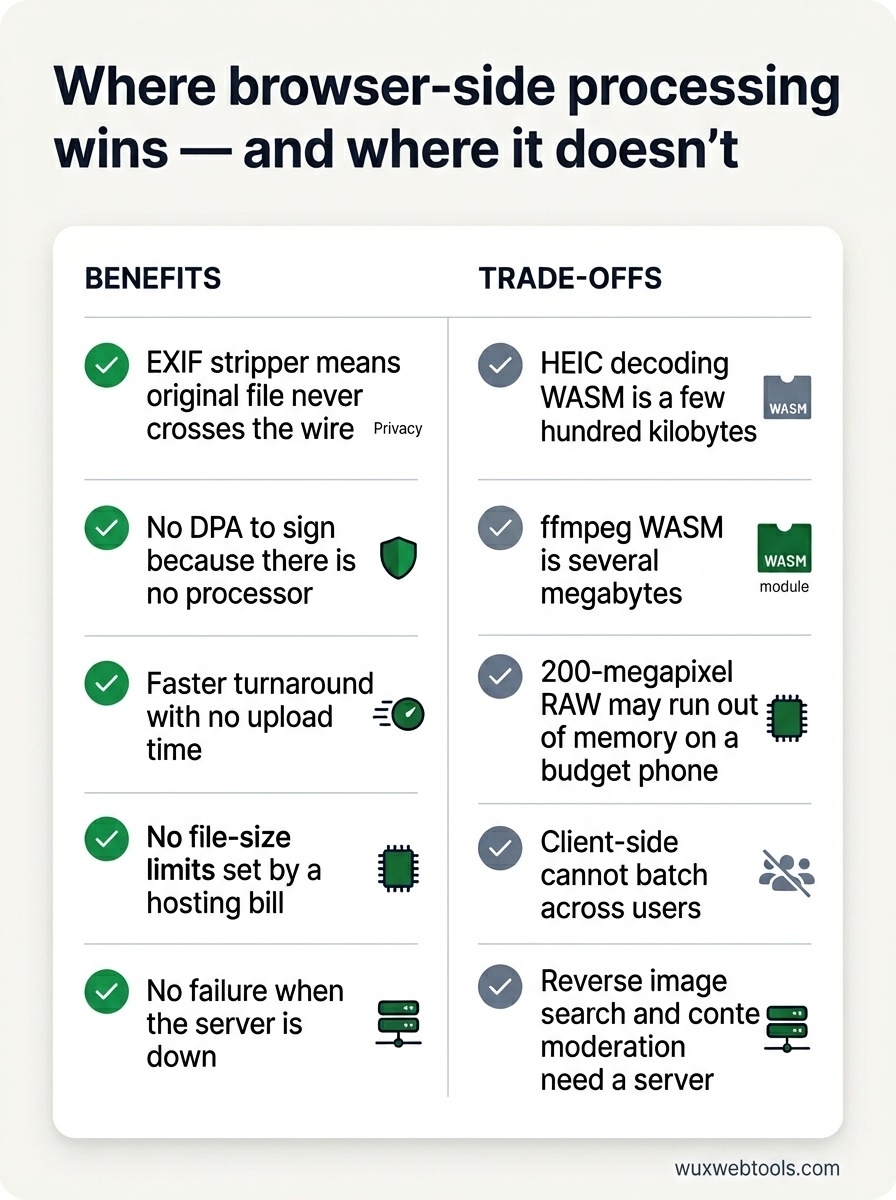
ジャーナリスト、活動家、研究者は、漏えいすれば危険な素材を扱います。EXIF メタデータには、写真を撮影したデバイス由来の GPS 座標が含まれることがあります。ブラウザ側の EXIF 削除ツールなら、元のファイルがネットワークを越えることはありません。
規制下にある企業——医療、金融、法務——は、通常であればツールの運営者とデータ処理契約を結ぶ必要があります。ローカルで処理を行う静的ページであれば、処理者が存在しないため、署名すべき DPA もありません。
それ以外のすべての人にも、明らかな利点があります。処理が速い(アップロード時間がない)、ホスティング費用によるファイルサイズ制限がない、サーバー停止時に失敗しない、といった点です。
トレードオフが残る場所
クライアントサイドは魔法ではありません。特定の問題に対してそれを選ぶ前に、考えておくべき現実的なコストがあります。
コールドスタートは重くなる
HEIC デコード用の WebAssembly バンドルは数百キロバイトあります。WASM にコンパイルされた ffmpeg は数メガバイトになります。初回訪問時にはそのコストを払うことになります。キャッシュは役立ちますし、コード分割はさらに効果的です。ユーザーが実際に選んだ codec だけを読み込めばよいのです。
上限はユーザーのハードウェアで決まる
200 メガピクセルの RAW ファイルは、サーバーでメモリが尽きるよりずっと前に、廉価なスマートフォンでメモリ不足になります。そのデバイス上で現実的に何ができるのか、UI で正直に示すべきです。
ユーザーをまたいだバッチ処理はできない
サーバーサイド処理なら、重複排除やコストの平準化ができます。100 万人のユーザーが同じストック画像を変換する場合、サーバーはそれを 1 回だけ処理できます。クライアントサイドでは 100 万回処理します。多くの個人向けツールのワークロードでは問題ありません——そもそも作業内容は固有であることが多いからです——ただし、知っておく価値はあります。
サーバーを必要とする処理もある
逆画像検索にはインデックスが必要です。コンテンツモデレーションには、配布するには大きすぎるモデルが必要です。自分が所有していないコーパスとファイルを比較する処理には、バックエンドが必要です。
小さな倫理的ポイント
あなたのツールが本当にクライアントサイドなら、はっきりそう言い、証明してください。ソースへリンクし、ネットワークパネルを示し、何がどこで動くのかを説明するのです。「私たちはあなたのデータを保存しません」のような文言は、それを裏付けるアーキテクチャがなければ何の意味もありません。顧客データを漏えいさせたサーバーサイドツールも、例外なく同じことを言っていましたし、その時点では本気でそう考えていたのです。
逆もまた同じです。あなたのツールがサーバーサイドなら、そうでないふりをしてはいけません。ユーザーはそのパターンを見分けられるようになっていますし、見破られたときに失う信頼は戻りません。
<!-- tool-cta:start -->
💡 お試しください: Image Compressorで、画像を完全にブラウザー内で縮小してサーバーには何もアップロードしないクライアント側処理の動作をご覧ください。
<!-- tool-cta:end -->
ここから先へ
今日、小さな画像ユーティリティを作るなら、まずクライアントサイドを前提にし、具体的な理由があるときだけサーバーに手を伸ばしてください。ブラウザがどれほど遠くまで処理を担えるかに、きっと驚くはずです。そしてネットワーク接続の向こう側にいる人たちは、自分のマシンから一度も出ていかなかったバイトの分だけ、静かに感謝するでしょう。

よくある質問
クライアントサイド処理は常にサーバーサイド処理よりプライベートですか?
では、なぜすべてのツールがこの方式で動かないのですか?
WebAssembly はコンピューターを遅くしますか?
非常に大きなファイルはどうなりますか?
参考文献&さらなる読み物