Warum Bildverarbeitung im Browser ein Gewinn für die Privatsphäre ist
Wie moderne Web-APIs es ermöglichen, wirklich private Bildwerkzeuge zu bauen — und was das für die Menschen bedeutet, die sie nutzen.
 The Wux Webtools Team
4 min lesen
Inhaltsverzeichnis
- Die Standarderwartung ist falsch
- Was „client-side“ tatsächlich bedeutet
- Warum das in der Praxis wichtig ist
- Wo die Kompromisse weiterhin liegen
- Der Cold Start ist schwerer
- Die Hardware der Nutzerin oder des Nutzers setzt die Grenze
- Sie können nicht über Nutzer hinweg bündeln
- Manche Operationen brauchen einen Server
- Ein kleiner ethischer Punkt
- Wohin es von hier aus geht
Die Standarderwartung ist falsch
Während der letzten zwanzig Jahre bedeutete praktisch jede anspruchsvollere Arbeit mit einem Bild im Web, es auf einen Server hochzuladen. Ein HEIC-Foto konvertieren, EXIF-Metadaten entfernen, ein Favicon erzeugen — all diese Werkzeuge liefen historisch hinter einem multipart-Formular. Die Nutzerin oder der Nutzer klickte auf upload, die Datei reiste durch das öffentliche Internet, und irgendein Server erledigte die Arbeit.
Diese Standardeinstellung ist technisch nicht mehr nötig. Browser liefern seit Jahren APIs aus, mit denen die gesamte Pipeline lokal laufen kann:
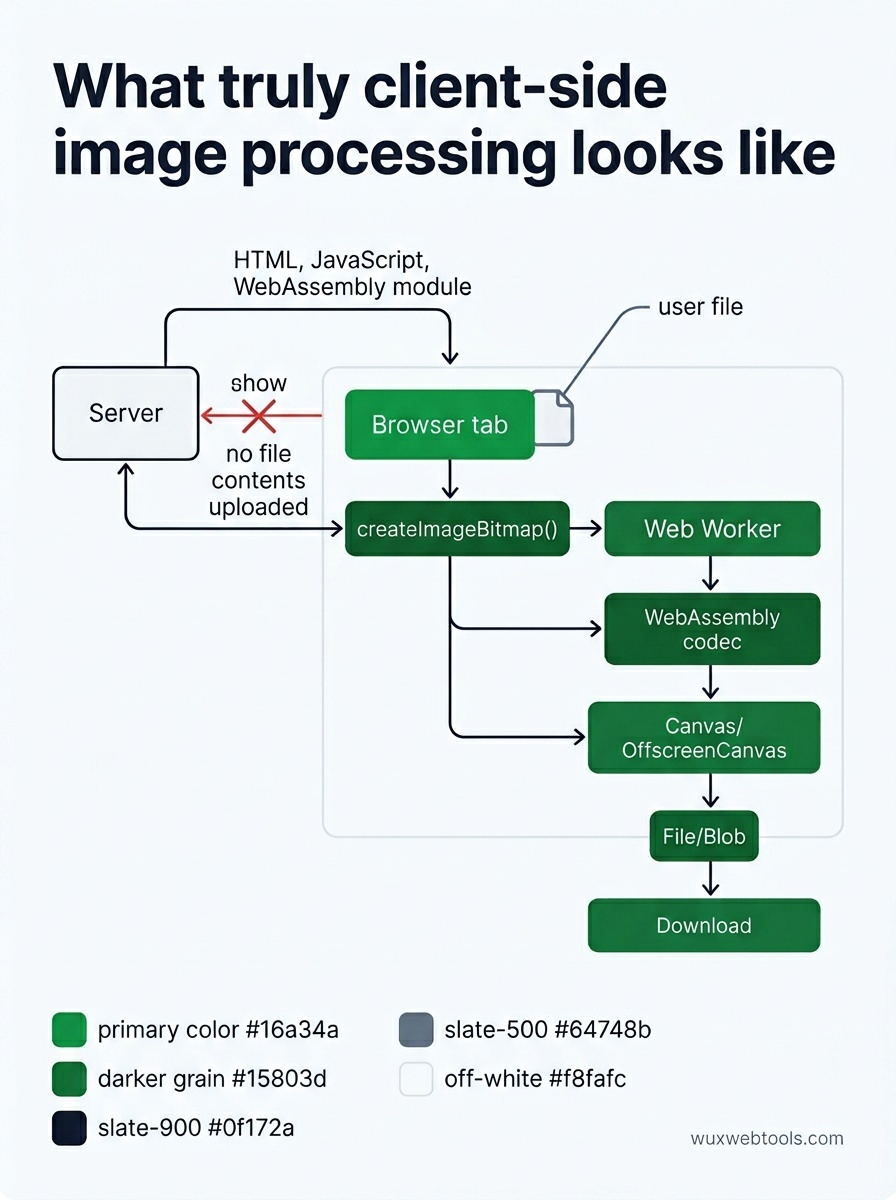
<canvas>undOffscreenCanvasfür Arbeiten auf PixelebenecreateImageBitmap()für schnelles Decoding abseits des Haupt-ThreadsFileundBlobzum Lesen von Uploads, ohne sie irgendwohin zu senden- WebAssembly für Bibliotheken wie libheif, libwebp und ffmpeg
- Web Workers damit die UI reaktionsfähig bleibt, während schwere Arbeit läuft
Wenn man diese Bausteine zusammenfügt, verlässt die Datei das Gerät nie. Der Server sieht sie nie. Es gibt nichts zu protokollieren, nichts, was leaken könnte, nichts, was per Gerichtsbeschluss herausverlangt werden könnte.
Was „client-side“ tatsächlich bedeutet
Präzision lohnt sich, denn die Marketingtexte vieler „privater“ Werkzeuge sind ungenau.
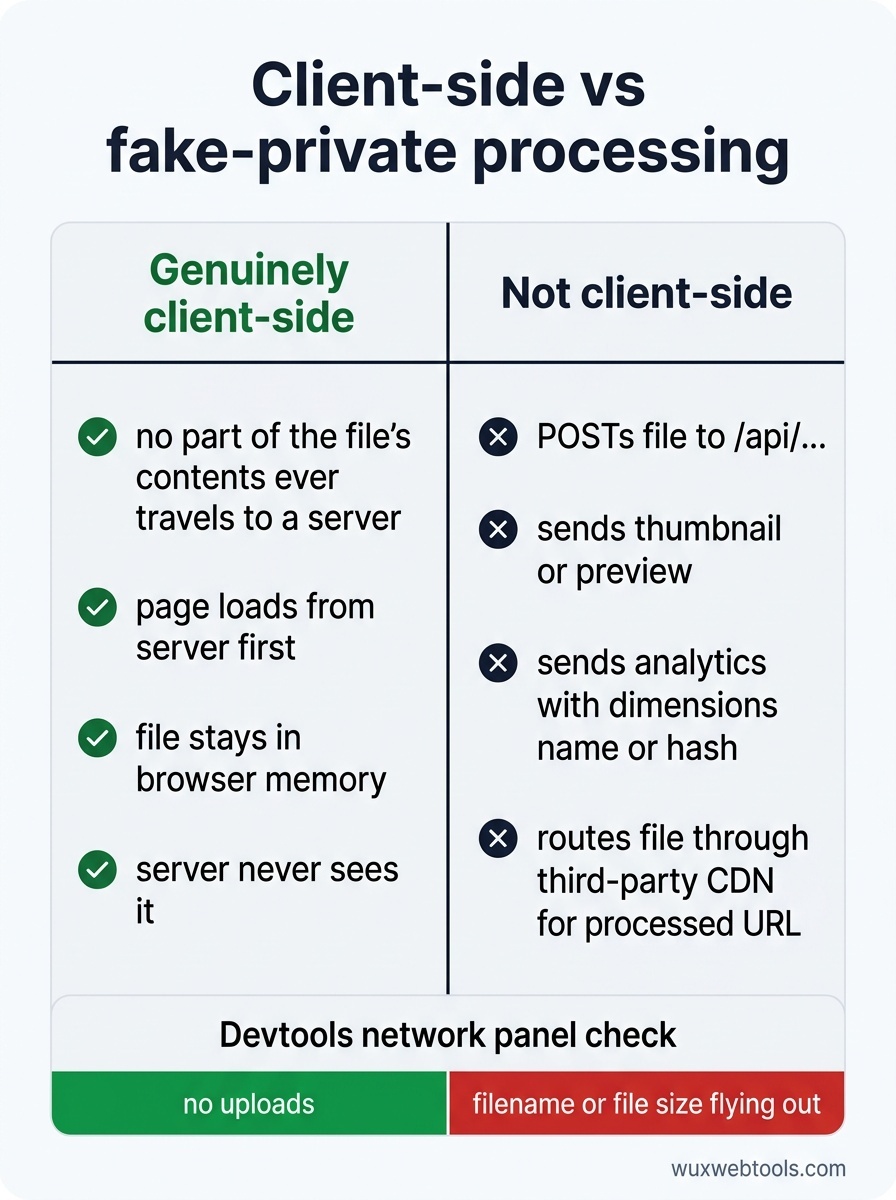
Ein Werkzeug ist wirklich client-side, wenn nach dem Laden der Seite kein Teil des Dateiinhalts jemals zu einem Server übertragen wird. Die Seite selbst wird von einem Server geladen (HTML, JavaScript, vielleicht ein WebAssembly-Modul). Danach gelangt Ihre Datei in den Speicher des Browsers und bleibt dort, bis Sie den Tab schließen.
Ein Werkzeug ist nicht client-side, wenn es:
- die Datei per POST an einen
/api/...-Endpunkt sendet - ein Thumbnail oder eine Vorschau an einen Server sendet
- einen Analytics-Endpunkt mit Dateimetadaten aufruft (Abmessungen, Name, Hash)
- die Datei über ein CDN eines Drittanbieters leitet, das eine verarbeitete URL zurückgibt
Das Netzwerk-Panel in den DevTools Ihres Browsers sagt die Wahrheit. Öffnen Sie es, ziehen Sie eine Datei hinein und prüfen Sie, was hochgeladen wird. Wenn Sie sehen, dass Ihr Dateiname oder Ihre Dateigröße hinausfliegt, ist das Werkzeug nicht so privat, wie es behauptet.
Warum das in der Praxis wichtig ist
Drei Gruppen profitieren im Stillen davon, wenn Bildverarbeitung in den Browser wandert.
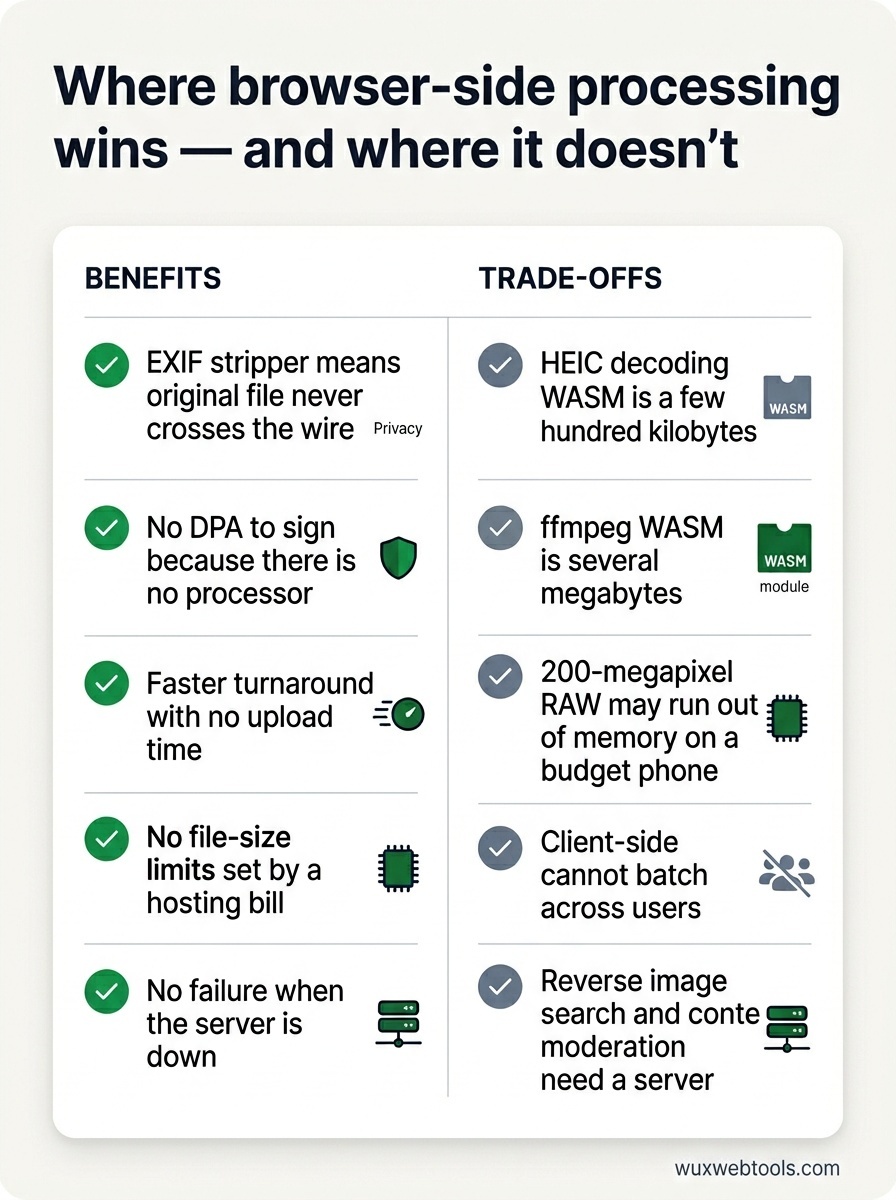
Journalistinnen, Aktivisten und Forschende arbeiten mit Quellmaterial, dessen Leak gefährlich wäre. EXIF-Metadaten können GPS-Koordinaten des Geräts enthalten, mit dem das Foto aufgenommen wurde. Ein EXIF-Stripper im Browser bedeutet, dass die Originaldatei nie über die Leitung geht.
Regulierte Unternehmen — Gesundheitswesen, Finanzwesen, Rechtsbranche — bräuchten sonst einen Auftragsverarbeitungsvertrag mit der Person oder Organisation, die das Werkzeug betreibt. Eine statische Seite, die die Arbeit lokal erledigt, hat keinen DPA zu unterzeichnen, weil es keinen Auftragsverarbeiter gibt.
Alle anderen bekommen die offensichtlichen Vorteile: schnellere Ergebnisse (keine Upload-Zeit), keine durch eine Hosting-Rechnung gesetzten Dateigrößenlimits, kein Ausfall, wenn der Server nicht erreichbar ist.
Wo die Kompromisse weiterhin liegen
Client-side ist keine Magie. Es gibt echte Kosten, die Sie durchdenken sollten, bevor Sie es für ein bestimmtes Problem wählen.
Der Cold Start ist schwerer
Ein WebAssembly-Bundle für HEIC-Decoding ist einige hundert Kilobyte groß. ffmpeg, nach WASM kompiliert, ist mehrere Megabyte groß. Der erste Besuch bezahlt diese Kosten. Caching hilft, und Code-Splitting hilft noch mehr — laden Sie nur den Codec, den die Nutzerin oder der Nutzer tatsächlich ausgewählt hat.
Die Hardware der Nutzerin oder des Nutzers setzt die Grenze
Eine RAW-Datei mit 200 Megapixeln sprengt auf einem günstigen Smartphone den Speicher lange, bevor das auf einem Server passieren würde. Seien Sie in der UI ehrlich darüber, was auf dem Gerät realistisch ist.
Sie können nicht über Nutzer hinweg bündeln
Serverseitige Verarbeitung kann deduplizieren und amortisieren. Wenn eine Million Nutzer dasselbe Stockfoto konvertieren, kann ein Server es einmal verarbeiten. Client-side erledigt es eine Million Mal. Für die meisten Workloads persönlicher Werkzeuge ist das in Ordnung — die Arbeit ist ohnehin einzigartig —, aber man sollte es wissen.
Manche Operationen brauchen einen Server
Reverse Image Search braucht einen Index. Content Moderation braucht ein Modell, das zu groß ist, um es auszuliefern. Alles, was Ihre Datei mit einem Korpus vergleicht, der Ihnen nicht gehört, braucht ein Backend.
Ein kleiner ethischer Punkt
Wenn Ihr Werkzeug wirklich client-side ist, sagen Sie es deutlich und beweisen Sie es. Verlinken Sie den Quellcode, verweisen Sie auf das Netzwerk-Panel, erklären Sie, was wo läuft. Formulierungen wie „wir speichern Ihre Daten nicht“ bedeuten nichts ohne eine Architektur, die das stützt — jedes serverseitige Werkzeug, bei dem je Kundendaten geleakt sind, hat genau das ebenfalls gesagt und es damals auch so gemeint.
Das Gegenteil gilt ebenfalls. Wenn Ihr Werkzeug server-side ist, tun Sie nicht so, als wäre es anders. Nutzerinnen und Nutzer haben gelernt, dieses Muster zu erkennen, und der Vertrauensverlust ist dauerhaft, wenn sie Sie dabei ertappen.
<!-- tool-cta:start -->
💡 Probieren Sie Folgendes aus: Sehen Sie clientseitige Verarbeitung in Aktion mit Image Compressor, der Bilder vollständig in Ihrem Browser verkleinert, sodass niemals etwas auf einen Server hochgeladen wird.
<!-- tool-cta:end -->
Wohin es von hier aus geht
Wenn Sie heute ein kleines Bildwerkzeug bauen, wählen Sie standardmäßig client-side und greifen Sie nur dann zu einem Server, wenn Sie einen konkreten Grund haben. Der Browser wird Sie überraschen, wie weit er die Arbeit tragen kann — und die Menschen am anderen Ende der Netzwerkverbindung werden Ihnen im Stillen für die Bytes danken, die ihre Maschine nie verlassen haben.
Häufig gestellte Fragen
Ist client-side Verarbeitung immer privater als serverseitige Verarbeitung?
Warum funktionieren dann nicht alle Werkzeuge so?
Verlangsamt WebAssembly meinen Computer?
Was ist mit sehr großen Dateien?
Quellen & weiterführende Literatur