브라우저에서 이미지를 처리하는 것이 개인정보 보호에 유리한 이유
현대적인 웹 API로 진정으로 프라이빗한 이미지 도구를 만들 수 있는 방법 — 그리고 그것이 사용자에게 의미하는 것.
 The Wux Webtools Team
5 읽기 최소 시간
목차
기본 전제는 잘못되어 있다
지난 20년의 대부분 동안, 웹에서 이미지로 조금이라도 복잡한 작업을 하려면 서버에 업로드해야 했습니다. HEIC 사진 변환, EXIF metadata 제거, favicon 생성 — 이런 도구들은 역사적으로 모두 multipart form 뒤에 있었습니다. 사용자가 upload를 클릭하면 파일은 공용 인터넷을 가로질러 이동했고, 어딘가의 서버가 작업을 처리했습니다.
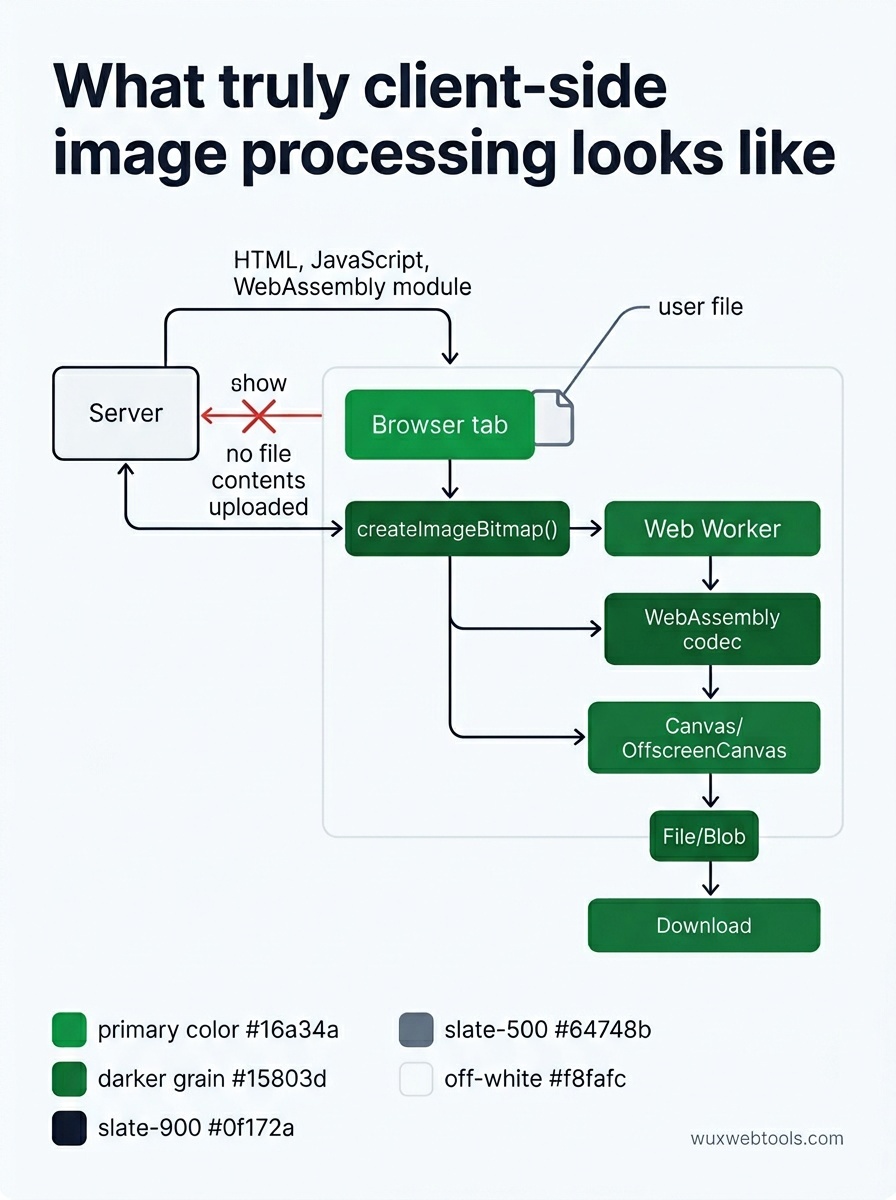
그 기본값은 이제 기술적으로 더 이상 필요하지 않습니다. 브라우저에는 이미 몇 년 전부터 전체 파이프라인을 로컬에서 실행할 수 있게 하는 API들이 탑재되어 있었습니다:
<canvas>andOffscreenCanvas픽셀 수준 작업을 위해createImageBitmap()빠른 오프스레드 디코딩을 위해FileandBlob업로드 파일을 어디에도 보내지 않고 읽기 위해- WebAssembly libheif, libwebp, ffmpeg 같은 라이브러리를 위해
- Web Workers 무거운 작업이 실행되는 동안 UI 반응성을 유지하기 위해
이것들을 함께 엮으면 파일은 기기를 떠나지 않습니다. 서버는 파일을 결코 보지 못합니다. 기록할 것도, 유출될 것도, 제출 명령의 대상이 될 것도 없습니다.
“클라이언트 측”이 실제로 의미하는 것
정확히 짚고 넘어갈 가치가 있습니다. 많은 “프라이빗” 도구의 마케팅 문구가 느슨하기 때문입니다.
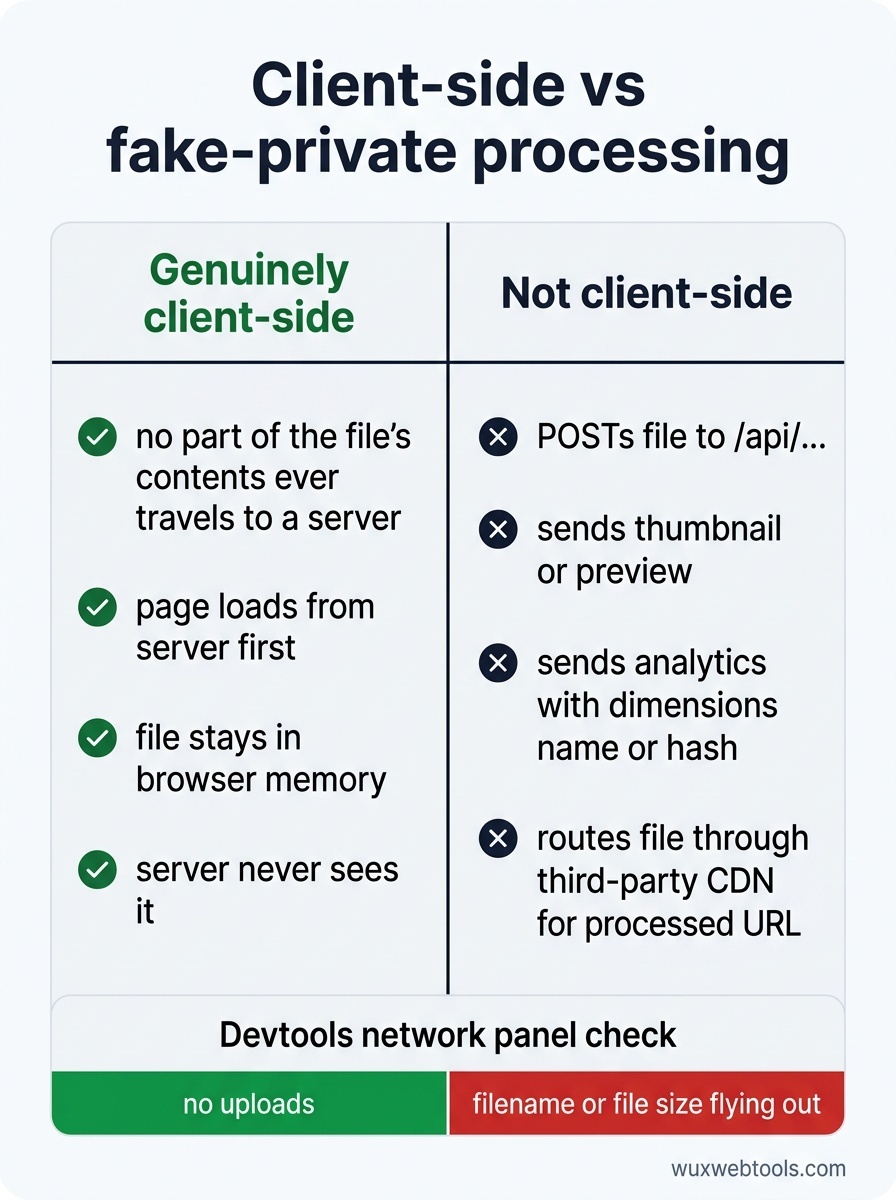
도구가 진정으로 클라이언트 측이라는 것은, 페이지가 로드된 뒤 파일 내용의 어떤 부분도 서버로 이동하지 않는다는 뜻입니다. 페이지 자체는 서버에서 로드됩니다(HTML, JavaScript, 어쩌면 WebAssembly 모듈). 그 이후에는 파일이 브라우저 메모리로 들어가고, 탭을 닫을 때까지 그곳에 머뭅니다.
다음과 같은 경우 그 도구는 클라이언트 측이 아닙니다:
- 파일을
/api/...엔드포인트로 POST하는 경우 - 썸네일이나 미리보기를 서버로 보내는 경우
- 파일 metadata(치수, 이름, hash)를 analytics 엔드포인트로 호출하는 경우
- 처리된 URL을 반환하는 서드파티 CDN을 통해 파일을 라우팅하는 경우
브라우저 devtools의 network panel이 진실을 말해 줍니다. 그것을 열고, 파일을 떨어뜨린 다음, 무엇이 업로드되는지 확인하세요. 파일명이나 파일 크기가 밖으로 날아가는 것이 보인다면, 그 도구는 주장만큼 프라이빗하지 않습니다.
이것이 실제로 중요한 이유
이미지 처리가 브라우저로 이동하면 세 부류의 사람들이 조용히 혜택을 봅니다.
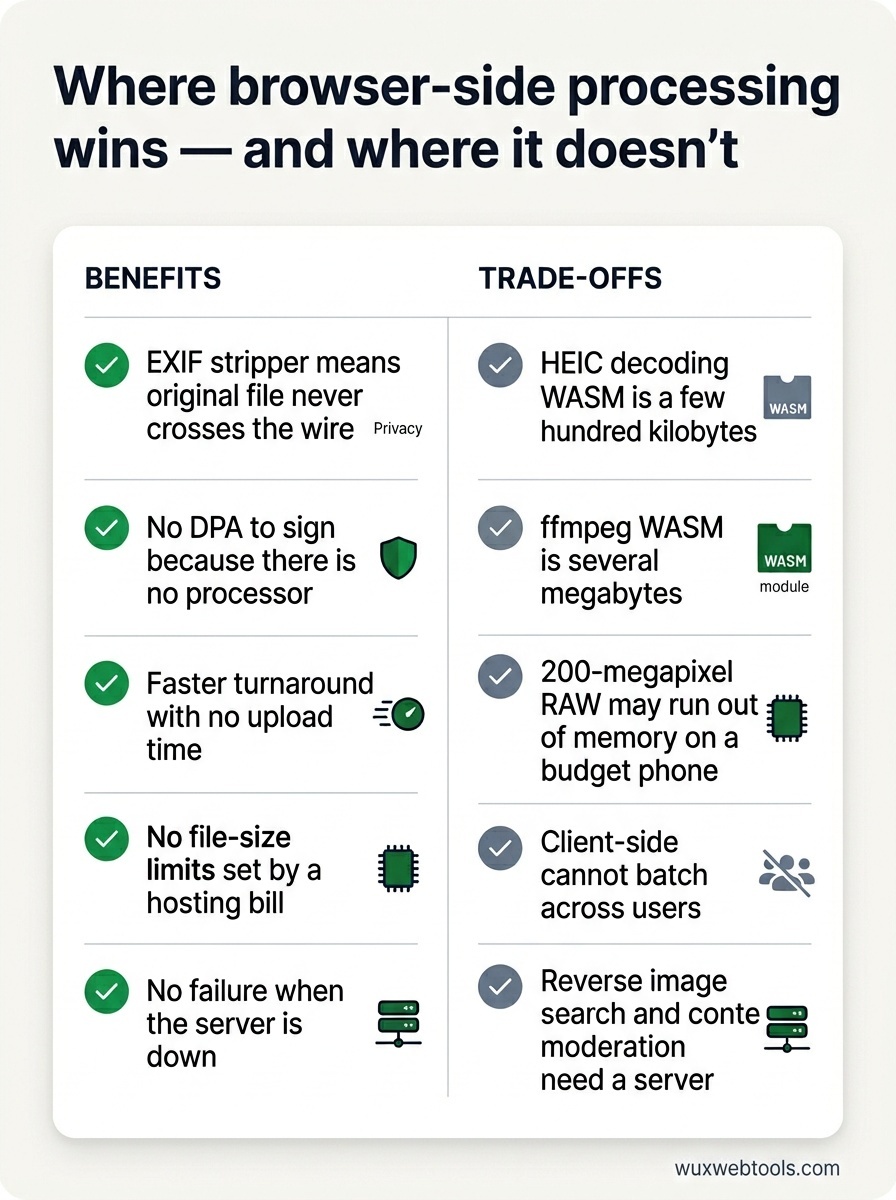
언론인, 활동가, 연구자는 유출될 경우 위험할 수 있는 원자료를 다룹니다. EXIF metadata에는 사진을 찍은 기기의 GPS 좌표가 포함될 수 있습니다. 브라우저 측 EXIF 제거 도구라면 원본 파일은 결코 네트워크를 건너지 않습니다.
규제 대상 기업 — 의료, 금융, 법률 — 은 그렇지 않다면 도구 운영자와 데이터 처리 계약을 맺어야 합니다. 로컬에서 작업을 수행하는 정적 페이지에는 서명할 DPA가 없습니다. 처리자가 없기 때문입니다.
그 밖의 모든 사람은 분명한 이점을 얻습니다: 더 빠른 처리 시간(업로드 시간 없음), 호스팅 비용 때문에 정해지는 파일 크기 제한 없음, 서버가 다운되었을 때의 실패 없음.
절충점이 여전히 남아 있는 곳
클라이언트 측은 마법이 아닙니다. 특정 문제에 이를 선택하기 전에 생각해 봐야 할 실제 비용이 있습니다.
콜드 스타트가 더 무겁다
HEIC 디코딩용 WebAssembly bundle은 수백 kilobytes입니다. WASM으로 컴파일된 ffmpeg는 몇 megabytes에 이릅니다. 첫 방문은 이 비용을 치릅니다. 캐싱이 도움이 되고, code-splitting은 더 큰 도움이 됩니다 — 사용자가 실제로 선택한 codec만 로드하세요.
사용자의 hardware가 한계를 정한다
200-megapixel RAW 파일은 서버에서라면 버틸 수 있는 훨씬 이전에 보급형 phone에서 메모리가 부족해질 것입니다. 해당 기기에서 현실적으로 가능한 것이 무엇인지 UI에서 솔직하게 알려야 합니다.
사용자 간 batch 처리는 할 수 없다
서버 측 처리는 중복을 제거하고 비용을 분산할 수 있습니다. 백만 명의 사용자가 같은 stock image를 변환한다면, 서버는 한 번만 처리할 수 있습니다. 클라이언트 측은 백만 번 처리합니다. 대부분의 개인용 도구 작업량에서는 괜찮습니다 — 어차피 작업은 고유하기 때문입니다 — 하지만 알아둘 만한 점입니다.
어떤 작업에는 서버가 필요하다
Reverse image search에는 index가 필요합니다. Content moderation에는 전송하기에 너무 큰 model이 필요합니다. 당신이 소유하지 않은 corpus와 파일을 비교하는 모든 것은 backend가 필요합니다.
작은 윤리적 지점
도구가 진정으로 클라이언트 측이라면, 분명하게 말하고 증명하세요. source에 링크하고, network panel을 가리키고, 무엇이 어디에서 실행되는지 설명하세요. “우리는 당신의 데이터를 저장하지 않습니다” 같은 문구는 이를 뒷받침하는 아키텍처 없이는 아무 의미가 없습니다 — 고객 데이터를 유출한 모든 서버 측 도구도 당시에는 정확히 그렇게 말했고, 그렇게 믿었습니다.
그 반대도 마찬가지입니다. 도구가 서버 측이라면, 그렇지 않은 척하지 마세요. 사용자들은 그 패턴을 알아보기 시작했고, 들켰을 때의 신뢰 손상은 영구적입니다.
<!-- tool-cta:start -->
💡 사용해 보세요: Image Compressor로 이미지를 전적으로 브라우저에서 축소하여 어떤 것도 서버에 업로드되지 않게 하는 클라이언트 측 처리를 실제로 확인해 보세요.
<!-- tool-cta:end -->
여기서 어디로 갈 것인가
오늘 작은 이미지 유틸리티를 만든다면, 기본값을 클라이언트 측으로 두고 구체적인 이유가 있을 때만 서버를 찾으세요. 브라우저는 얼마나 멀리 작업을 감당할 수 있는지로 당신을 놀라게 할 것입니다 — 그리고 네트워크 연결 반대편의 사람들은 자기 기계를 떠나지 않은 바이트들에 대해 조용히 고마워할 것입니다.
자주 묻는 질문
클라이언트 측 처리는 항상 서버 측보다 더 프라이빗한가요?
그렇다면 왜 모든 도구가 이런 방식으로 작동하지 않나요?
WebAssembly가 제 컴퓨터를 느리게 하나요?
매우 큰 파일은 어떻게 되나요?
출처 및 추가 읽기