Waarom afbeeldingen verwerken in de browser privacywinst oplevert
Hoe moderne web-API's je echt private afbeeldingstools laten bouwen — en wat dat betekent voor de mensen die ze gebruiken.
 The Wux Webtools Team
4 min lezen
Inhoudsopgave
- De standaardverwachting klopt niet
- Wat "client-side" echt betekent
- Waarom dit in de praktijk belangrijk is
- Waar de afwegingen nog zitten
- Cold start is zwaarder
- De hardware van de gebruiker bepaalt het plafond
- Je kunt niet over gebruikers heen batchen
- Sommige bewerkingen hebben een server nodig
- Een klein ethisch punt
- Waar je vanaf hier naartoe kunt
De standaardverwachting klopt niet
Gedurende het grootste deel van de afgelopen twintig jaar betekende iets niet-triviaals doen met een afbeelding op het web dat je die naar een server moest uploaden. Een HEIC-foto converteren, EXIF-metadata verwijderen, een favicon genereren — al die tools stonden historisch gezien achter een multipart-formulier. De gebruiker klikte op uploaden, het bestand reisde over het openbare internet en ergens deed een server het werk.
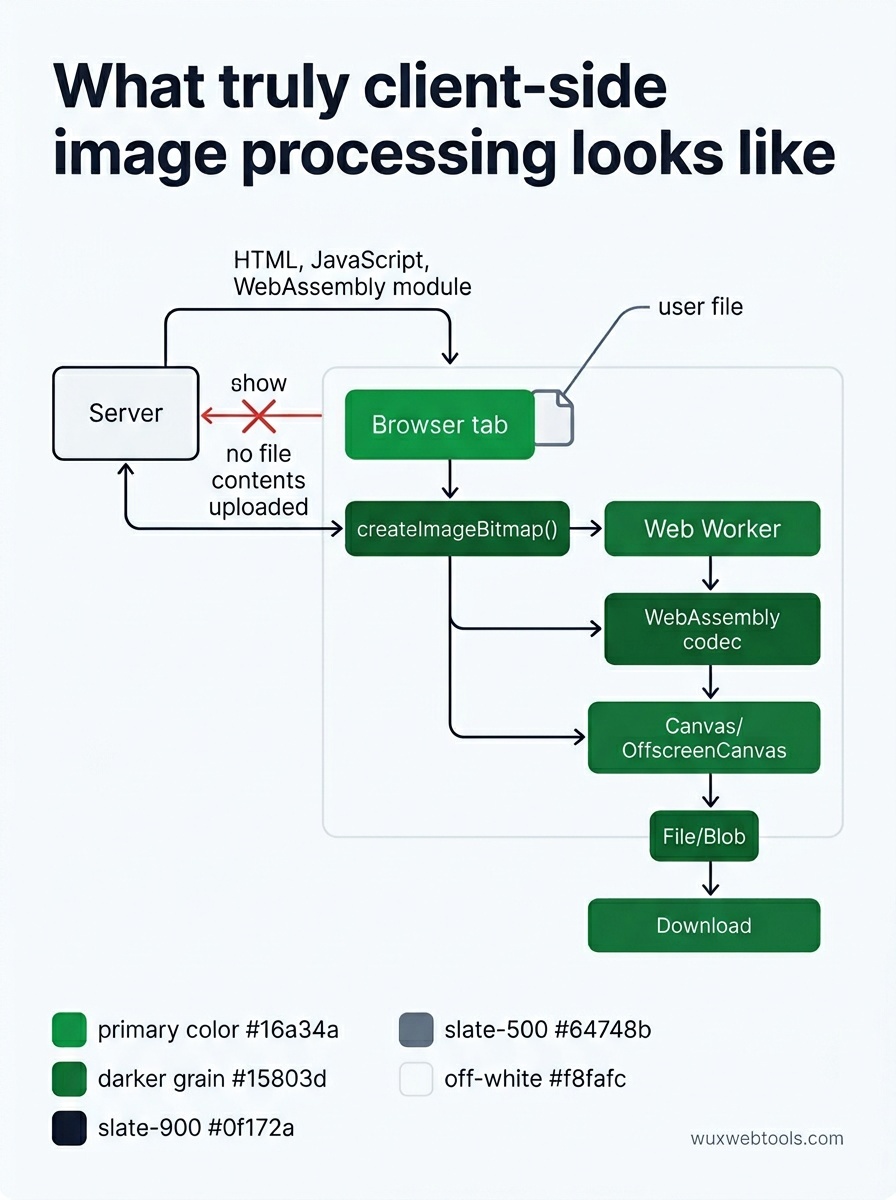
Die standaard is technisch niet langer noodzakelijk. Browsers leveren al jaren API's mee waarmee de hele pijplijn lokaal kan draaien:
<canvas>enOffscreenCanvasvoor werk op pixelniveaucreateImageBitmap()voor snelle decoding buiten de hoofdthreadFileenBlobom uploads te lezen zonder ze ergens heen te sturen- WebAssembly voor bibliotheken zoals libheif, libwebp en ffmpeg
- Web Workers om de UI responsief te houden terwijl zwaar werk draait
Als je die onderdelen aan elkaar knoopt, verlaat het bestand het apparaat nooit. De server ziet het nooit. Er is niets om te loggen, niets om te lekken, niets om te vorderen.
Wat "client-side" echt betekent
Het is de moeite waard om precies te zijn, want de marketingteksten van veel "private" tools zijn nogal losjes.
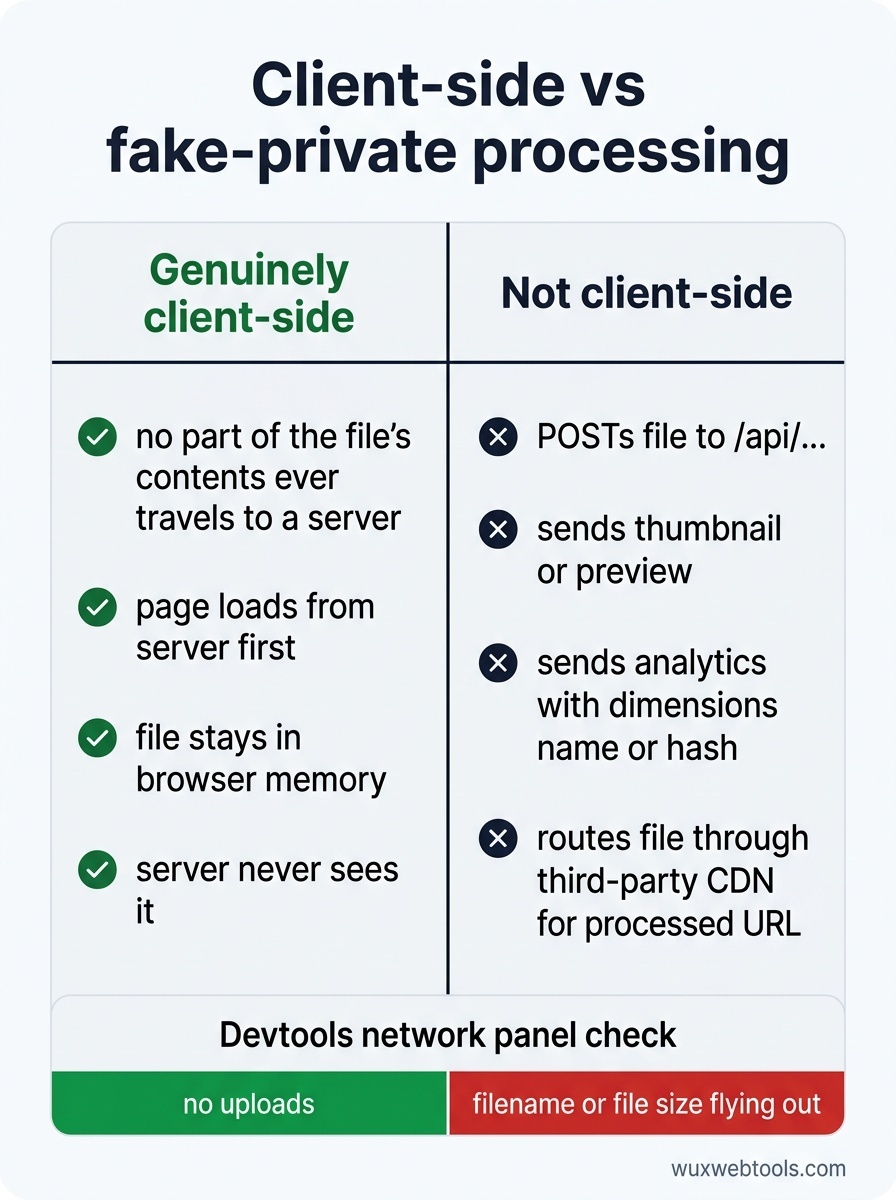
Een tool is echt client-side wanneer, nadat de pagina is geladen, geen enkel deel van de inhoud van het bestand ooit naar een server reist. De pagina zelf wordt vanaf een server geladen (HTML, JavaScript, misschien een WebAssembly-module). Daarna komt je bestand in het geheugen van de browser terecht en blijft het daar totdat je het tabblad sluit.
Een tool is niet client-side als die:
- het bestand POST naar een
/api/...-endpoint - een thumbnail of preview naar een server stuurt
- een analytics-endpoint aanroept met bestandsmetadata (afmetingen, naam, hash)
- het bestand via een externe CDN routeert die een verwerkte URL teruggeeft
Het netwerkpaneel in de devtools van je browser vertelt de waarheid. Open het, sleep er een bestand in en controleer wat er wordt geüpload. Als je je bestandsnaam of bestandsgrootte naar buiten ziet vliegen, is de tool niet zo privé als wordt beweerd.
Waarom dit in de praktijk belangrijk is
Drie groepen mensen profiteren er stilletjes van wanneer beeldverwerking naar de browser verschuift.
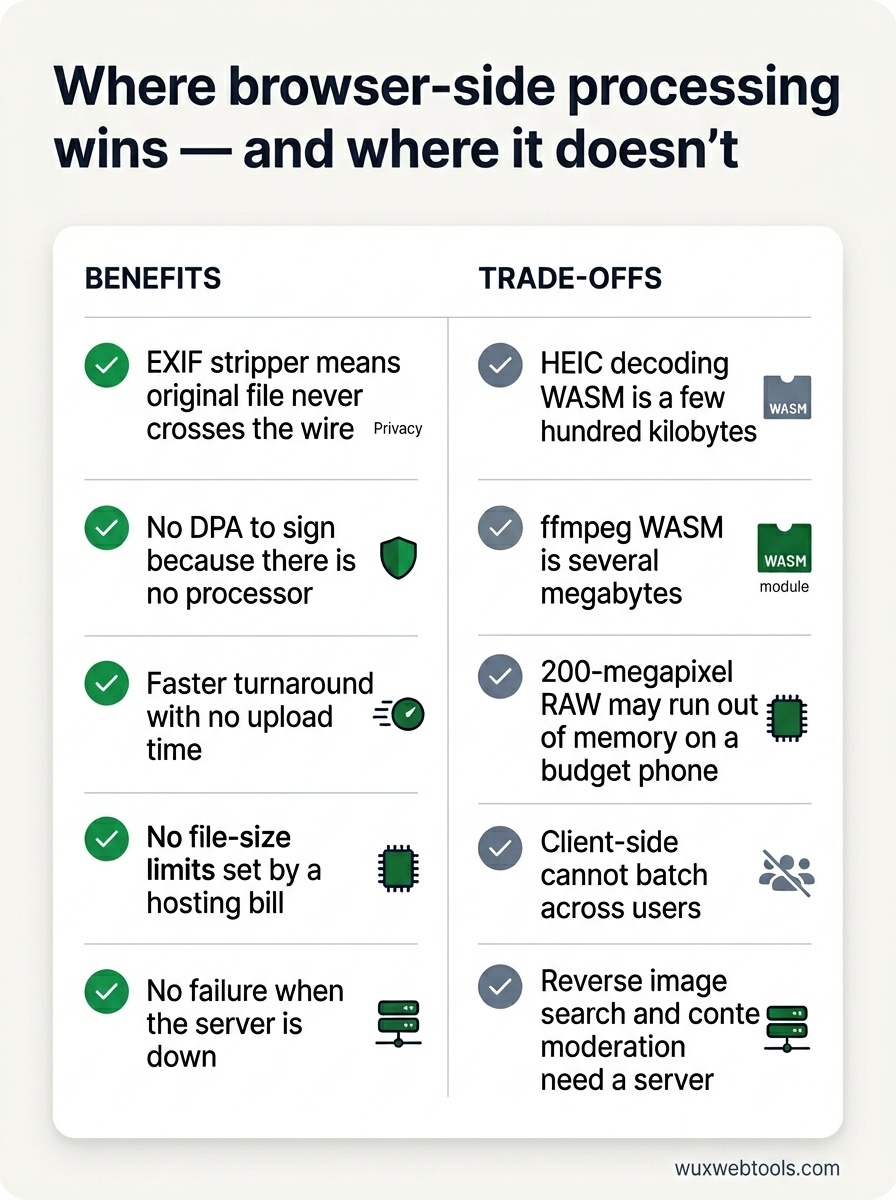
Journalisten, activisten en onderzoekers werken met bronmateriaal dat gevaarlijk kan zijn als het uitlekt. EXIF-metadata kan GPS-coördinaten bevatten van het apparaat waarmee de foto is gemaakt. Een EXIF-verwijderaar in de browser betekent dat het oorspronkelijke bestand nooit over de lijn gaat.
Bedrijven onder regelgeving — zorg, finance, juridisch — zouden anders een verwerkersovereenkomst nodig hebben met degene die de tool beheert. Een statische pagina die het werk lokaal doet, heeft geen DPA om te ondertekenen, omdat er geen verwerker is.
Alle anderen krijgen de voor de hand liggende voordelen: snellere doorlooptijd (geen uploadtijd), geen bestandsgroottelimieten die door een hostingrekening worden bepaald, geen storing wanneer de server offline is.
Waar de afwegingen nog zitten
Client-side is geen magie. Er zijn echte kosten waar je over moet nadenken voordat je het voor een bepaald probleem kiest.
Cold start is zwaarder
Een WebAssembly-bundel voor HEIC-decoding is een paar honderd kilobytes. ffmpeg gecompileerd naar WASM is meerdere megabytes. Het eerste bezoek betaalt die prijs. Caching helpt, en code-splitting helpt nog meer — laad alleen de codec die de gebruiker daadwerkelijk heeft gekozen.
De hardware van de gebruiker bepaalt het plafond
Een RAW-bestand van 200 megapixel loopt op een budgettelefoon al lang tegen het geheugen aan voordat dat op een server zou gebeuren. Wees in de UI eerlijk over wat realistisch is op het apparaat.
Je kunt niet over gebruikers heen batchen
Server-side verwerking kan dedupliceren en kosten spreiden. Als een miljoen gebruikers dezelfde stockfoto converteren, kan een server die één keer verwerken. Client-side doet dat een miljoen keer. Voor de meeste workloads van persoonlijke tools is dat prima — het werk is toch uniek — maar het is goed om te weten.
Sommige bewerkingen hebben een server nodig
Reverse image search heeft een index nodig. Contentmoderatie heeft een model nodig dat te groot is om mee te leveren. Alles wat je bestand vergelijkt met een corpus dat je niet bezit, heeft een backend nodig.
Een klein ethisch punt
Als je tool echt client-side is, zeg dat dan luid en bewijs het. Link naar de broncode, wijs naar het netwerkpaneel, leg uit wat waar draait. Zinnen als "we slaan je gegevens niet op" betekenen niets zonder architectuur die dat ondersteunt — elke server-side tool die ooit klantgegevens heeft gelekt, zei precies hetzelfde en meende dat op dat moment ook.
Het omgekeerde geldt ook. Als je tool wel server-side is, doe dan niet alsof dat niet zo is. Gebruikers zijn het patroon gaan herkennen, en de vertrouwensbreuk wanneer ze je erop betrappen is blijvend.
<!-- tool-cta:start -->
💡 Probeer dit: Bekijk client-side verwerking in actie met Image Compressor, dat afbeeldingen volledig in je browser verkleint zodat er nooit iets naar een server wordt geüpload.
<!-- tool-cta:end -->
Waar je vanaf hier naartoe kunt
Als je vandaag een kleine afbeeldingstool bouwt, kies dan standaard voor client-side en pak pas een server wanneer je daar een concrete reden voor hebt. De browser zal je verrassen met hoe ver hij het werk kan dragen — en de mensen aan de andere kant van de netwerkverbinding zullen je stilletjes dankbaar zijn voor de bytes die hun machine nooit hebben verlaten.
Veelgestelde vragen
Is client-side verwerking altijd privater dan server-side?
Waarom werken dan niet alle tools op deze manier?
Maakt WebAssembly mijn computer trager?
Hoe zit het met heel grote bestanden?
Bronnen & verder lezen