Por qué procesar imágenes en el navegador es una ventaja para la privacidad
Cómo las API web modernas permiten crear herramientas de imagen realmente privadas, y qué significa eso para quienes las usan.
 The Wux Webtools Team
5 min de lectura
Tabla de contenido
- La expectativa predeterminada es incorrecta
- Qué significa realmente "del lado del cliente"
- Por qué esto importa en la práctica
- Dónde siguen estando las concesiones
- El arranque en frío es más pesado
- El hardware del usuario fija el techo
- No puedes procesar lotes entre usuarios
- Algunas operaciones necesitan un servidor
- Un pequeño punto ético
- A dónde ir desde aquí
La expectativa predeterminada es incorrecta
Durante la mayor parte de los últimos veinte años, hacer cualquier cosa no trivial con una imagen en la web significaba subirla a un servidor. Convertir una foto HEIC, eliminar sus metadatos EXIF, generar un favicon: históricamente, todas esas herramientas vivían detrás de un formulario multipart. El usuario hacía clic en subir, el archivo viajaba por la internet pública y un servidor en algún lugar hacía el trabajo.
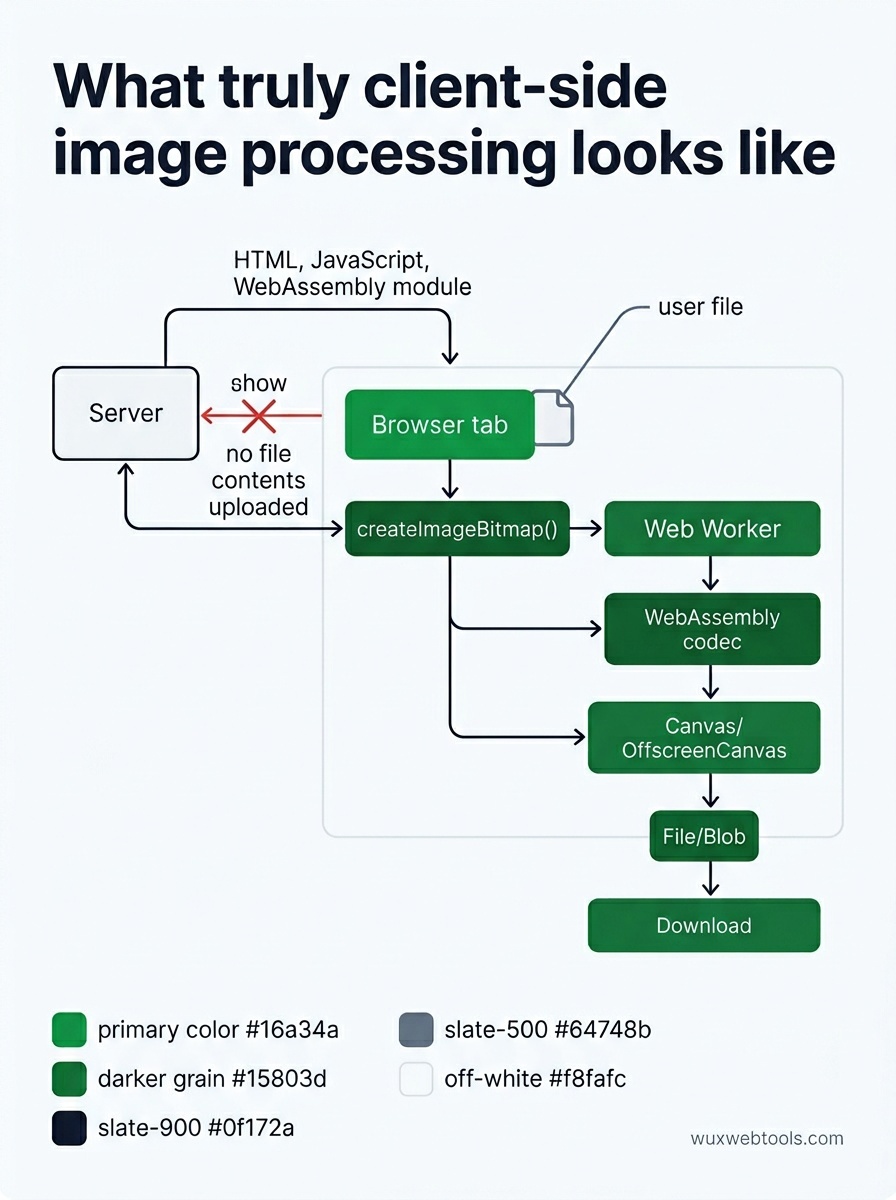
Ese valor predeterminado ya no es técnicamente necesario. Hace años que los navegadores incorporan API que permiten ejecutar todo el flujo localmente:
<canvas>andOffscreenCanvasfor pixel-level workcreateImageBitmap()for fast, off-thread decodingFileandBlobfor reading uploads without sending them anywhere- WebAssembly for libraries like libheif, libwebp and ffmpeg
- Web Workers to keep the UI responsive while heavy work runs
Si unes esas piezas, el archivo nunca sale del dispositivo. El servidor nunca lo ve. No hay nada que registrar, nada que filtrar, nada que citar judicialmente.
Qué significa realmente "del lado del cliente"
Conviene ser precisos, porque el texto de marketing de muchas herramientas "privadas" es impreciso.
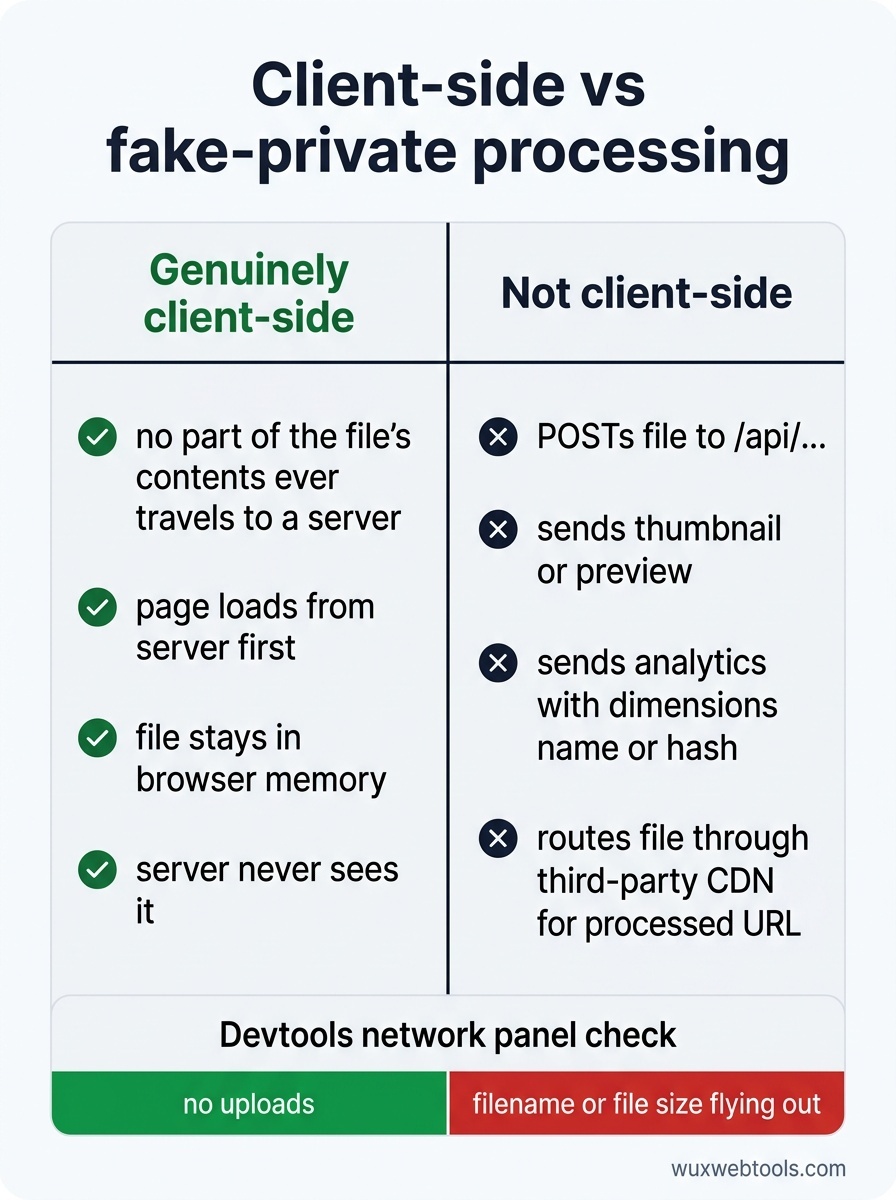
Una herramienta es genuinamente del lado del cliente cuando, después de que la página se carga, ninguna parte del contenido del archivo viaja jamás a un servidor. La propia página se carga desde un servidor (HTML, JavaScript, quizá un módulo WebAssembly). Después de eso, tu archivo entra en la memoria del navegador y permanece allí hasta que cierras la pestaña.
Una herramienta no es del lado del cliente si:
- Envía el archivo por POST a un endpoint
/api/... - Envía una miniatura o vista previa a un servidor
- Llama a un endpoint de analítica con metadatos del archivo (dimensiones, nombre, hash)
- Enruta el archivo a través de un CDN de terceros que devuelve una URL procesada
El panel de red en las devtools de tu navegador dice la verdad. Ábrelo, suelta un archivo y comprueba qué se sube. Si ves que tu nombre de archivo o el tamaño de tu archivo salen volando, la herramienta no es tan privada como afirma.
Por qué esto importa en la práctica
Tres grupos de personas se benefician discretamente cuando el procesamiento de imágenes se traslada al navegador.
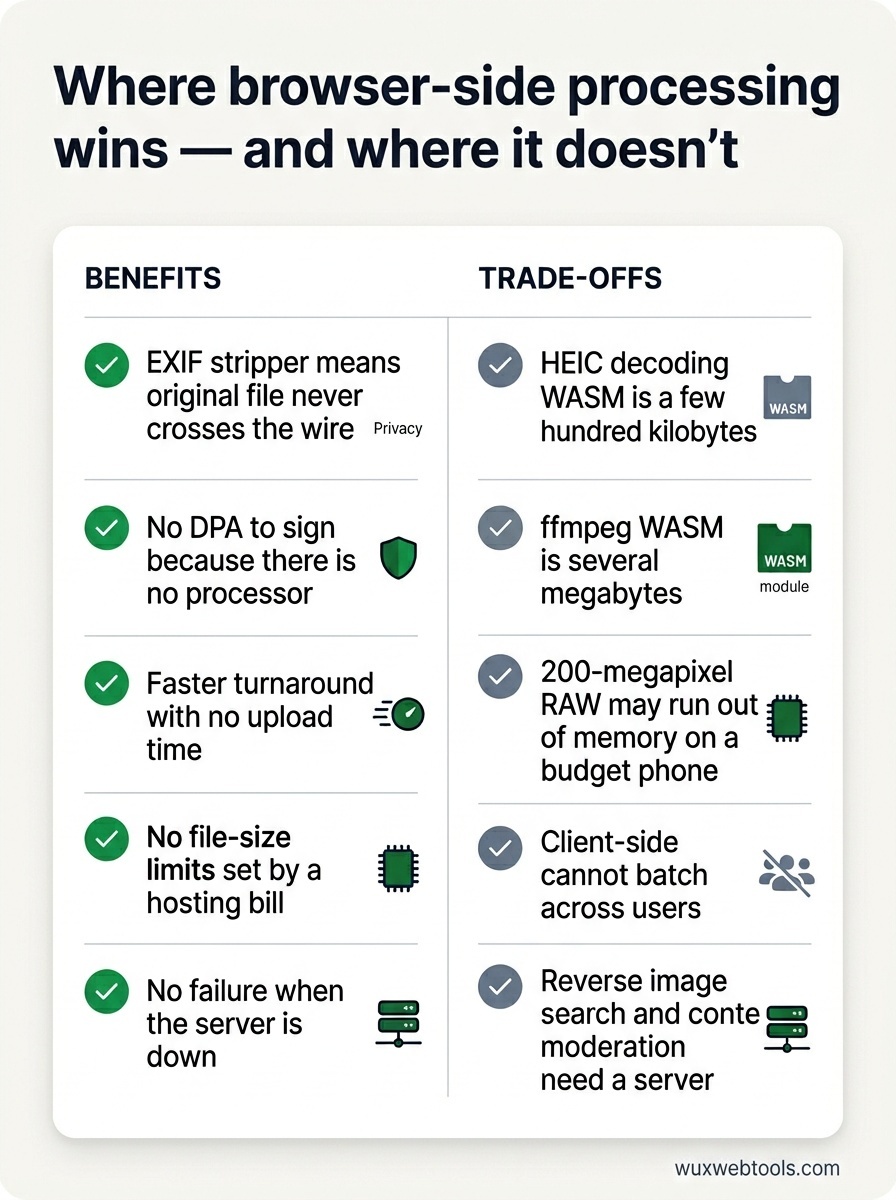
Periodistas, activistas e investigadores manejan material de fuentes que sería peligroso si se filtrara. Los metadatos EXIF pueden incluir coordenadas GPS del dispositivo que tomó la foto. Un eliminador de EXIF en el navegador significa que el archivo original nunca cruza la red.
Empresas sujetas a regulación —sanidad, finanzas, legal— de otro modo necesitarían un acuerdo de tratamiento de datos con quien opere la herramienta. Una página estática que hace el trabajo localmente no requiere firmar ningún DPA porque no hay encargado del tratamiento.
Todos los demás obtienen los beneficios evidentes: resultados más rápidos (sin tiempo de subida), sin límites de tamaño de archivo impuestos por una factura de hosting, sin fallos cuando el servidor está caído.
Dónde siguen estando las concesiones
El lado del cliente no es magia. Hay costes reales que conviene considerar antes de elegirlo para un problema determinado.
El arranque en frío es más pesado
Un paquete WebAssembly para decodificar HEIC ocupa unos cientos de kilobytes. ffmpeg compilado a WASM ocupa varios megabytes. La primera visita paga ese coste. La caché ayuda, y la división de código ayuda aún más: carga solo el códec que el usuario ha elegido realmente.
El hardware del usuario fija el techo
Un archivo RAW de 200 megapíxeles agotará la memoria en un teléfono económico mucho antes de hacerlo en un servidor. Sé honesto en la interfaz sobre lo que es realista en el dispositivo.
No puedes procesar lotes entre usuarios
El procesamiento del lado del servidor puede deduplicar y amortizar. Si un millón de usuarios convierte la misma imagen de stock, un servidor puede procesarla una sola vez. Del lado del cliente, se hace un millón de veces. Para la mayoría de cargas de trabajo de herramientas personales esto está bien —el trabajo suele ser único de todos modos—, pero conviene saberlo.
Algunas operaciones necesitan un servidor
La búsqueda inversa de imágenes necesita un índice. La moderación de contenido necesita un modelo demasiado grande para enviarlo al navegador. Cualquier cosa que compare tu archivo con un corpus que no posees necesita un backend.
Un pequeño punto ético
Si tu herramienta es genuinamente del lado del cliente, dilo claramente y demuéstralo. Enlaza al código fuente, señala el panel de red, explica qué se ejecuta dónde. Frases como "no almacenamos tus datos" no significan nada sin una arquitectura que las respalde: todas las herramientas del lado del servidor que alguna vez filtraron datos de clientes también dijeron exactamente eso, y lo decían de buena fe en ese momento.
Lo inverso también vale. Si tu herramienta es del lado del servidor, no finjas lo contrario. Los usuarios han aprendido a reconocer el patrón, y el golpe a la confianza cuando te descubren es permanente.
<!-- tool-cta:start -->
💡 Prueba esto: Mira el procesamiento del lado del cliente en acción con Image Compressor, que reduce imágenes completamente en tu navegador para que nunca se suba nada a un servidor.
<!-- tool-cta:end -->
A dónde ir desde aquí
Si hoy estás construyendo una pequeña utilidad de imagen, parte del lado del cliente y recurre a un servidor solo cuando tengas una razón concreta. El navegador te sorprenderá por lo lejos que puede llevar el trabajo, y las personas al otro extremo de la conexión de red te agradecerán en silencio los bytes que nunca salieron de su máquina.
Preguntas frecuentes
¿El procesamiento del lado del cliente siempre es más privado que el del lado del servidor?
Entonces, ¿por qué no funcionan así todas las herramientas?
¿WebAssembly ralentiza mi ordenador?
¿Qué pasa con los archivos muy grandes?
Fuentes y lecturas adicionales