Dlaczego przetwarzanie obrazów w przeglądarce to korzyść dla prywatności
Jak nowoczesne web API pozwalają tworzyć naprawdę prywatne narzędzia do obrazów — i co to oznacza dla osób, które z nich korzystają.
 The Wux Webtools Team
5 min czytania
Spis treści
- Domyślne założenie jest błędne
- Co naprawdę znaczy „po stronie klienta”
- Dlaczego ma to znaczenie w praktyce
- Gdzie wciąż pozostają kompromisy
- Zimny start jest cięższy
- Sprzęt użytkownika wyznacza górną granicę
- Nie możesz wykonywać batchowania między użytkownikami
- Niektóre operacje potrzebują serwera
- Mała uwaga etyczna
- Co dalej
Domyślne założenie jest błędne
Przez większość ostatnich dwudziestu lat zrobienie w internecie czegokolwiek nietrywialnego z obrazem oznaczało przesłanie go na serwer. Konwersja zdjęcia HEIC, usunięcie metadanych EXIF, wygenerowanie favicon — każde z tych narzędzi historycznie działało za formularzem multipart. Użytkownik klikał upload, plik podróżował przez publiczny internet, a serwer gdzieś wykonywał pracę.
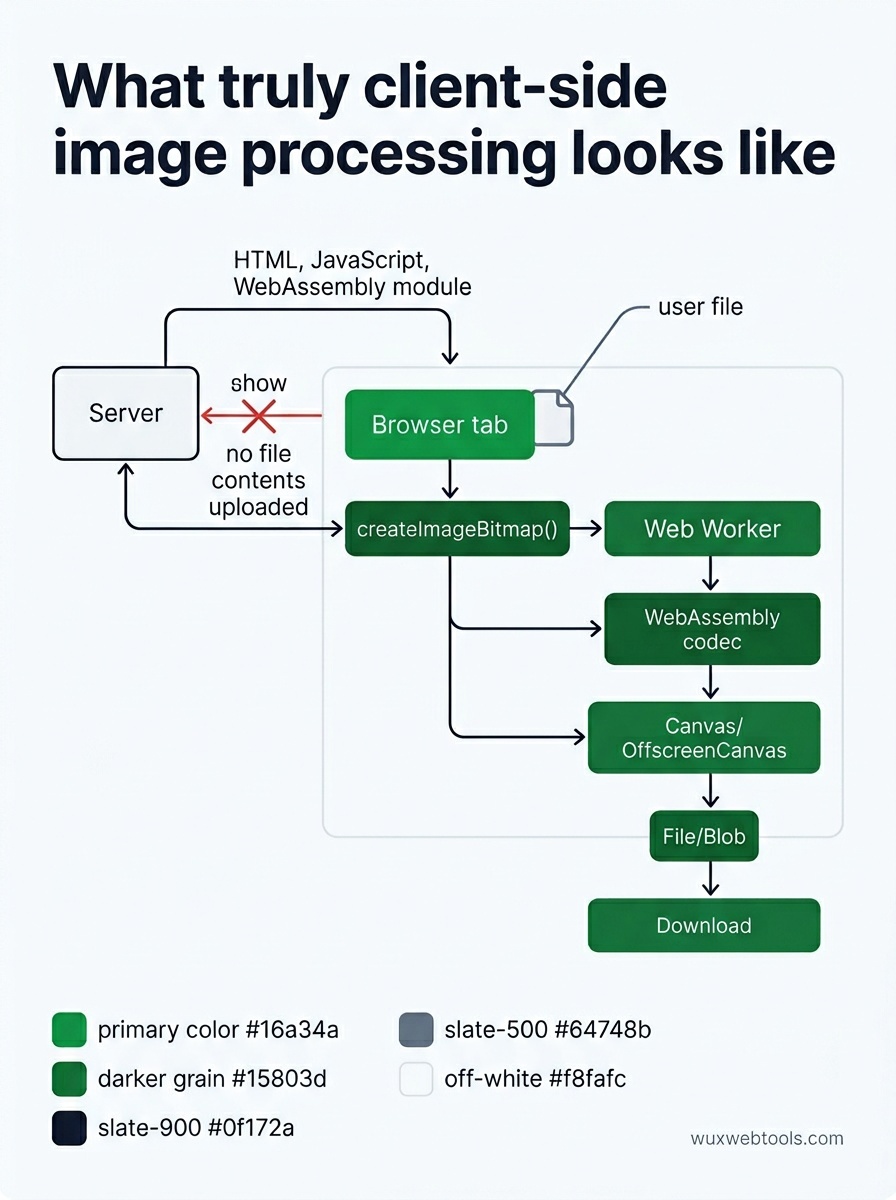
To domyślne podejście nie jest już technicznie konieczne. Przeglądarki od lat udostępniają API, które pozwalają uruchomić cały pipeline lokalnie:
<canvas>iOffscreenCanvasdo pracy na poziomie pikselicreateImageBitmap()do szybkiego dekodowania poza głównym wątkiemFileiBlobdo odczytywania przesłanych plików bez wysyłania ich gdziekolwiek- WebAssembly dla bibliotek takich jak libheif, libwebp i ffmpeg
- Web Workers do utrzymania responsywnego UI podczas ciężkiej pracy
Jeśli połączysz te elementy, plik nigdy nie opuszcza urządzenia. Serwer nigdy go nie widzi. Nie ma czego logować, nie ma co wyciec, nie ma czego zażądać nakazem sądowym.
Co naprawdę znaczy „po stronie klienta”
Warto być precyzyjnym, bo teksty marketingowe wielu „prywatnych” narzędzi są nieścisłe.
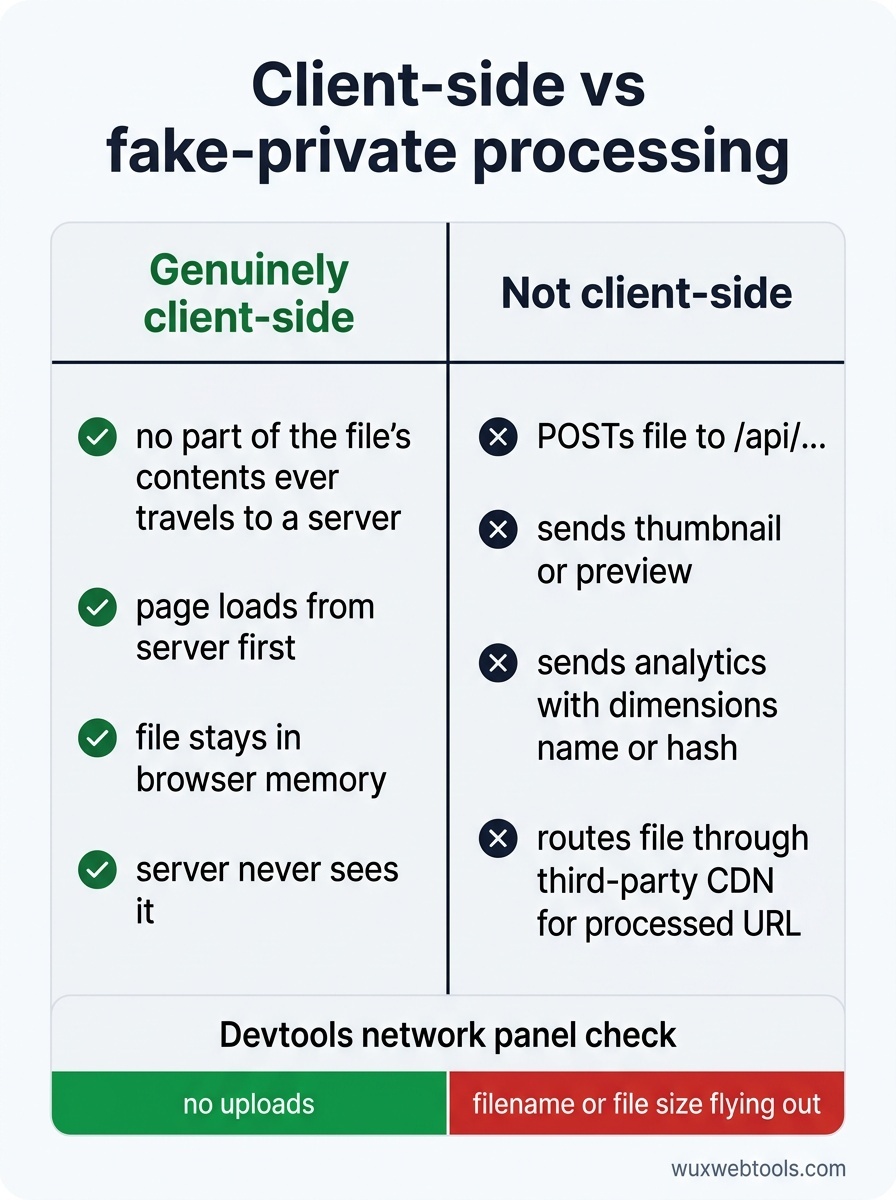
Narzędzie jest naprawdę po stronie klienta wtedy, gdy po załadowaniu strony żadna część zawartości pliku nigdy nie trafia na serwer. Sama strona ładuje się z serwera (HTML, JavaScript, być może moduł WebAssembly). Potem twój plik trafia do pamięci przeglądarki i pozostaje tam, dopóki nie zamkniesz karty.
Narzędzie nie działa po stronie klienta, jeśli:
- wysyła plik metodą POST do endpointu
/api/... - wysyła miniaturę lub podgląd na serwer
- wywołuje endpoint analityczny z metadanymi pliku (wymiary, nazwa, hash)
- kieruje plik przez zewnętrzny CDN, który zwraca przetworzony URL
Panel sieciowy w narzędziach deweloperskich przeglądarki mówi prawdę. Otwórz go, upuść plik i sprawdź, co zostaje wysłane. Jeśli widzisz, że twoja nazwa pliku lub rozmiar pliku wylatują na zewnątrz, narzędzie nie jest tak prywatne, jak twierdzi.
Dlaczego ma to znaczenie w praktyce
Trzy grupy osób po cichu zyskują, gdy przetwarzanie obrazów przenosi się do przeglądarki.
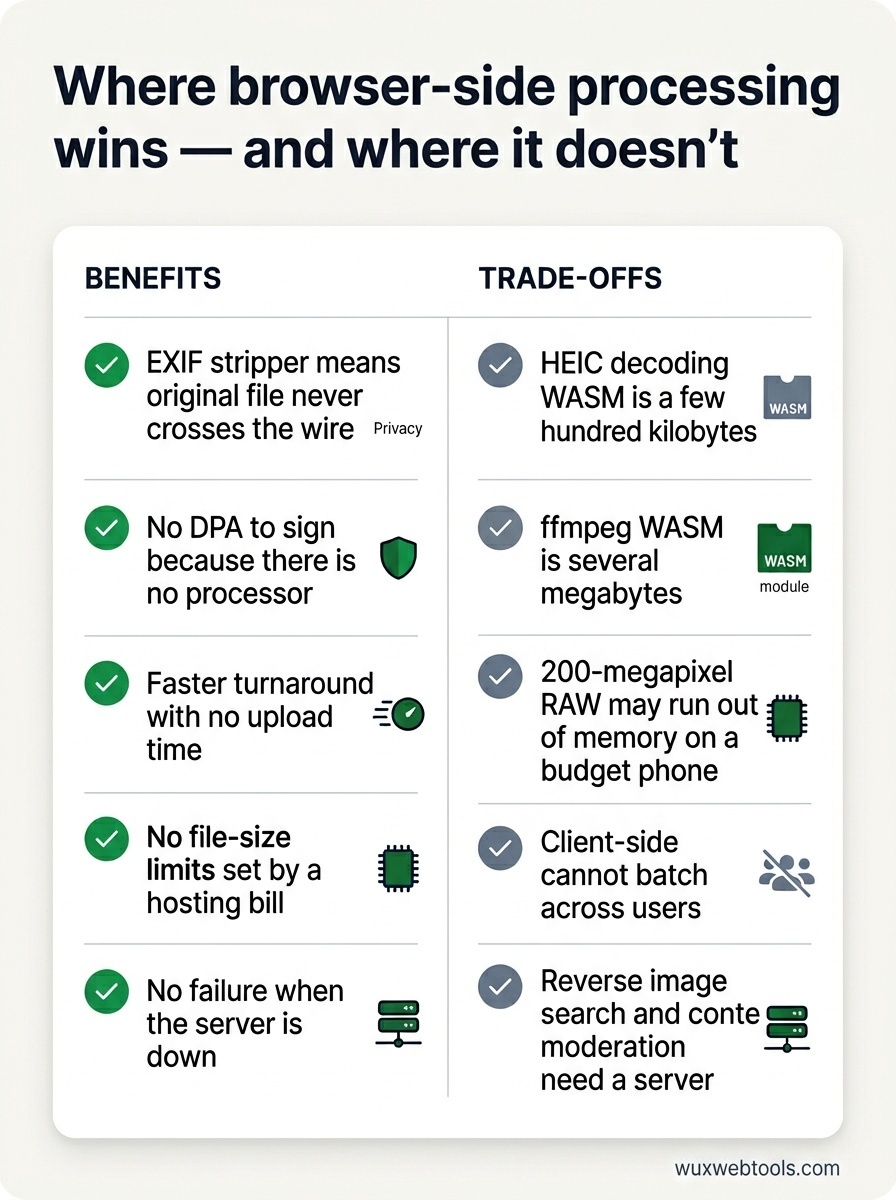
Dziennikarze, aktywiści i badacze pracują z materiałami źródłowymi, których wyciek mógłby być niebezpieczny. Metadane EXIF mogą zawierać współrzędne GPS urządzenia, którym wykonano zdjęcie. Usuwanie EXIF po stronie przeglądarki oznacza, że oryginalny plik nigdy nie przechodzi przez sieć.
Firmy objęte regulacjami — ochrona zdrowia, finanse, branża prawna — w innym przypadku potrzebowałyby umowy powierzenia przetwarzania danych z podmiotem prowadzącym narzędzie. Statyczna strona, która wykonuje pracę lokalnie, nie wymaga podpisywania DPA, ponieważ nie ma procesora.
Wszyscy pozostali otrzymują oczywiste korzyści: szybszy wynik (brak czasu przesyłania), brak limitów rozmiaru pliku wynikających z kosztów hostingu, brak awarii, gdy serwer nie działa.
Gdzie wciąż pozostają kompromisy
Przetwarzanie po stronie klienta nie jest magią. Istnieją realne koszty, które warto przemyśleć, zanim wybierzesz je dla konkretnego problemu.
Zimny start jest cięższy
Pakiet WebAssembly do dekodowania HEIC ma kilkaset kilobajtów. ffmpeg skompilowany do WASM ma kilka megabajtów. Pierwsza wizyta płaci ten koszt. Pomaga cache, a code-splitting pomaga jeszcze bardziej — ładuj tylko ten kodek, który użytkownik faktycznie wybrał.
Sprzęt użytkownika wyznacza górną granicę
Plik RAW o rozdzielczości 200 megapikseli wyczerpie pamięć na budżetowym telefonie na długo przed tym, zanim zrobiłby to na serwerze. W UI trzeba uczciwie pokazać, co jest realistyczne na danym urządzeniu.
Nie możesz wykonywać batchowania między użytkownikami
Przetwarzanie po stronie serwera może deduplikować i amortyzować pracę. Jeśli milion użytkowników konwertuje ten sam obraz stockowy, serwer może przetworzyć go raz. Po stronie klienta dzieje się to milion razy. Dla większości obciążeń typowych dla osobistych narzędzi to w porządku — praca i tak jest unikalna — ale warto o tym wiedzieć.
Niektóre operacje potrzebują serwera
Wyszukiwanie obrazem wymaga indeksu. Moderacja treści wymaga modelu zbyt dużego, by go wysłać do przeglądarki. Wszystko, co porównuje twój plik z korpusem, którego nie posiadasz, wymaga backendu.
Mała uwaga etyczna
Jeśli twoje narzędzie naprawdę działa po stronie klienta, powiedz to wyraźnie i udowodnij. Podlinkuj źródło, wskaż panel sieciowy, wyjaśnij, co działa gdzie. Zwroty w rodzaju „nie przechowujemy twoich danych” nic nie znaczą bez architektury, która je potwierdza — każde narzędzie po stronie serwera, z którego kiedykolwiek wyciekły dane klientów, też mówiło dokładnie to samo i w tamtym momencie miało to na myśli.
Działa to również w drugą stronę. Jeśli twoje narzędzie działa po stronie serwera, nie udawaj, że jest inaczej. Użytkownicy nauczyli się rozpoznawać ten schemat, a utrata zaufania, gdy cię na tym przyłapią, jest trwała.
<!-- tool-cta:start -->
💡 Wypróbuj to: Zobacz przetwarzanie po stronie klienta w akcji dzięki Image Compressor, który zmniejsza obrazy całkowicie w Twojej przeglądarce, dzięki czemu nic nigdy nie jest przesyłane na serwer.
<!-- tool-cta:end -->
Co dalej
Jeśli dziś budujesz małe narzędzie do obrazów, domyślnie wybieraj stronę klienta i sięgaj po serwer tylko wtedy, gdy masz konkretny powód. Przeglądarka zaskoczy cię tym, jak daleko potrafi ponieść pracę — a ludzie po drugiej stronie połączenia sieciowego po cichu podziękują za bajty, które nigdy nie opuściły ich maszyny.
Najczęściej zadawane pytania
Czy przetwarzanie po stronie klienta zawsze jest bardziej prywatne niż po stronie serwera?
Dlaczego więc nie wszystkie narzędzia działają w ten sposób?
Czy WebAssembly spowalnia mój komputer?
A co z bardzo dużymi plikami?
Źródła i dalsza lektura