Hvorfor bildebehandling i nettleseren er en personverngevinst
Hvordan moderne web-API-er lar deg bygge genuint private bildeverktøy — og hva det betyr for dem som bruker dem.
 The Wux Webtools Team
4 min lesing
Innholdsfortegnelse
Standardforventningen er feil
I mesteparten av de siste tjue årene betydde det å gjøre noe ikke-trivielt med et bilde på nettet at man måtte laste det opp til en server. Konvertere et HEIC-bilde, fjerne EXIF-metadata, generere et favicon — alle slike verktøy lå historisk bak et multipart-skjema. Brukeren klikket på last opp, filen reiste over det åpne internettet, og en server et sted gjorde jobben.
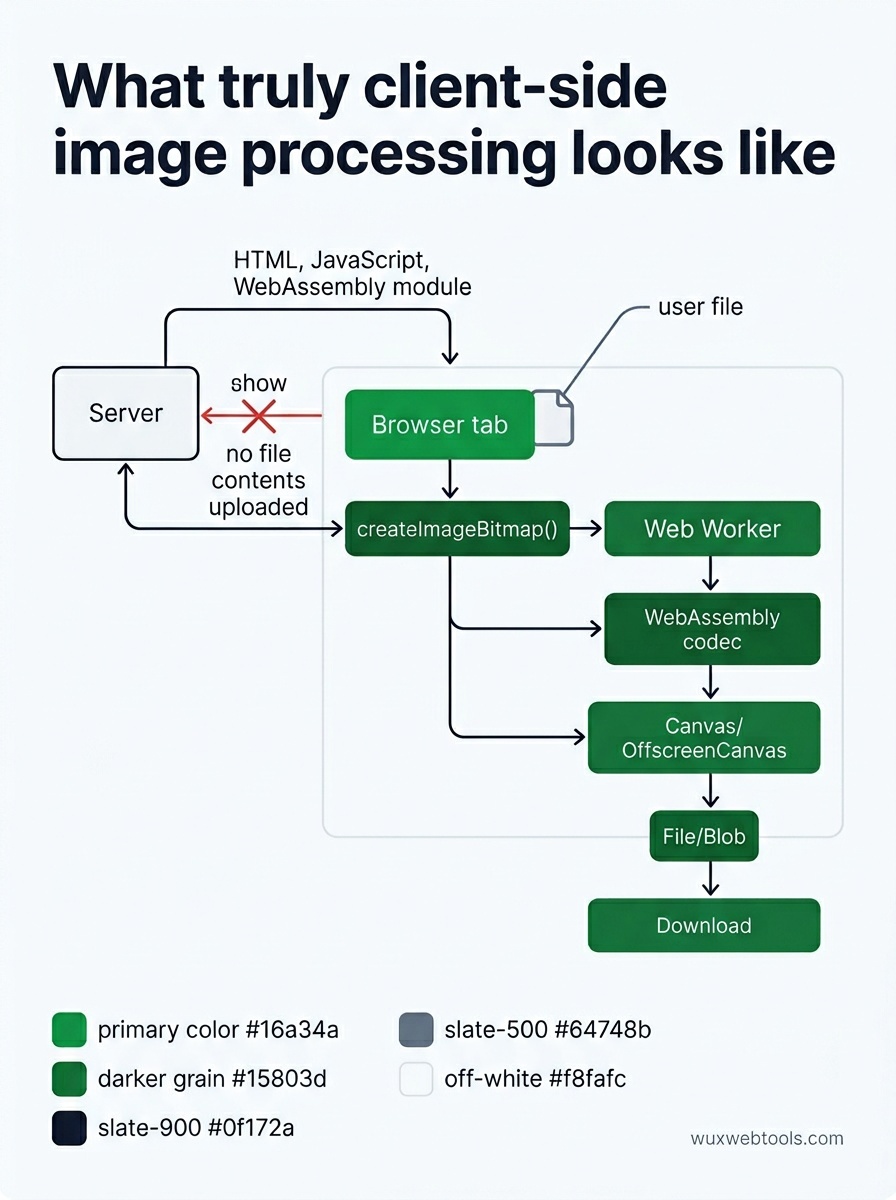
Den standarden er ikke lenger teknisk nødvendig. Nettlesere fikk for flere år siden API-er som gjør at hele prosessen kan kjøres lokalt:
<canvas>andOffscreenCanvasfor arbeid på pikselnivåcreateImageBitmap()for rask dekoding utenfor hovedtrådenFileandBlobfor å lese opplastinger uten å sende dem noe sted- WebAssembly for biblioteker som libheif, libwebp og ffmpeg
- Web Workers for å holde brukergrensesnittet responsivt mens tungt arbeid kjører
Hvis du setter dette sammen, forlater filen aldri enheten. Serveren ser den aldri. Det finnes ingenting å logge, ingenting å lekke, ingenting å kreve utlevert.
Hva "klientside" faktisk betyr
Det er verdt å være presis, fordi markedsføringsteksten på mange "private" verktøy er upresis.
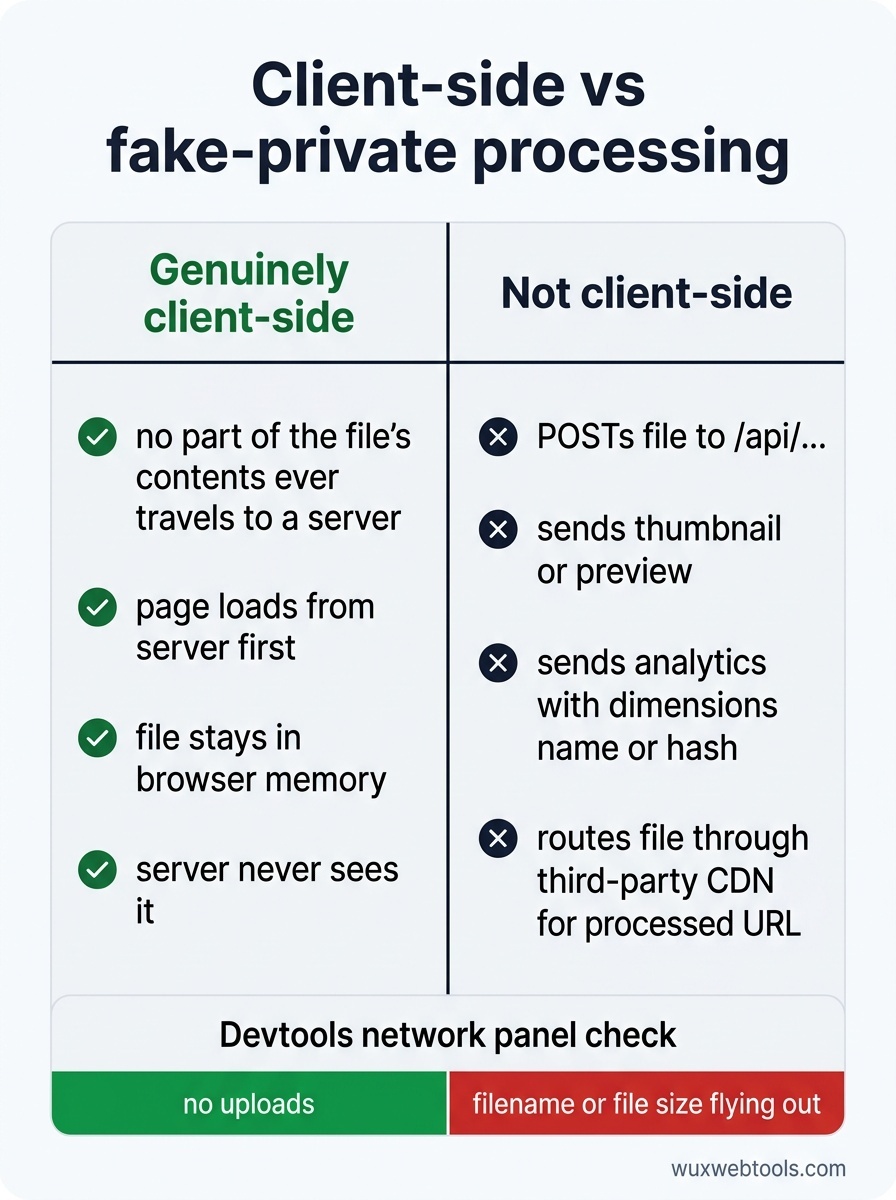
Et verktøy er genuint klientside når, etter at siden er lastet, ingen del av filens innhold noen gang sendes til en server. Selve siden lastes fra en server (HTML, JavaScript, kanskje en WebAssembly-modul). Etter det går filen inn i nettleserens minne og blir der til du lukker fanen.
Et verktøy er ikke klientside hvis det:
- POSTs filen til et
/api/...-endepunkt - Sender et miniatyrbilde eller en forhåndsvisning til en server
- Kaller et analyseendepunkt med filmetadata (dimensjoner, navn, hash)
- Ruter filen gjennom en tredjeparts-CDN som returnerer en behandlet URL
Nettverkspanelet i nettleserens utviklerverktøy forteller sannheten. Åpne det, slipp inn en fil, og sjekk hva som blir lastet opp. Hvis du ser filnavnet ditt eller filstørrelsen din fly ut, er ikke verktøyet så privat som det hevder.
Hvorfor dette betyr noe i praksis
Tre grupper mennesker har en stille fordel av at bildebehandling flyttes inn i nettleseren.
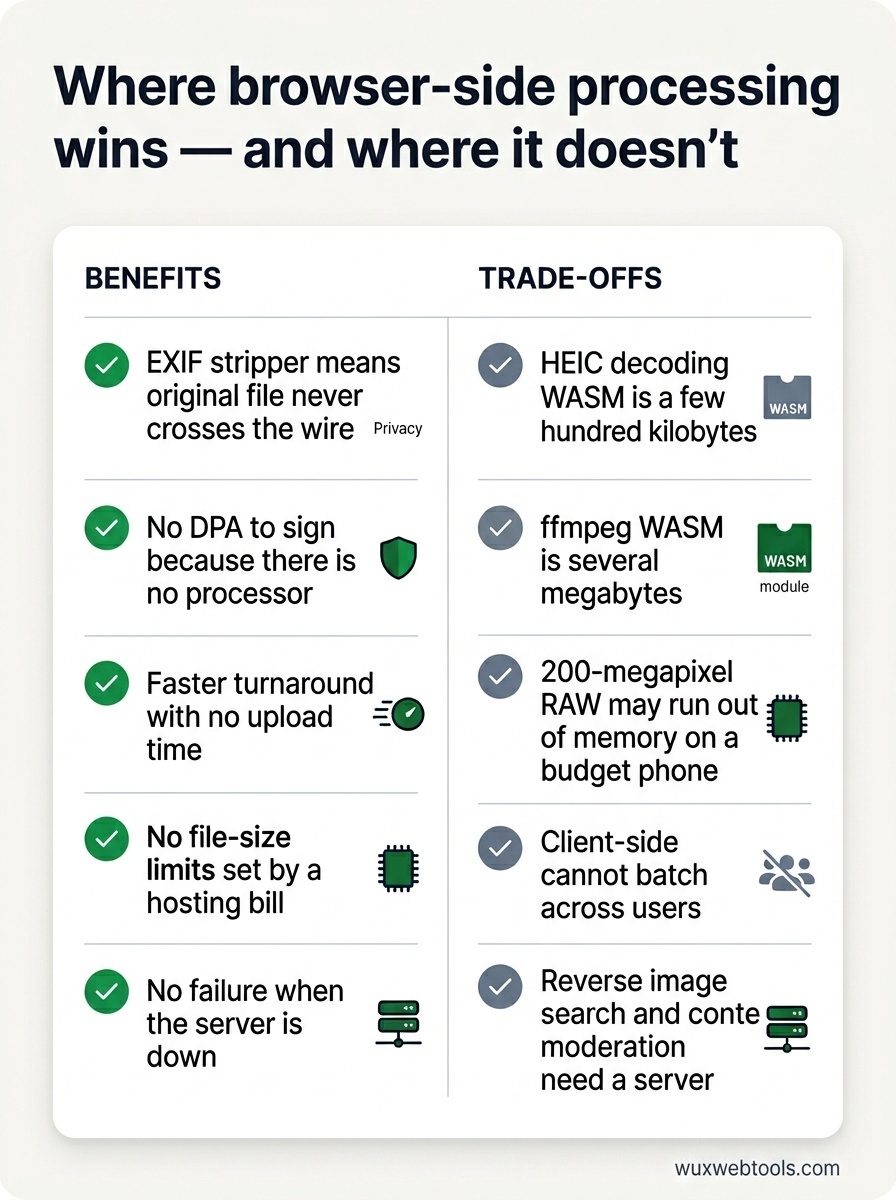
Journalister, aktivister og forskere håndterer kildemateriale som kan være farlig hvis det lekker. EXIF-metadata kan inneholde GPS-koordinater fra enheten som tok bildet. En EXIF-fjerner på nettlesersiden betyr at originalfilen aldri krysser nettet.
Selskaper under regulering — helse, finans, juridisk — ville ellers trengt en databehandleravtale med den som driver verktøyet. En statisk side som gjør arbeidet lokalt, har ingen databehandler å signere avtale med, fordi det ikke finnes noen behandler.
Alle andre får de åpenbare fordelene: raskere gjennomføring (ingen opplastingstid), ingen filstørrelsesgrenser satt av en hostingregning, ingen feil når serveren er nede.
Hvor avveiningene fortsatt finnes
Klientside er ikke magi. Det finnes reelle kostnader du bør tenke gjennom før du velger det for et gitt problem.
Kaldstarten er tyngre
En WebAssembly-pakke for HEIC-dekoding er noen hundre kilobyte. ffmpeg kompilert til WASM er flere megabyte. Første besøk betaler den kostnaden. Hurtigbufring hjelper, og kodeoppdeling hjelper enda mer — last bare inn kodeken brukeren faktisk valgte.
Brukerens maskinvare setter taket
En RAW-fil på 200 megapiksler vil gå tom for minne på en rimelig telefon lenge før den gjør det på en server. Vær ærlig i brukergrensesnittet om hva som er realistisk på enheten.
Du kan ikke batchbehandle på tvers av brukere
Serversidebehandling kan deduplisere og fordele kostnaden. Hvis en million brukere konverterer det samme arkivbildet, kan en server behandle det én gang. Klientside gjør det en million ganger. For de fleste personlige verktøy er dette helt greit — arbeidet er uansett unikt — men det er verdt å vite.
Noen operasjoner trenger en server
Omvendt bildesøk trenger en indeks. Innholdsmoderering trenger en modell som er for stor til å sendes ut. Alt som sammenligner filen din med et korpus du ikke eier, trenger en backend.
Et lite etisk poeng
Hvis verktøyet ditt genuint er klientside, si det tydelig og bevis det. Lenke til kildekoden, pek på nettverkspanelet, forklar hva som kjører hvor. Fraser som "vi lagrer ikke dataene dine" betyr ingenting uten arkitektur som underbygger dem — alle serversideverktøy som noen gang har lekket kundedata, sa også akkurat det, og mente det der og da.
Det motsatte gjelder også. Hvis verktøyet ditt er serverside, ikke lat som noe annet. Brukere har begynt å kjenne igjen mønsteret, og tillitstapet når de tar deg i det, er permanent.
<!-- tool-cta:start -->
💡 Prøv dette: Se klientsidebehandling i praksis med Image Compressor, som krymper bilder helt i nettleseren din, slik at ingenting noen gang lastes opp til en server.
<!-- tool-cta:end -->
Veien videre
Hvis du bygger et lite bildeverktøy i dag, bør standardvalget være klientside, og du bør bare bruke en server når du har en konkret grunn. Nettleseren vil overraske deg med hvor langt den kan bære arbeidet — og menneskene i den andre enden av nettverkstilkoblingen vil stille takke deg for bytene som aldri forlot maskinen deres.
Ofte stilte spørsmål
Er klientsidebehandling alltid mer privat enn serversidebehandling?
Hvorfor fungerer ikke alle verktøy slik da?
Gjør WebAssembly datamaskinen min tregere?
Hva med svært store filer?
Kilder og videre lesning