為什麼在瀏覽器中處理影像是隱私上的加分
現代 Web API 如何讓你打造真正私密的影像工具——以及這對使用者意味著什麼。
 The Wux Webtools Team
4 分鐘閱讀
目錄
預設期待是錯的
在過去二十年的大部分時間裡,要在 Web 上對影像做任何不算簡單的事,都意味著要把它上傳到伺服器。轉換一張 HEIC 照片、移除它的 EXIF metadata、產生 favicon——這些工具在歷史上幾乎都藏在 multipart form 後面。使用者點下 upload,檔案穿越公開網際網路,然後由某處的一台伺服器完成工作。
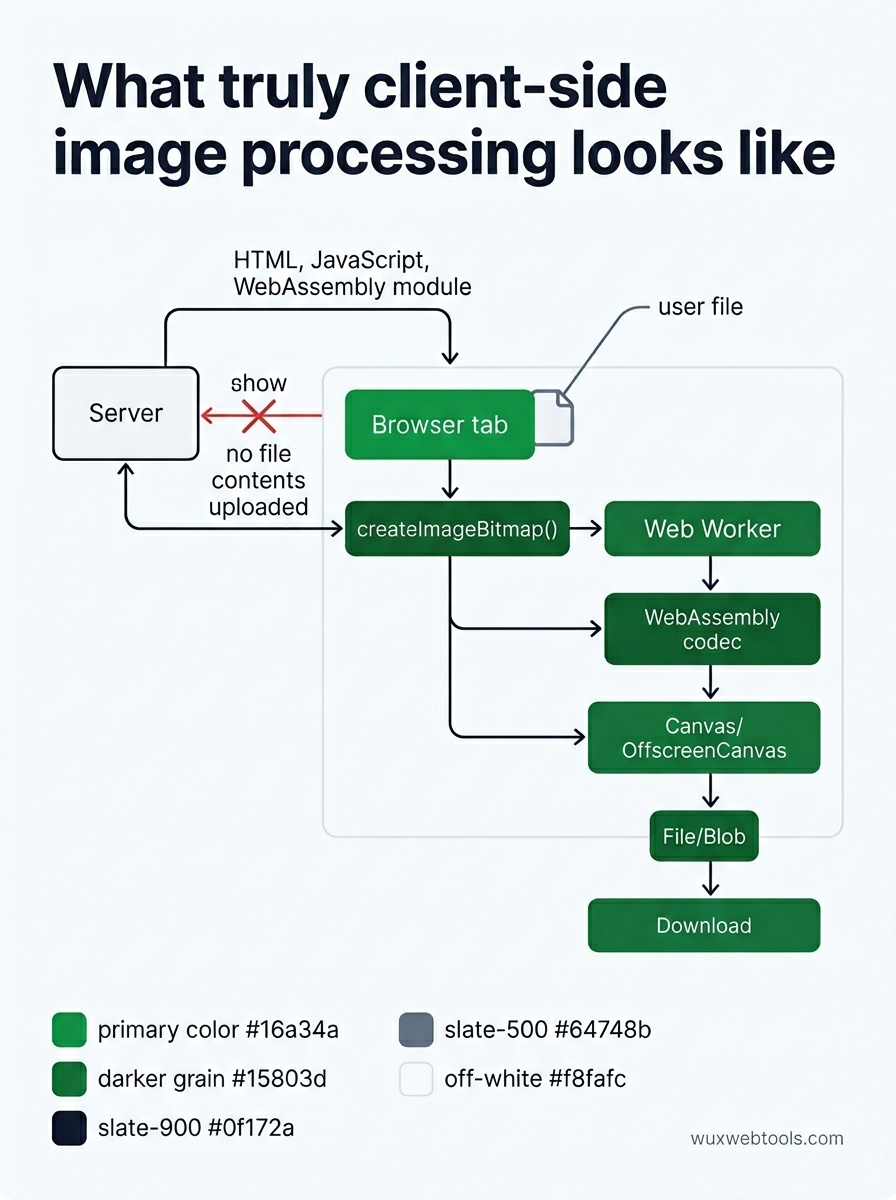
這個預設在技術上已不再必要。瀏覽器多年前就已推出可讓整個流程在本機執行的 API:
<canvas>andOffscreenCanvas用於像素層級的工作createImageBitmap()用於快速、離主執行緒的解碼FileandBlob用於在不把檔案送到任何地方的情況下讀取上傳內容- WebAssembly 用於 libheif、libwebp and ffmpeg 這類函式庫
- Web Workers 讓繁重工作執行時 UI 仍保持回應
如果把這些串在一起,檔案就永遠不會離開裝置。伺服器看不到它。沒有東西可記錄,沒有東西會外洩,也沒有東西可被傳喚調取。
「用戶端」實際上是什麼意思
這件事值得精確說明,因為許多「私密」工具的行銷文案都很寬鬆。
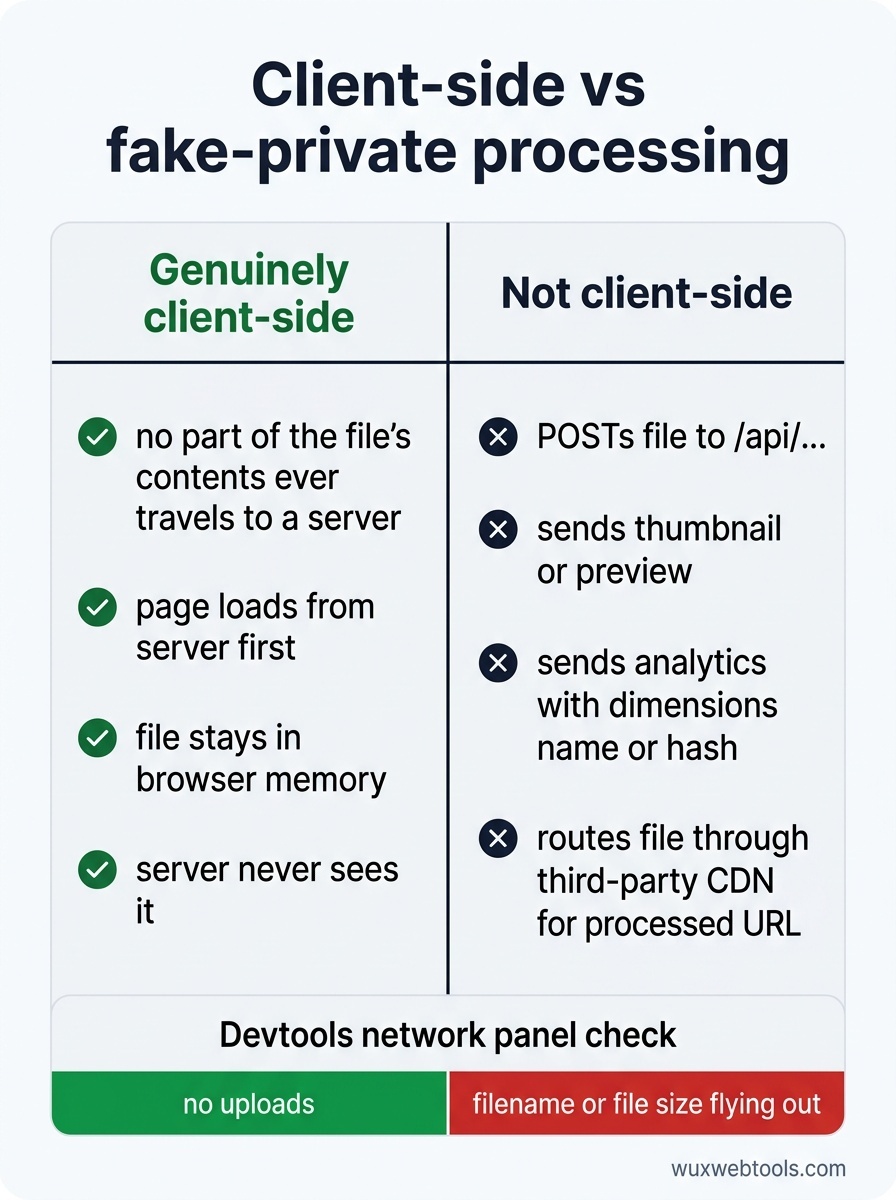
一個工具若是真正的用戶端工具,代表在頁面載入後,檔案內容的任何部分都不會傳到伺服器。頁面本身會從伺服器載入(HTML、JavaScript,或許還有 WebAssembly module)。在那之後,你的檔案進入瀏覽器記憶體,並一直停留在那裡,直到你關閉分頁。
如果一個工具有以下行為,它就不是用戶端工具:
- 將檔案 POST 到
/api/...endpoint - 將縮圖或預覽傳送到伺服器
- 帶著檔案 metadata(尺寸、名稱、hash)呼叫 analytics endpoint
- 透過第三方 CDN 中轉檔案,並回傳處理後的 URL
瀏覽器 devtools 裡的 network panel 會說真話。打開它,放入一個檔案,檢查有什麼被上傳。如果你看到自己的檔名或檔案大小飛出去,這個工具就沒有它宣稱的那麼私密。
為什麼這在實務上很重要
當影像處理移到瀏覽器裡,有三群人會默默受益。
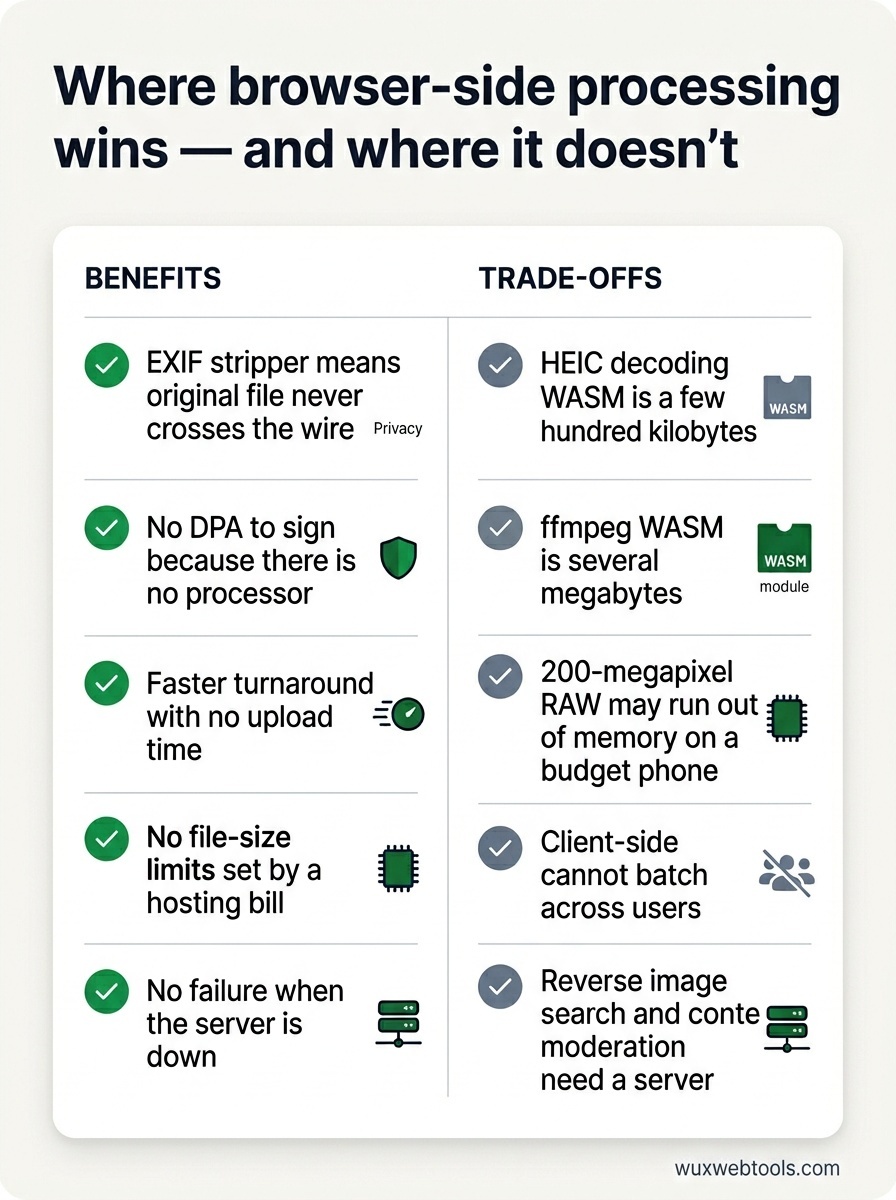
記者、倡議者與研究人員會處理一旦外洩就可能帶來危險的來源素材。EXIF metadata 可能包含拍攝裝置的 GPS 座標。在瀏覽器端移除 EXIF,意味著原始檔永遠不會跨過網路。
受法規約束的公司——醫療、金融、法律——否則通常需要與工具營運方簽署資料處理協議。一個在本機完成工作的靜態頁面沒有 DPA 要簽,因為根本沒有處理者。
其他所有人則得到顯而易見的好處:處理更快(沒有上傳時間)、不受主機帳單設定的檔案大小限制、伺服器當機時也不會失敗。
取捨仍然存在於哪些地方
用戶端不是魔法。在針對特定問題選擇它之前,有些真實成本值得想清楚。
冷啟動較重
用於 HEIC 解碼的 WebAssembly bundle 可能有數百 KB。編譯成 WASM 的 ffmpeg 則有數 MB。首次造訪需要付出這個成本。快取會有幫助,而 code-splitting 幫助更大——只載入使用者實際選擇的 codec。
使用者的硬體決定上限
一個 200-megapixel RAW file 在平價手機上會早在伺服器耗盡資源之前就先耗盡記憶體。UI 應誠實告知在該裝置上什麼是實際可行的。
你無法跨使用者批次處理
伺服器端處理可以去重並攤平成本。如果一百萬名使用者轉換同一張 stock image,伺服器可以只處理一次。用戶端則會做一百萬次。對多數個人工具的工作負載而言這沒問題——反正工作本來就是獨一無二的——但這點值得知道。
有些操作需要伺服器
Reverse image search 需要索引。Content moderation 需要一個大到不適合交付到瀏覽器的模型。任何要把你的檔案與你並不擁有的 corpus 做比較的事情,都需要 backend。
一個小小的倫理重點
如果你的工具確實是用戶端的,就大聲說出來並證明它。連到原始碼、指向 network panel、解釋哪裡執行什麼。像「我們不儲存你的資料」這種說法,如果沒有架構支撐就沒有意義——每一個曾經外洩客戶資料的伺服器端工具也都說過完全一樣的話,而且當時也是真心這麼認為。
反過來也一樣。如果你的工具是伺服器端的,就不要假裝不是。使用者已經開始認得這種模式;一旦被抓到,信任上的損傷就是永久的。
<!-- tool-cta:start -->
💡 試試這個: 使用 Image Compressor 查看用戶端處理的實際效果,它完全在你的瀏覽器中縮小圖片,因此永遠不會有任何內容上傳到伺服器。
<!-- tool-cta:end -->
接下來可以怎麼做
如果你今天正在打造一個小型影像工具,預設採用用戶端,只有在有具體理由時才使用伺服器。瀏覽器能承擔的工作量會讓你意外——而網路連線另一端的人,也會默默感謝那些從未離開他們機器的 bytes。
常見問題
用戶端處理一定比伺服器端更私密嗎?
那為什麼不是所有工具都這樣運作?
WebAssembly 會拖慢我的電腦嗎?
非常大的檔案怎麼辦?
來源與進一步閱讀