Google टूल्स के बिना स्ट्रक्चर्ड डेटा कैसे सत्यापित करें
JSON-LD, Schema.org vocabulary, रेंडर किए गए HTML, और प्रोडक्शन व्यवहार की जाँच के लिए एक व्यावहारिक workflow — Google को सत्य का एकमात्र स्रोत माने बिना।
सामग्री की तालिका
- आप वास्तव में क्या validate कर रहे हैं?
- Step 1: SEO के बारे में सोचने से पहले JSON parse करें
- Step 2: केवल JSON syntax नहीं, JSON-LD behaviour भी check करें
- Step 3: Schema.org vocabulary के against validate करें
- Step 4: Markup की visible content से तुलना करें
- Article और BlogPosting
- Product
- LocalBusiness
- BreadcrumbList
- Step 5: अपने template को नहीं, rendered page को validate करें
- Step 6: Production transport details check करें
- Step 7: अपनी release process में structured data tests जोड़ें
- Standards-first validation checklist
Structured data validation अजीब तरह से Google-facing tools पर निर्भर हो गया है। यह समझ में आता है: कई टीमें JSON-LD इसलिए जोड़ती हैं क्योंकि वे rich results चाहती हैं, और Google के testing tools परिचित हैं। लेकिन structured data कोई Google format नहीं है। यह आम तौर पर Schema.org vocabulary का उपयोग करने वाला JSON-LD होता है, HTML में embedded होता है, कई consumers द्वारा interpreted होता है, और आपके अपने publishing workflow द्वारा maintained होता है।
यदि आप केवल search-engine lens से validation करते हैं, तो आप बुनियादी समस्याएँ छोड़ सकते हैं: invalid JSON, rendering के बाद गायब हो जाने वाला data, stale product prices, conflicting canonical URLs, या ऐसा markup जो technically valid है लेकिन semantically कमजोर है।
एक बेहतर workflow standards-first है। पहले data को data के रूप में validate करें, फिर vocabulary validate करें, फिर page को उस रूप में validate करें जिसमें वह production में मौजूद है।
आप वास्तव में क्या validate कर रहे हैं?
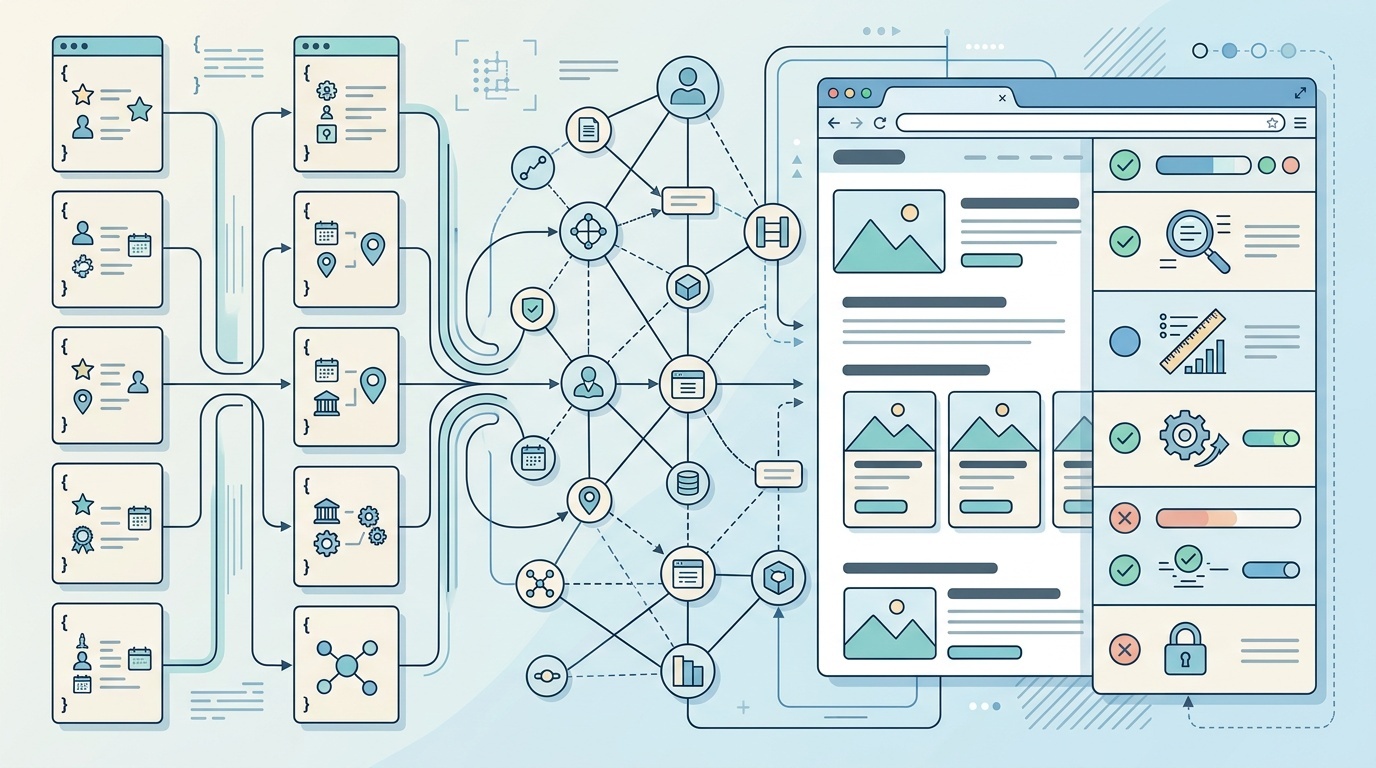
“Structured data” एक ही चीज़ नहीं है। अधिकांश websites पर इसकी चार layers होती हैं:
- JSON syntax — क्या code parse हो सकता है?
- JSON-LD model — क्या यह meaningful linked data में expand होता है?
- Schema.org vocabulary — क्या types और properties plausible हैं?
- Page-level truth — क्या markup उस चीज़ से मेल खाता है जो users और crawlers देख सकते हैं?
Google tools अधिकतर चौथी layer और Google-specific rich-result eligibility पर focus करते हैं। उपयोगी, हाँ। पूर्ण, नहीं।
उदाहरण के लिए, यह valid JSON-LD हो सकता है और फिर भी poor structured data हो सकता है:
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "Best winter jackets",
  "datePublished": "2026-01-12",
  "author": {
    "@type": "Organization",
    "name": "Editorial Team"
  }
}
यहाँ कुछ टूटा हुआ नहीं है। लेकिन यदि visible page में अलग headline है, कोई author attribution नहीं है, और last-modified date markup से contradict करती है, तो आपके पास syntax problem के बजाय quality problem है।
Step 1: SEO के बारे में सोचने से पहले JSON parse करें
सबसे साधारण check से शुरू करें: क्या JSON parse हो सकता है?
HTML में embedded JSON-LD अक्सर छोटे template mistakes के कारण टूट जाता है:
- trailing commas
- product names में unescaped quotes
- strings के अंदर invalid line breaks
- conditional fields के बाद missing braces
- layout inheritance से duplicate script blocks
- partial objects output करने वाले CMS plugins
Local checks के लिए आपको SEO platform की आवश्यकता नहीं है। अपने development stack में पहले से मौजूद tools का उपयोग करें।
JavaScript में:
const blocks = [...document.querySelectorAll('script[type="application/ld+json"]')];

for (const block of blocks) {
  try {
    JSON.parse(block.textContent);
  } catch (error) {
    console.error('Invalid JSON-LD:', error.message, block);
  }
}
CI में, rendered HTML से script contents extract करें और उन्हें JSON के रूप में parse करें। इससे कई समस्याएँ production तक पहुँचने से पहले पकड़ी जाती हैं।
महत्वपूर्ण बात: यह किसी भी Schema.org validation से पहले करें। यदि data valid JSON नहीं है, तो vocabulary validator मदद नहीं कर सकता।
Step 2: केवल JSON syntax नहीं, JSON-LD behaviour भी check करें
Valid JSON अपने आप valid JSON-LD नहीं होता। JSON-LD @context, @type, @id, और graph relationships जैसी concepts का उपयोग करता है। यदि ये malformed हैं, तो parsers आपके data को आपकी intention से अलग तरह से interpret कर सकते हैं।
कम से कम यह confirm करें:
- हर block में appropriate
@contextहो - primary entities में स्पष्ट
@typevalues हों - repeated entities जहाँ उपयोगी हो, वहाँ stable
@idvalues का उपयोग करें - nested entities logically connected हों
- जब multiple values possible हों, तो arrays का उपयोग हो
बड़ी sites के लिए stable identifiers विशेष रूप से helpful होते हैं। यदि आपकी organization Article, Product, BreadcrumbList, और FAQPage data में दिखाई देती है, तो समान @id का उपयोग consumers को समझने में मदद करता है कि ये एक ही entity के references हैं, समान नाम वाली चार unrelated organizations नहीं।
एक typical pattern ऐसा दिखता है:
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "@id": "https://example.com/#organization",
  "name": "Example Ltd",
  "url": "https://example.com/"
}
यहाँ आप validator को प्रभावित करने की कोशिश नहीं कर रहे। आप अपने data को कम ambiguous बना रहे हैं।
Step 3: Schema.org vocabulary के against validate करें
जब JSON और JSON-LD structure ठीक हो जाएँ, तो vocabulary check करें।
Schema.org validator उपयोगी है क्योंकि यह एक search engine के rich-result rules के बजाय Schema.org terms के against test करता है। यह दिखा सकता है कि properties recognized हैं या नहीं, types expected तरीके से interpreted हो रहे हैं या नहीं, और आपकी nested structures समझ में आती हैं या नहीं।
यहीं आप ऐसी mistakes पकड़ते हैं:
datePublishedके बजायpublishingDate- जहाँ
imageexpected है वहाँimageUrl - ऐसी category listing पर
Productmarkup जो product नहीं है - meaningful reviewed item के बिना
AggregateRating - brand account के लिए
Personका उपयोग
Warnings के साथ सावधान रहें। Schema.org जानबूझकर flexible है। Validator ऐसी property allow कर सकता है जो आपके use case के लिए उपयोगी नहीं है, या ऐसी चीज़ पर warning दे सकता है जो optional है। Validation को evidence मानें, verdict नहीं।
एक practical rule: यदि कोई property machine को page अधिक accurately समझने में मदद करती है, तो उसे रखें। यदि वह केवल इसलिए मौजूद है क्योंकि किसी ने उसे snippet generator से copy किया है, तो उस पर सवाल करें।
Step 4: Markup की visible content से तुलना करें
Search engines और अन्य data consumers ऐसे markup पर भरोसा कम करते हैं जो page से match नहीं करता। इससे भी महत्वपूर्ण बात, users consistency deserve करते हैं।
हर structured data type के लिए, markup की visible page से तुलना करें:
Article और BlogPosting
Check करें कि headline, author, published date, modified date, image, और publisher visible हैं या reasonably inferable हैं। यदि आप AI-assisted content publish करते हैं, तो आपके structured data का उपयोग unclear authorship को launder करने के लिए नहीं होना चाहिए। हमने छोटी website पर ईमानदार AI disclosure कैसा दिखता है के बारे में अलग से लिखा है, और वही principle यहाँ भी लागू होता है: metadata को clarify करना चाहिए, obscure नहीं।
Product
Name, price, availability, currency, variants, ratings, और review counts check करें। Product structured data विशेष रूप से stale होने की संभावना रखता है क्योंकि prices और stock status CMS के बाहर बदलते हैं।
LocalBusiness
Name, address, phone number, opening hours, और service area check करें। यदि आपके footer में कुछ और लिखा है और आपके JSON-LD में कुछ और, तो JSON-LD “better” नहीं है। वह contradictory है।
BreadcrumbList
Check करें कि breadcrumb positions visible breadcrumb trail से match करती हैं और URLs canonical, crawlable, और अनावश्यक रूप से redirected नहीं हैं।
यह glamorous work नहीं है। यही वह जगह भी है जहाँ structured data की कई problems मिलती हैं।
Step 5: अपने template को नहीं, rendered page को validate करें
कई sites JavaScript, tag managers, personalization layers, या component hydration के माध्यम से JSON-LD generate करती हैं। इसका मतलब है कि template file शायद वह नहीं दिखाती जो crawler या browser वास्तव में देखता है।
Rendered HTML को कम से कम तीन states में validate करें:
- local development build
- staging या preview URL
- production URL
Final DOM inspect करने के लिए browser DevTools का उपयोग करें। application/ld+json search करें और rendering के बाद मौजूद exact script content copy करें। यदि server-rendered markup hydrated markup से अलग है, तो तय करें कि आप consumers से कौन-सा version पढ़ने की अपेक्षा रखते हैं।
यह भी check करें कि structured data duplicate तो नहीं हो रहा। Duplicate Article या Product blocks आम हैं जब कोई CMS plugin और custom component दोनों schema emit करते हैं। Duplication हमेशा fatal नहीं होता, लेकिन conflicting duplication समस्या है: दो prices, दो authors, दो publication dates, या दो canonical URLs।
यह performance और diagnostics reports पढ़ने जैसा है: पहला task panic करना नहीं, बल्कि signal को noise से अलग करना है। यही habit तब भी मदद करती है जब आप बिना panic किए Lighthouse report पढ़ते हैं — हालाँकि structured data को स्वयं single score तक reduce नहीं किया जाना चाहिए।
Step 6: Production transport details check करें
Structured data आपके source में perfect हो सकता है और फिर भी production में fail हो सकता है क्योंकि page उस तरह accessible नहीं है जैसा आप मान रहे हैं।
Check करें:
- final status code
200है, soft 404 नहीं - canonical URL उस page से match करता है जिसे आप validate कर रहे हैं
- redirects intentional और stable हैं
- robots directives indexing को block नहीं करते जहाँ indexing expected है
- कुछ user agents के लिए HTML error page से replace नहीं हो रहा
- cached pages stale JSON-LD serve नहीं कर रहे
यहीं HTTP inspection महत्वपूर्ण होता है। यदि कोई product page canonical destination तक पहुँचने से पहले तीन URLs से redirect होता है, तो final page validate करें, CMS से copy किए गए पहले URL को नहीं। Raw mechanics के लिए, production में redirects और HTTP headers debug करने की हमारी guide उपयोगी companion है।
Structured data vacuum में नहीं रहता। यह headers, redirects, caching, canonical tags, और robots directives के साथ travel करता है।
Step 7: अपनी release process में structured data tests जोड़ें
Manual validation एक page के लिए ठीक है। यह सैकड़ों या हज़ारों URLs पर scale नहीं करता।
एक simple automated test suite सबसे महँगी mistakes पकड़ सकता है:
- हर template type से representative URLs fetch करें
- सभी JSON-LD blocks extract करें
- उन्हें
JSON.parseसे parse करें - हर page type के लिए required fields assert करें
- check करें कि dates valid ISO 8601 strings हैं
- check करें कि URLs absolute और canonical हैं
- product pages के लिए prices और availability मौजूद हैं
- check करें कि duplicate entities conflict नहीं करतीं
आप इसे templates के लिए CI में और production URLs के लिए schedule पर run कर सकते हैं। Goal यह prove करना नहीं है कि हर rich-result feature दिखाई देगा। Search engine के बाहर कोई भी इसका promise नहीं कर सकता। Goal यह है कि आपका अपना data accurate, parseable, और consistent रहे।
<!-- tool-cta:start -->
💡 इसे आज़माएँ: स्कीमा लॉजिक को मान्य करने से पहले, अपने JSON-LD को JSON Formatter से गुज़ारें ताकि वे सिंटैक्स त्रुटियाँ पकड़ी जा सकें जो अन्यथा हर बाद की जाँच को तोड़ देंगी।
<!-- tool-cta:end -->
Standards-first validation checklist
Search engine को page पसंद है या नहीं, यह पूछने से पहले इस short checklist का उपयोग करें:
- क्या हर JSON-LD block valid JSON है?
- क्या हर block में correct
@contextऔर@typeशामिल हैं? - क्या Schema.org properties सही spelling के साथ हैं?
- क्या markup visible content से match करता है?
- क्या dates, prices, ratings, और availability current हैं?
- क्या URLs absolute, canonical, और reachable हैं?
- क्या rendered production page वही page है जिसे आपने test किया था?
- क्या duplicate entities intentional और non-conflicting हैं?
यदि आप इन questions का yes में answer दे सकते हैं, तो आपने structured data work का durable part पूरा कर लिया है। Search-specific testing बाद में अभी भी उपयोगी हो सकती है, लेकिन यह आपकी validation process की foundation नहीं, final compatibility check होनी चाहिए।
अक्सर पूछे जाने वाले प्रश्न
क्या मैं Google का बिल्कुल उपयोग किए बिना structured data validate कर सकता हूँ?
क्या valid Schema.org markup rich results पाने के लिए पर्याप्त है?
क्या structured data हमेशा server-rendered होना चाहिए?
Production structured data कितनी बार check किया जाना चाहिए?
सबसे common structured data mistake क्या है?
स्रोत और आगे की पढ़ाई