Sådan validerer du strukturerede data uden Google-værktøjer
En praktisk arbejdsgang til at kontrollere JSON-LD, Schema.org-vokabular, renderet HTML og produktionsadfærd uden at behandle Google som den eneste kilde til sandhed.
Indholdsfortegnelse
- Hvad validerer du egentlig?
- Trin 1: Parse JSON, før du tænker på SEO
- Trin 2: Kontrollér JSON-LD-adfærd, ikke kun JSON-syntaks
- Trin 3: Valider mod Schema.org-vokabular
- Trin 4: Sammenlign markup med synligt indhold
- Article og BlogPosting
- Product
- LocalBusiness
- BreadcrumbList
- Trin 5: Valider den renderede side, ikke din skabelon
- Trin 6: Kontrollér transportdetaljer i produktion
- Trin 7: Tilføj tests af strukturerede data til din releaseproces
- En standarder først-tjekliste til validering
Validering af strukturerede data er blevet mærkeligt afhængig af Google-vendte værktøjer. Det er forståeligt: Mange teams tilføjer JSON-LD, fordi de ønsker rich results, og Googles testværktøjer er velkendte. Men strukturerede data er ikke et Google-format. Det er som regel JSON-LD med Schema.org-vokabular, indlejret i HTML, fortolket af mange forbrugere og vedligeholdt af din egen publiceringsproces.
Hvis du kun validerer gennem en søgemaskineoptik, kan du overse grundlæggende problemer: ugyldig JSON, data der forsvinder efter rendering, forældede produktpriser, modstridende canonical-URL’er eller markup, der teknisk set er gyldig, men semantisk fjollet.
En bedre arbejdsgang starter med standarderne. Valider data som data, valider derefter vokabularet, og valider så siden, som den findes i produktion.
Hvad validerer du egentlig?
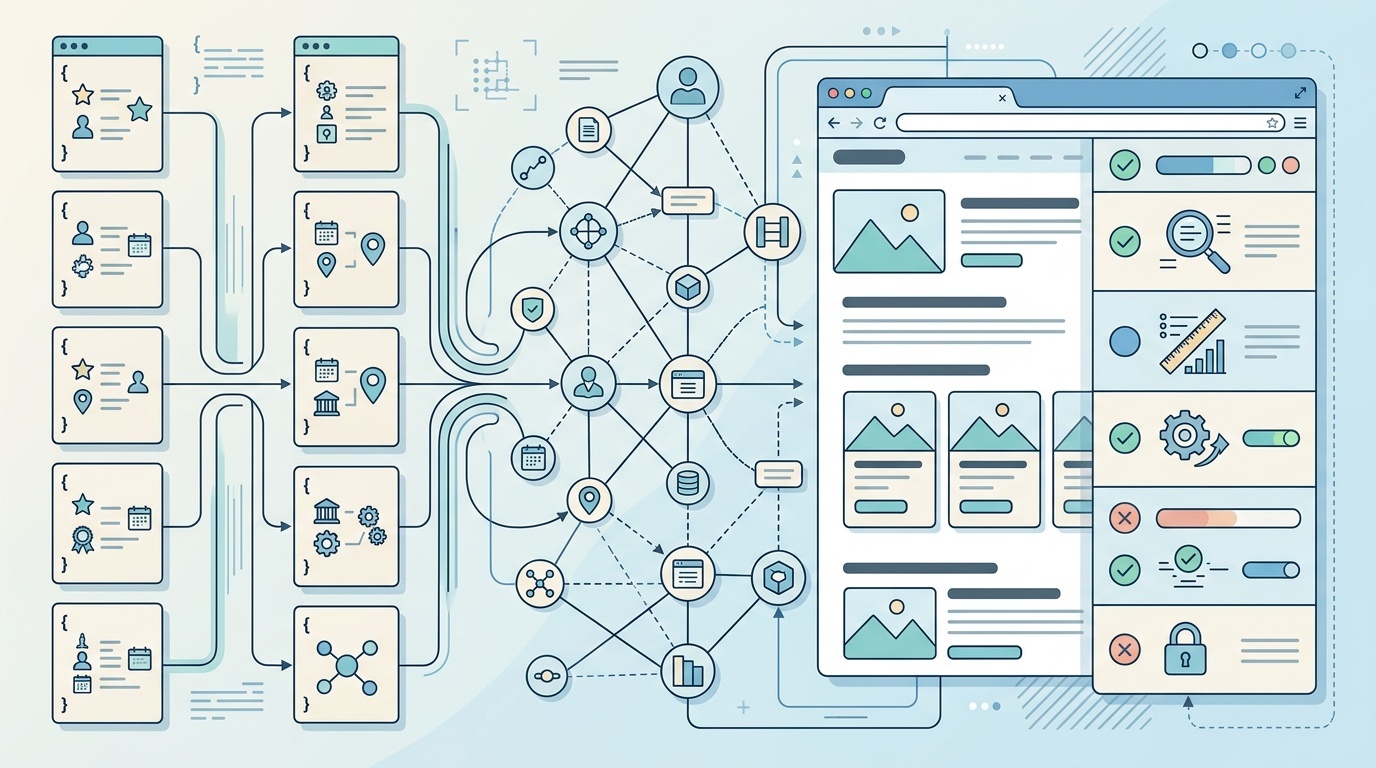
“Strukturerede data” er ikke én ting. På de fleste websites har det fire lag:
- JSON-syntaks — kan koden parses?
- JSON-LD-model — udvides den til meningsfulde linked data?
- Schema.org-vokabular — er typerne og egenskaberne plausible?
- Sandhed på sideniveau — matcher markuppen det, som brugere og crawlere kan se?
Google-værktøjer fokuserer primært på det fjerde lag plus Google-specifik berettigelse til rich results. Nyttigt, ja. Komplet, nej.
For eksempel kan dette være gyldigt JSON-LD og stadig være dårlige strukturerede data:
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "Best winter jackets",
  "datePublished": "2026-01-12",
  "author": {
    "@type": "Organization",
    "name": "Editorial Team"
  }
}
Der er ikke noget ødelagt her. Men hvis den synlige side har en anden overskrift, ingen forfatterangivelse og en senest ændret-dato, der modsiger markuppen, har du et kvalitetsproblem snarere end et syntaksproblem.
Trin 1: Parse JSON, før du tænker på SEO
Start med den kedelige kontrol: Kan JSON’en parses?
JSON-LD indlejret i HTML går ofte i stykker på grund af små skabelonfejl:
- afsluttende kommaer
- ikke-escapede citationstegn i produktnavne
- ugyldige linjeskift inde i strenge
- manglende klammer efter betingede felter
- duplikerede scriptblokke fra layoutarv
- CMS-plugins, der outputter delvise objekter
Til lokale kontroller behøver du ikke en SEO-platform. Brug de værktøjer, der allerede findes i din udviklingsstack.
I JavaScript:
const blocks = [...document.querySelectorAll('script[type="application/ld+json"]')];

for (const block of blocks) {
  try {
    JSON.parse(block.textContent);
  } catch (error) {
    console.error('Invalid JSON-LD:', error.message, block);
  }
}
I CI kan du udtrække scriptindholdet fra renderet HTML og parse det som JSON. Det fanger mange problemer, før de når produktion.
Det vigtige punkt: Gør dette før nogen Schema.org-validering. En vokabularvalidator kan ikke hjælpe, hvis dataene ikke er gyldig JSON.
Trin 2: Kontrollér JSON-LD-adfærd, ikke kun JSON-syntaks
Gyldig JSON er ikke automatisk gyldig JSON-LD. JSON-LD bruger begreber som @context, @type, @id og grafrelationer. Hvis de er fejlformet, kan parsere fortolke dine data anderledes, end du havde tænkt.
Bekræft som minimum:
- at hver blok har en passende
@context - at primære entiteter har klare
@type-værdier - at gentagne entiteter bruger stabile
@id-værdier, hvor det er nyttigt - at indlejrede entiteter er logisk forbundne
- at arrays bruges, når flere værdier er mulige
For større sites er stabile identifikatorer særligt nyttige. Hvis din organisation optræder i Article-, Product-, BreadcrumbList- og FAQPage-data, hjælper brugen af den samme @id forbrugere med at forstå, at der er tale om referencer til den samme entitet, ikke fire urelaterede organisationer med samme navn.
Et typisk mønster ser sådan ud:
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "@id": "https://example.com/#organization",
  "name": "Example Ltd",
  "url": "https://example.com/"
}
Du prøver ikke at imponere en validator her. Du gør dine data mindre tvetydige.
Trin 3: Valider mod Schema.org-vokabular
Når JSON- og JSON-LD-strukturen er sund, skal du kontrollere vokabularet.
Schema.org-validatoren er nyttig, fordi den tester mod Schema.org-termer i stedet for én søgemaskines regler for rich results. Den kan vise, om egenskaber genkendes, om typer fortolkes som forventet, og om dine indlejrede strukturer giver mening.
Det er her, du fanger fejl som:
publishingDatei stedet fordatePublishedimageUrl, hvorimageforventesProduct-markup på en kategoriliste, der ikke er et produktAggregateRatinguden et meningsfuldt anmeldt elementPersonbrugt til en brandkonto
Vær varsom med advarsler. Schema.org er med vilje fleksibelt. En validator kan tillade en egenskab, der ikke er nyttig for dit use case, eller advare om noget, der er valgfrit. Behandl validering som evidens, ikke som en dom.
En praktisk regel: Hvis en egenskab hjælper en maskine med at forstå siden mere præcist, så behold den. Hvis den kun findes, fordi nogen kopierede den fra en snippet-generator, så sæt spørgsmålstegn ved den.
Trin 4: Sammenlign markup med synligt indhold
Søgemaskiner og andre dataforbrugere har tendens til at mistro markup, der ikke matcher siden. Endnu vigtigere: Brugere fortjener konsistens.
For hver type strukturerede data skal du sammenligne markuppen med den synlige side:
Article og BlogPosting
Kontrollér, at overskrift, forfatter, publiceringsdato, ændringsdato, billede og udgiver er synlige eller rimeligt kan udledes. Hvis du publicerer AI-assisteret indhold, bør dine strukturerede data ikke bruges til at hvidvaske uklart forfatterskab. Vi har skrevet separat om ærlig AI-deklaration på et lille website, og det samme princip gælder her: Metadata bør afklare, ikke sløre.
Product
Kontrollér navn, pris, tilgængelighed, valuta, varianter, bedømmelser og antal anmeldelser. Produktstrukturerede data har særligt let ved at blive forældede, fordi priser og lagerstatus ændrer sig uden for CMS’et.
LocalBusiness
Kontrollér navn, adresse, telefonnummer, åbningstider og serviceområde. Hvis din footer siger én ting, og din JSON-LD siger noget andet, er JSON-LD’en ikke “bedre”. Den er modstridende.
BreadcrumbList
Kontrollér, at breadcrumb-positioner matcher den synlige breadcrumb-sti, og at URL’er er canonical, crawlbare og ikke omdirigeres unødigt.
Det er ikke glamourøst arbejde. Det er også her, mange problemer med strukturerede data findes.
Trin 5: Valider den renderede side, ikke din skabelon
Mange sites genererer JSON-LD gennem JavaScript, tag managers, personaliseringslag eller component hydration. Det betyder, at skabelonfilen måske ikke repræsenterer det, en crawler eller browser faktisk ser.
Valider den renderede HTML i mindst tre tilstande:
- lokalt udviklingsbuild
- staging- eller preview-URL
- produktions-URL
Brug browserens DevTools til at inspicere den endelige DOM. Søg efter application/ld+json, og kopier det præcise scriptindhold, der findes efter rendering. Hvis server-renderet markup adskiller sig fra hydreret markup, skal du beslutte, hvilken version du forventer, at forbrugere læser.
Kontrollér også, om strukturerede data bliver duplikeret. Duplikerede Article- eller Product-blokke er almindelige, når et CMS-plugin og en specialbygget komponent begge udsender schema. Duplikering er ikke altid fatalt, men modstridende duplikering er et problem: to priser, to forfattere, to publiceringsdatoer eller to canonical-URL’er.
Dette minder om at læse performance- og diagnosticeringsrapporter: Den første opgave er ikke at gå i panik, men at adskille signal fra støj. Den samme vane hjælper, når du læser en Lighthouse-rapport uden at gå i panik — selvom strukturerede data i sig selv ikke bør reduceres til én score.
Trin 6: Kontrollér transportdetaljer i produktion
Strukturerede data kan være perfekte i din kilde og stadig fejle i produktion, fordi siden ikke er tilgængelig på den måde, du antager.
Kontrollér:
- at den endelige statuskode er
200, ikke en soft 404 - at canonical-URL’en matcher den side, du validerer
- at redirects er tilsigtede og stabile
- at robots-direktiver ikke blokerer indeksering, hvor indeksering forventes
- at HTML ikke erstattes af en fejlside for visse user agents
- at cachede sider ikke serverer forældet JSON-LD
Det er her, HTTP-inspektion betyder noget. Hvis en produktside omdirigerer gennem tre URL’er, før den når en canonical-destination, skal du validere den endelige side, ikke den første URL kopieret fra CMS’et. For den rå mekanik er vores guide til fejlfinding af redirects og HTTP-headers i produktion en nyttig ledsager.
Strukturerede data lever ikke i et vakuum. De rejser sammen med headers, redirects, caching, canonical-tags og robots-direktiver.
Trin 7: Tilføj tests af strukturerede data til din releaseproces
Manuel validering er fint for én side. Det skalerer ikke på tværs af hundreder eller tusinder af URL’er.
En enkel automatiseret testsuite kan fange de dyreste fejl:
- hent repræsentative URL’er fra hver skabelontype
- udtræk alle JSON-LD-blokke
- parse dem med
JSON.parse - assert påkrævede felter for hver sidetype
- kontrollér, at datoer er gyldige ISO 8601-strenge
- kontrollér, at URL’er er absolutte og canonical
- kontrollér, at priser og tilgængelighed findes for produktsider
- kontrollér, at duplikerede entiteter ikke er i konflikt
Du kan køre dette i CI for skabeloner og efter en tidsplan for produktions-URL’er. Målet er ikke at bevise, at alle rich-result-funktioner vil blive vist. Ingen uden for søgemaskinen kan love det. Målet er at holde dine egne data nøjagtige, parsebare og konsistente.
<!-- tool-cta:start -->
💡 Prøv dette: Før du validerer skemalogik, skal du køre din JSON-LD gennem JSON Formatter for at fange syntaksfejl, der ellers ville ødelægge hver efterfølgende kontrol.
<!-- tool-cta:end -->
En standarder først-tjekliste til validering
Brug denne korte tjekliste, før du spørger, om en søgemaskine kan lide siden:
- Er hver JSON-LD-blok gyldig JSON?
- Indeholder hver blok den korrekte
@contextog@type? - Er Schema.org-egenskaber stavet korrekt?
- Matcher markuppen det synlige indhold?
- Er datoer, priser, bedømmelser og tilgængelighed aktuelle?
- Er URL’er absolutte, canonical og tilgængelige?
- Er den renderede produktionsside den samme side, du testede?
- Er duplikerede entiteter tilsigtede og uden konflikter?
Hvis du kan svare ja til disse spørgsmål, har du gjort den holdbare del af arbejdet med strukturerede data. Søgespecifik test kan stadig være nyttig senere, men den bør være det sidste kompatibilitetstjek, ikke fundamentet for din valideringsproces.
Ofte stillede spørgsmål
Kan jeg validere strukturerede data uden overhovedet at bruge Google?
Er gyldig Schema.org-markup nok til at opnå rich results?
Bør strukturerede data altid server-renderes?
Hvor ofte bør strukturerede data i produktion kontrolleres?
Hvad er den mest almindelige fejl med strukturerede data?
Kilder & videre læsning