Jak walidować dane strukturalne bez narzędzi Google
Praktyczny proces sprawdzania JSON-LD, słownika Schema.org, wyrenderowanego HTML-a i zachowania w produkcji bez traktowania Google jako jedynego źródła prawdy.
Spis treści
- Co właściwie walidujesz?
- Krok 1: Parsuj JSON, zanim pomyślisz o SEO
- Krok 2: Sprawdź zachowanie JSON-LD, nie tylko składnię JSON
- Krok 3: Waliduj względem słownika Schema.org
- Krok 4: Porównaj znaczniki z widoczną treścią
- Article i BlogPosting
- Product
- LocalBusiness
- BreadcrumbList
- Krok 5: Waliduj wyrenderowaną stronę, nie szablon
- Krok 6: Sprawdź szczegóły transportu w produkcji
- Krok 7: Dodaj testy danych strukturalnych do procesu wydawniczego
- Lista kontrolna walidacji zaczynającej od standardów
Walidacja danych strukturalnych stała się zaskakująco zależna od narzędzi nastawionych na Google. To zrozumiałe: wiele zespołów dodaje JSON-LD, ponieważ chce uzyskać wyniki z elementami rozszerzonymi, a narzędzia testowe Google są dobrze znane. Ale dane strukturalne nie są formatem Google. Zwykle są to dane JSON-LD używające słownika Schema.org, osadzone w HTML-u, interpretowane przez wielu odbiorców i utrzymywane przez Twój własny proces publikacyjny.
Jeśli walidujesz wyłącznie przez pryzmat wyszukiwarki, możesz przeoczyć podstawowe problemy: nieprawidłowy JSON, dane znikające po renderowaniu, nieaktualne ceny produktów, sprzeczne kanoniczne adresy URL albo znaczniki, które są technicznie poprawne, ale semantycznie nierozsądne.
Lepszy proces zaczyna się od standardów. Najpierw waliduj dane jako dane, potem słownik, a następnie stronę taką, jaka istnieje w produkcji.
Co właściwie walidujesz?
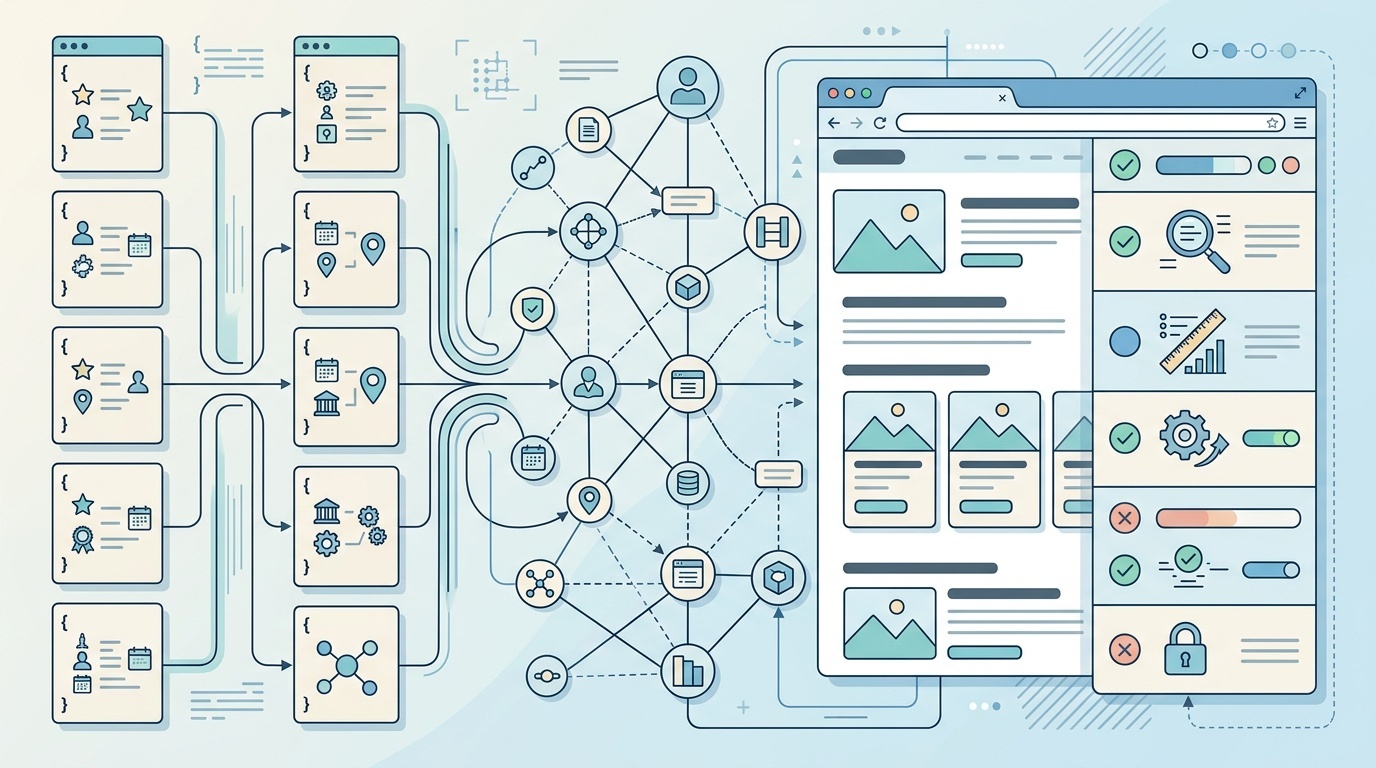
„Dane strukturalne” nie są jedną rzeczą. Na większości stron internetowych mają cztery warstwy:
- Składnia JSON — czy kod da się sparsować?
- Model JSON-LD — czy rozwija się do sensownych danych połączonych?
- Słownik Schema.org — czy typy i właściwości są wiarygodne?
- Prawda na poziomie strony — czy znaczniki odpowiadają temu, co widzą użytkownicy i crawlery?
Narzędzia Google koncentrują się głównie na czwartej warstwie oraz na kwalifikowalności do specyficznych dla Google wyników z elementami rozszerzonymi. Przydatne, owszem. Kompletne, nie.
Na przykład to może być poprawny JSON-LD, a jednocześnie słabe dane strukturalne:
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "Best winter jackets",
  "datePublished": "2026-01-12",
  "author": {
    "@type": "Organization",
    "name": "Editorial Team"
  }
}
Nic nie jest tu zepsute. Ale jeśli widoczna strona ma inny nagłówek, brak przypisania autora i datę ostatniej modyfikacji, która przeczy znacznikom, masz problem jakościowy, a nie problem składni.
Krok 1: Parsuj JSON, zanim pomyślisz o SEO
Zacznij od nudnego sprawdzenia: czy JSON da się sparsować?
JSON-LD osadzony w HTML-u często psuje się przez drobne błędy w szablonach:
- końcowe przecinki
- nieescapowane cudzysłowy w nazwach produktów
- nieprawidłowe łamania wierszy wewnątrz ciągów znaków
- brakujące nawiasy klamrowe po polach warunkowych
- zduplikowane bloki script wynikające z dziedziczenia layoutu
- wtyczki CMS generujące częściowe obiekty
Do lokalnych sprawdzeń nie potrzebujesz platformy SEO. Użyj narzędzi, które już masz w swoim stosie deweloperskim.
W JavaScript:
const blocks = [...document.querySelectorAll('script[type="application/ld+json"]')];

for (const block of blocks) {
  try {
    JSON.parse(block.textContent);
  } catch (error) {
    console.error('Invalid JSON-LD:', error.message, block);
  }
}
W CI wyodrębnij zawartość skryptów z wyrenderowanego HTML-a i parsuj ją jako JSON. To pozwala wychwycić wiele problemów, zanim trafią na produkcję.
Najważniejsze: zrób to przed jakąkolwiek walidacją Schema.org. Walidator słownika nie pomoże, jeśli dane nie są poprawnym JSON-em.
Krok 2: Sprawdź zachowanie JSON-LD, nie tylko składnię JSON
Poprawny JSON nie jest automatycznie poprawnym JSON-LD. JSON-LD używa takich pojęć jak @context, @type, @id i relacje w grafie. Jeśli są zniekształcone, parsery mogą zinterpretować Twoje dane inaczej, niż zamierzasz.
Co najmniej potwierdź, że:
- każdy blok ma odpowiedni
@context - główne encje mają jasne wartości
@type - powtarzające się encje używają stabilnych wartości
@idtam, gdzie to przydatne - encje zagnieżdżone są logicznie połączone
- tablice są używane wtedy, gdy możliwych jest wiele wartości
W większych serwisach stabilne identyfikatory są szczególnie pomocne. Jeśli Twoja organizacja pojawia się w danych Article, Product, BreadcrumbList i FAQPage, używanie tego samego @id pomaga odbiorcom zrozumieć, że są to odwołania do tej samej encji, a nie cztery niepowiązane organizacje o tej samej nazwie.
Typowy wzorzec wygląda tak:
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "@id": "https://example.com/#organization",
  "name": "Example Ltd",
  "url": "https://example.com/"
}
Nie próbujesz tu zaimponować walidatorowi. Sprawiasz, że Twoje dane są mniej niejednoznaczne.
Krok 3: Waliduj względem słownika Schema.org
Gdy JSON i struktura JSON-LD są poprawne, sprawdź słownik.
Walidator Schema.org jest przydatny, ponieważ testuje względem terminów Schema.org, a nie względem reguł wyników z elementami rozszerzonymi jednej wyszukiwarki. Może pokazać, czy właściwości są rozpoznawane, czy typy są interpretowane zgodnie z oczekiwaniami i czy zagnieżdżone struktury mają sens.
To tutaj wychwytujesz błędy takie jak:
publishingDatezamiastdatePublishedimageUrltam, gdzie oczekiwane jestimage- znaczniki
Productna liście kategorii, która nie jest produktem AggregateRatingbez sensownego ocenianego elementuPersonużyte dla konta marki
Ostrożnie podchodź do ostrzeżeń. Schema.org jest celowo elastyczny. Walidator może dopuścić właściwość, która nie jest przydatna w Twoim przypadku użycia, albo ostrzec przed czymś opcjonalnym. Traktuj walidację jako przesłankę, nie wyrok.
Praktyczna zasada: jeśli właściwość pomaga maszynie dokładniej zrozumieć stronę, zostaw ją. Jeśli istnieje tylko dlatego, że ktoś skopiował ją z generatora snippetów, zakwestionuj ją.
Krok 4: Porównaj znaczniki z widoczną treścią
Wyszukiwarki i inni odbiorcy danych zwykle nie ufają znacznikom, które nie zgadzają się ze stroną. Co ważniejsze, użytkownicy zasługują na spójność.
Dla każdego typu danych strukturalnych porównaj znaczniki z widoczną stroną:
Article i BlogPosting
Sprawdź, czy nagłówek, autor, data publikacji, data modyfikacji, obraz i wydawca są widoczne albo dają się rozsądnie wywnioskować. Jeśli publikujesz treści wspomagane przez AI, Twoje dane strukturalne nie powinny służyć do wybielania niejasnego autorstwa. Pisaliśmy osobno o uczciwym ujawnianiu użycia AI na małej stronie internetowej, a ta sama zasada obowiązuje tutaj: metadane powinny wyjaśniać, nie zaciemniać.
Product
Sprawdź nazwę, cenę, dostępność, walutę, warianty, oceny i liczbę recenzji. Dane strukturalne produktów są szczególnie podatne na dezaktualizację, ponieważ ceny i stan magazynowy zmieniają się poza CMS-em.
LocalBusiness
Sprawdź nazwę, adres, numer telefonu, godziny otwarcia i obszar świadczenia usług. Jeśli stopka mówi jedno, a JSON-LD drugie, JSON-LD nie jest „lepszy”. Jest sprzeczny.
BreadcrumbList
Sprawdź, czy pozycje okruszków odpowiadają widocznej ścieżce nawigacyjnej oraz czy adresy URL są kanoniczne, możliwe do crawlowania i nie są niepotrzebnie przekierowywane.
To nie jest efektowna praca. To także miejsce, w którym znajduje się wiele problemów z danymi strukturalnymi.
Krok 5: Waliduj wyrenderowaną stronę, nie szablon
Wiele witryn generuje JSON-LD przez JavaScript, menedżery tagów, warstwy personalizacji albo hydrację komponentów. Oznacza to, że plik szablonu może nie odzwierciedlać tego, co crawler lub przeglądarka faktycznie widzi.
Waliduj wyrenderowany HTML co najmniej w trzech stanach:
- lokalny build deweloperski
- adres URL stagingu lub podglądu
- produkcyjny adres URL
Użyj DevTools w przeglądarce, aby obejrzeć końcowy DOM. Wyszukaj application/ld+json i skopiuj dokładną zawartość skryptu istniejącą po renderowaniu. Jeśli znaczniki renderowane po stronie serwera różnią się od znaczników po hydracji, zdecyduj, którą wersję mają czytać odbiorcy.
Sprawdź też, czy dane strukturalne nie są duplikowane. Zduplikowane bloki Article lub Product są częste, gdy zarówno wtyczka CMS, jak i niestandardowy komponent emitują schema. Duplikacja nie zawsze jest krytyczna, ale sprzeczna duplikacja jest problemem: dwie ceny, dwóch autorów, dwie daty publikacji albo dwa kanoniczne adresy URL.
To podobne do czytania raportów wydajności i diagnostyki: pierwszym zadaniem nie jest panika, lecz oddzielenie sygnału od szumu. Ten sam nawyk pomaga, gdy czytasz raport Lighthouse bez paniki — choć samych danych strukturalnych nie należy sprowadzać do jednego wyniku.
Krok 6: Sprawdź szczegóły transportu w produkcji
Dane strukturalne mogą być idealne w źródle, a mimo to zawieść w produkcji, ponieważ strona nie jest dostępna w sposób, który zakładasz.
Sprawdź:
- końcowy kod statusu to
200, a nie miękkie 404 - kanoniczny adres URL odpowiada stronie, którą walidujesz
- przekierowania są celowe i stabilne
- dyrektywy robots nie blokują indeksowania tam, gdzie jest ono oczekiwane
- HTML nie jest zastępowany stroną błędu dla niektórych user agentów
- strony z cache nie serwują nieaktualnego JSON-LD
Tu znaczenie ma inspekcja HTTP. Jeśli strona produktu przechodzi przez trzy adresy URL, zanim dotrze do kanonicznego miejsca docelowego, waliduj stronę końcową, a nie pierwszy adres URL skopiowany z CMS-a. W kwestii surowej mechaniki przydatnym uzupełnieniem jest nasz przewodnik po debugowaniu przekierowań i nagłówków HTTP w produkcji.
Dane strukturalne nie istnieją w próżni. Podróżują razem z nagłówkami, przekierowaniami, cache, tagami kanonicznymi i dyrektywami robots.
Krok 7: Dodaj testy danych strukturalnych do procesu wydawniczego
Ręczna walidacja jest dobra dla jednej strony. Nie skaluje się do setek ani tysięcy adresów URL.
Prosty zautomatyzowany zestaw testów może wychwycić najkosztowniejsze błędy:
- pobieraj reprezentatywne adresy URL z każdego typu szablonu
- wyodrębniaj wszystkie bloki JSON-LD
- parsuj je za pomocą
JSON.parse - asercjami sprawdzaj wymagane pola dla każdego typu strony
- sprawdzaj, czy daty są poprawnymi ciągami ISO 8601
- sprawdzaj, czy adresy URL są bezwzględne i kanoniczne
- sprawdzaj, czy ceny i dostępność istnieją dla stron produktów
- sprawdzaj, czy zduplikowane encje nie są sprzeczne
Możesz uruchamiać to w CI dla szablonów oraz według harmonogramu dla produkcyjnych adresów URL. Celem nie jest udowodnienie, że każda funkcja wyników z elementami rozszerzonymi się pojawi. Nikt poza wyszukiwarką nie może tego obiecać. Celem jest utrzymanie własnych danych jako dokładnych, parsowalnych i spójnych.
<!-- tool-cta:start -->
💡 Wypróbuj to: Przed walidacją logiki schematu przepuść swój JSON-LD przez JSON Formatter, aby wychwycić błędy składniowe, które w przeciwnym razie zepsułyby każdą kolejną kontrolę.
<!-- tool-cta:end -->
Lista kontrolna walidacji zaczynającej od standardów
Użyj tej krótkiej listy, zanim zapytasz, czy wyszukiwarka lubi stronę:
- Czy każdy blok JSON-LD jest poprawnym JSON-em?
- Czy każdy blok zawiera właściwe
@contexti@type? - Czy właściwości Schema.org są zapisane poprawnie?
- Czy znaczniki odpowiadają widocznej treści?
- Czy daty, ceny, oceny i dostępność są aktualne?
- Czy adresy URL są bezwzględne, kanoniczne i osiągalne?
- Czy wyrenderowana strona produkcyjna jest tą samą stroną, którą testowano?
- Czy zduplikowane encje są zamierzone i niesprzeczne?
Jeśli możesz odpowiedzieć twierdząco na te pytania, masz za sobą trwałą część pracy z danymi strukturalnymi. Testy specyficzne dla wyszukiwarki mogą być nadal przydatne później, ale powinny być końcowym sprawdzeniem zgodności, a nie fundamentem procesu walidacji.
Najczęściej zadawane pytania
Czy mogę walidować dane strukturalne bez używania Google?
Czy poprawne znaczniki Schema.org wystarczą, aby uzyskać wyniki z elementami rozszerzonymi?
Czy dane strukturalne zawsze powinny być renderowane po stronie serwera?
Jak często należy sprawdzać produkcyjne dane strukturalne?
Jaki jest najczęstszy błąd w danych strukturalnych?
Źródła i dalsza lektura