Como validar dados estruturados sem ferramentas do Google
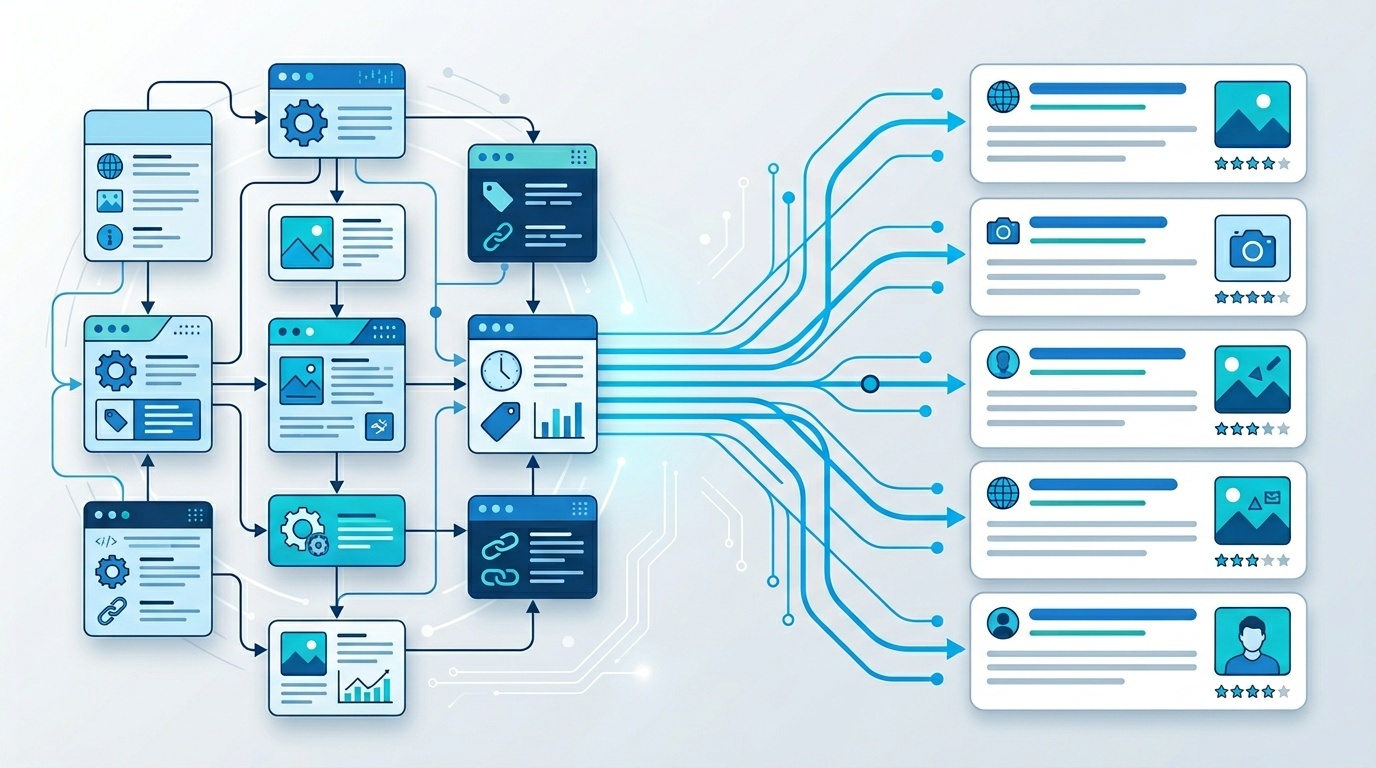
Um fluxo de trabalho prático para verificar JSON-LD, vocabulário Schema.org, HTML renderizado e comportamento em produção sem tratar o Google como a única fonte da verdade.
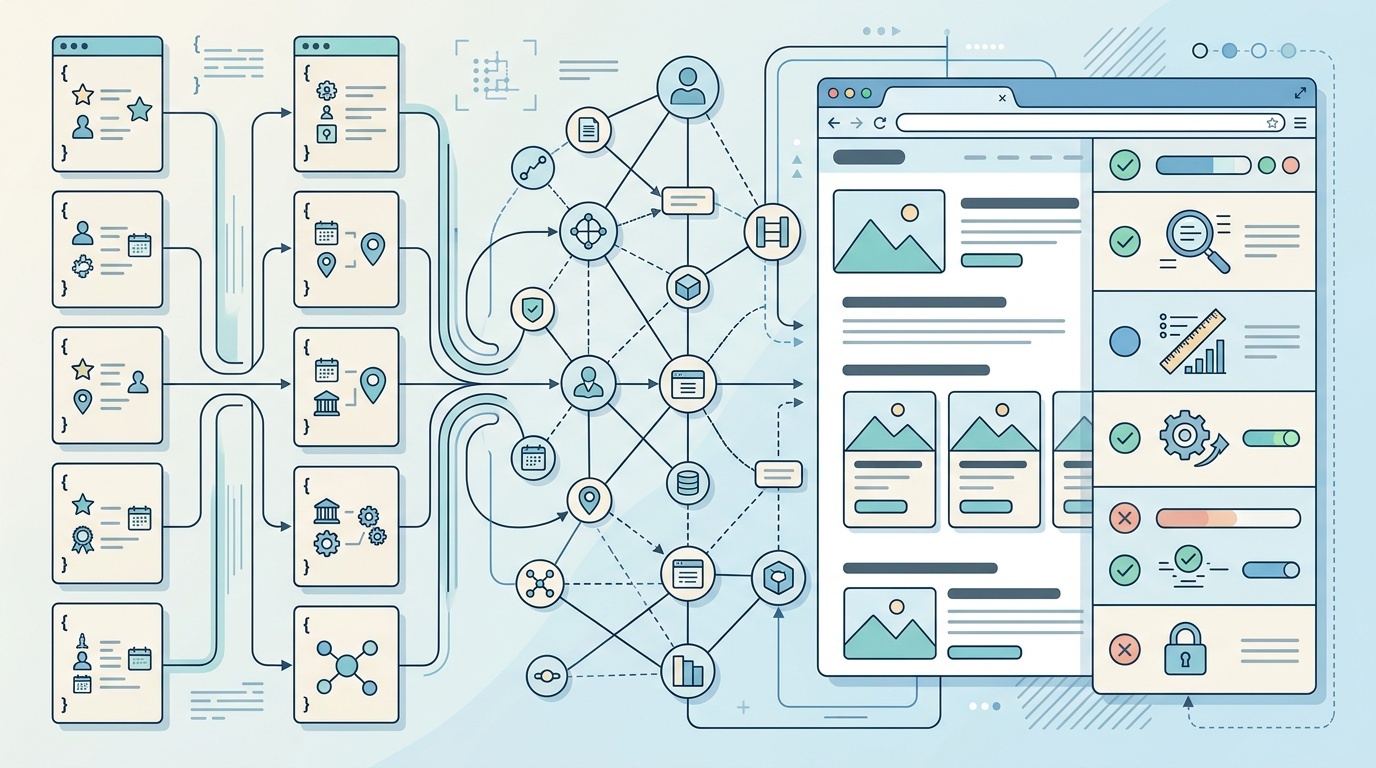
Tabela de conteúdos
- O que você está realmente validando?
- Etapa 1: Analise o JSON antes de pensar em SEO
- Etapa 2: Verifique o comportamento do JSON-LD, não apenas a sintaxe JSON
- Etapa 3: Valide contra o vocabulário Schema.org
- Etapa 4: Compare a marcação com o conteúdo visível
- Article and BlogPosting
- Product
- LocalBusiness
- BreadcrumbList
- Etapa 5: Valide a página renderizada, não seu template
- Etapa 6: Verifique detalhes de transporte em produção
- Etapa 7: Adicione testes de dados estruturados ao seu processo de release
- Uma checklist de validação orientada por padrões
A validação de dados estruturados tornou-se estranhamente dependente de ferramentas voltadas ao Google. Isso é compreensível: muitas equipes adicionam JSON-LD porque querem rich results, e as ferramentas de teste do Google são familiares. Mas dados estruturados não são um formato do Google. Em geral, são JSON-LD usando o vocabulário Schema.org, incorporados em HTML, interpretados por muitos consumidores e mantidos pelo seu próprio fluxo de publicação.
Se você valida apenas pela lente de um mecanismo de busca, pode deixar passar problemas básicos: JSON inválido, dados que desaparecem após a renderização, preços de produtos desatualizados, URLs canônicas conflitantes ou marcação tecnicamente válida, mas semanticamente sem sentido.
Um fluxo melhor começa pelos padrões. Valide os dados como dados, depois valide o vocabulário e, em seguida, valide a página como ela existe em produção.
O que você está realmente validando?
“Dados estruturados” não são uma coisa só. Na maioria dos sites, eles têm quatro camadas:
- Sintaxe JSON — o código pode ser analisado?
- Modelo JSON-LD — ele se expande em dados vinculados significativos?
- Vocabulário Schema.org — os tipos e propriedades são plausíveis?
- Verdade no nível da página — a marcação corresponde ao que usuários e rastreadores conseguem ver?
As ferramentas do Google se concentram principalmente na quarta camada, além da elegibilidade específica do Google para rich results. Útil, sim. Completo, não.
Por exemplo, isto pode ser JSON-LD válido e ainda assim ser dados estruturados ruins:
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "Best winter jackets",
  "datePublished": "2026-01-12",
  "author": {
    "@type": "Organization",
    "name": "Editorial Team"
  }
}
Não há nada quebrado aqui. Mas, se a página visível tem um título diferente, nenhuma atribuição de autoria e uma data de última modificação que contradiz a marcação, você tem um problema de qualidade, não um problema de sintaxe.
Etapa 1: Analise o JSON antes de pensar em SEO
Comece pela verificação sem glamour: o JSON pode ser analisado?
JSON-LD incorporado em HTML muitas vezes quebra por pequenos erros de template:
- vírgulas finais
- aspas não escapadas em nomes de produtos
- quebras de linha inválidas dentro de strings
- chaves ausentes após campos condicionais
- blocos de script duplicados por herança de layout
- plugins de CMS emitindo objetos parciais
Para verificações locais, você não precisa de uma plataforma de SEO. Use as ferramentas que já existem na sua stack de desenvolvimento.
Em JavaScript:
const blocks = [...document.querySelectorAll('script[type="application/ld+json"]')];

for (const block of blocks) {
  try {
    JSON.parse(block.textContent);
  } catch (error) {
    console.error('Invalid JSON-LD:', error.message, block);
  }
}
Em CI, extraia o conteúdo dos scripts do HTML renderizado e analise-os como JSON. Isso captura muitos problemas antes que cheguem à produção.
O ponto importante: faça isso antes de qualquer validação Schema.org. Um validador de vocabulário não consegue ajudar se os dados não forem JSON válido.
Etapa 2: Verifique o comportamento do JSON-LD, não apenas a sintaxe JSON
JSON válido não é automaticamente JSON-LD válido. JSON-LD usa conceitos como @context, @type, @id e relações de grafo. Se eles estiverem malformados, parsers podem interpretar seus dados de forma diferente da pretendida.
No mínimo, confirme:
- todo bloco tem um
@contextapropriado - entidades primárias têm valores
@typeclaros - entidades repetidas usam valores
@idestáveis quando útil - entidades aninhadas estão conectadas de forma lógica
- arrays são usados quando vários valores são possíveis
Para sites maiores, identificadores estáveis são especialmente úteis. Se sua organização aparece em dados de Article, Product, BreadcrumbList e FAQPage, usar o mesmo @id ajuda consumidores a entender que são referências à mesma entidade, não quatro organizações sem relação entre si com o mesmo nome.
Um padrão típico é assim:
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "@id": "https://example.com/#organization",
  "name": "Example Ltd",
  "url": "https://example.com/"
}
Você não está tentando impressionar um validador aqui. Você está tornando seus dados menos ambíguos.
Etapa 3: Valide contra o vocabulário Schema.org
Depois que o JSON e a estrutura JSON-LD estiverem sólidos, verifique o vocabulário.
O validador Schema.org é útil porque testa contra termos Schema.org, e não contra as regras de rich results de um único mecanismo de busca. Ele pode mostrar se as propriedades são reconhecidas, se os tipos estão sendo interpretados como esperado e se suas estruturas aninhadas fazem sentido.
É aqui que você captura erros como:
publishingDateem vez dedatePublishedimageUrlondeimageé esperado- marcação
Productem uma listagem de categoria que não é um produto AggregateRatingsem um item avaliado significativoPersonusado para uma conta de marca
Tenha cuidado com avisos. Schema.org é intencionalmente flexível. Um validador pode permitir uma propriedade que não é útil para seu caso de uso ou avisar sobre algo que é opcional. Trate a validação como evidência, não como veredito.
Uma regra prática: se uma propriedade ajuda uma máquina a entender a página com mais precisão, mantenha-a. Se ela existe apenas porque alguém a copiou de um gerador de snippets, questione-a.
Etapa 4: Compare a marcação com o conteúdo visível
Mecanismos de busca e outros consumidores de dados tendem a desconfiar de marcação que não corresponde à página. Mais importante: usuários merecem consistência.
Para cada tipo de dado estruturado, compare a marcação com a página visível:
Article and BlogPosting
Verifique se o título, autor, data de publicação, data de modificação, imagem e publisher são visíveis ou razoavelmente inferíveis. Se você publica conteúdo assistido por IA, seus dados estruturados não devem ser usados para lavar uma autoria pouco clara. Escrevemos separadamente sobre divulgação honesta de IA em um site pequeno, e o mesmo princípio se aplica aqui: metadados devem esclarecer, não obscurecer.
Product
Verifique nome, preço, disponibilidade, moeda, variantes, avaliações e contagens de reviews. Dados estruturados de produto são particularmente propensos a ficar desatualizados porque preços e status de estoque mudam fora do CMS.
LocalBusiness
Verifique nome, endereço, número de telefone, horário de funcionamento e área de atendimento. Se o rodapé diz uma coisa e seu JSON-LD diz outra, o JSON-LD não é “melhor”. Ele é contraditório.
BreadcrumbList
Verifique se as posições do breadcrumb correspondem à trilha de navegação visível e se as URLs são canônicas, rastreáveis e não redirecionadas desnecessariamente.
Este não é um trabalho glamouroso. Também é onde muitos problemas de dados estruturados são encontrados.
Etapa 5: Valide a página renderizada, não seu template
Muitos sites geram JSON-LD por meio de JavaScript, tag managers, camadas de personalização ou hidratação de componentes. Isso significa que o arquivo de template pode não representar o que um rastreador ou navegador realmente vê.
Valide o HTML renderizado em pelo menos três estados:
- build de desenvolvimento local
- URL de staging ou preview
- URL de produção
Use o DevTools do navegador para inspecionar o DOM final. Procure por application/ld+json e copie o conteúdo exato do script que existe após a renderização. Se a marcação renderizada no servidor difere da marcação hidratada, decida qual versão você espera que os consumidores leiam.
Verifique também se os dados estruturados estão sendo duplicados. Blocos Article ou Product duplicados são comuns quando um plugin de CMS e um componente personalizado emitem schema ao mesmo tempo. Duplicação nem sempre é fatal, mas duplicação conflitante é um problema: dois preços, dois autores, duas datas de publicação ou duas URLs canônicas.
Isso é semelhante a ler relatórios de performance e diagnóstico: a primeira tarefa não é entrar em pânico, mas separar sinal de ruído. O mesmo hábito ajuda quando você lê um relatório Lighthouse sem entrar em pânico — embora dados estruturados em si não devam ser reduzidos a uma única pontuação.
Etapa 6: Verifique detalhes de transporte em produção
Dados estruturados podem estar perfeitos no seu código-fonte e ainda falhar em produção porque a página não está acessível da forma que você presume.
Verifique:
- o código de status final é
200, não um soft 404 - a URL canônica corresponde à página que você está validando
- redirecionamentos são intencionais e estáveis
- diretivas robots não bloqueiam indexação onde se espera indexação
- o HTML não é substituído por uma página de erro para alguns user agents
- páginas em cache não estão servindo JSON-LD desatualizado
É aqui que a inspeção HTTP importa. Se uma página de produto redireciona por três URLs antes de chegar a um destino canônico, valide a página final, não a primeira URL copiada do CMS. Para a mecânica bruta, nosso guia para depurar redirecionamentos e cabeçalhos HTTP em produção é um complemento útil.
Dados estruturados não vivem no vácuo. Eles viajam com cabeçalhos, redirecionamentos, cache, tags canônicas e diretivas robots.
Etapa 7: Adicione testes de dados estruturados ao seu processo de release
Validação manual funciona bem para uma página. Ela não escala para centenas ou milhares de URLs.
Uma suíte simples de testes automatizados pode capturar os erros mais caros:
- buscar URLs representativas de cada tipo de template
- extrair todos os blocos JSON-LD
- analisá-los com
JSON.parse - afirmar campos obrigatórios para cada tipo de página
- verificar se as datas são strings ISO 8601 válidas
- verificar se as URLs são absolutas e canônicas
- verificar se preços e disponibilidade existem para páginas de produto
- verificar se entidades duplicadas não entram em conflito
Você pode executar isso em CI para templates e em uma agenda para URLs de produção. O objetivo não é provar que todo recurso de rich results aparecerá. Ninguém fora do mecanismo de busca pode prometer isso. O objetivo é manter seus próprios dados precisos, analisáveis e consistentes.
<!-- tool-cta:start -->
💡 Experimente isto: Antes de validar a lógica do esquema, passe seu JSON-LD pelo JSON Formatter para detectar erros de sintaxe que, de outra forma, quebrariam todas as verificações posteriores.
<!-- tool-cta:end -->
Uma checklist de validação orientada por padrões
Use esta checklist curta antes de perguntar se um mecanismo de busca gosta da página:
- Todo bloco JSON-LD é JSON válido?
- Cada bloco inclui o
@contexte o@typecorretos? - As propriedades Schema.org estão escritas corretamente?
- A marcação corresponde ao conteúdo visível?
- Datas, preços, avaliações e disponibilidade estão atuais?
- As URLs são absolutas, canônicas e acessíveis?
- A página de produção renderizada é a mesma página que você testou?
- Entidades duplicadas são intencionais e não conflitantes?
Se você consegue responder sim a essas perguntas, fez a parte durável do trabalho com dados estruturados. Testes específicos de busca ainda podem ser úteis depois, mas devem ser a verificação final de compatibilidade, não a base do seu processo de validação.
Perguntas frequentes
Posso validar dados estruturados sem usar o Google?
Marcação Schema.org válida é suficiente para obter rich results?
Dados estruturados devem sempre ser renderizados no servidor?
Com que frequência dados estruturados em produção devem ser verificados?
Qual é o erro mais comum em dados estruturados?
Fontes e leituras adicionais