Google 도구 없이 구조화된 데이터를 검증하는 방법
Google을 유일한 진실의 원천으로 여기지 않고 JSON-LD, Schema.org 어휘, 렌더링된 HTML, 프로덕션 동작을 점검하는 실용적인 워크플로.
목차
- 실제로 무엇을 검증하는가?
- Step 1: SEO를 생각하기 전에 JSON을 파싱하라
- Step 2: JSON 구문뿐 아니라 JSON-LD 동작을 확인하라
- Step 3: Schema.org 어휘에 맞춰 검증하라
- Step 4: 마크업을 보이는 콘텐츠와 비교하라
- Article 및 BlogPosting
- Product
- LocalBusiness
- BreadcrumbList
- Step 5: 템플릿이 아니라 렌더링된 페이지를 검증하라
- Step 6: 프로덕션 전송 세부사항을 확인하라
- Step 7: 릴리스 프로세스에 구조화된 데이터 테스트를 추가하라
- 표준 우선 검증 체크리스트
구조화된 데이터 검증은 이상할 만큼 Google 지향 도구에 의존하게 되었다. 이해할 만한 일이다. 많은 팀이 리치 결과를 원해서 JSON-LD를 추가하고, Google의 테스트 도구는 익숙하기 때문이다. 하지만 구조화된 데이터는 Google 형식이 아니다. 보통 HTML에 삽입된 Schema.org 어휘를 사용하는 JSON-LD이며, 여러 소비자가 해석하고, 자체 게시 워크플로가 유지 관리한다.
검색 엔진 관점으로만 검증하면 기본적인 문제를 놓칠 수 있다. 잘못된 JSON, 렌더링 후 사라지는 데이터, 오래된 제품 가격, 충돌하는 canonical URL, 기술적으로는 유효하지만 의미적으로는 어색한 마크업 같은 문제들이다.
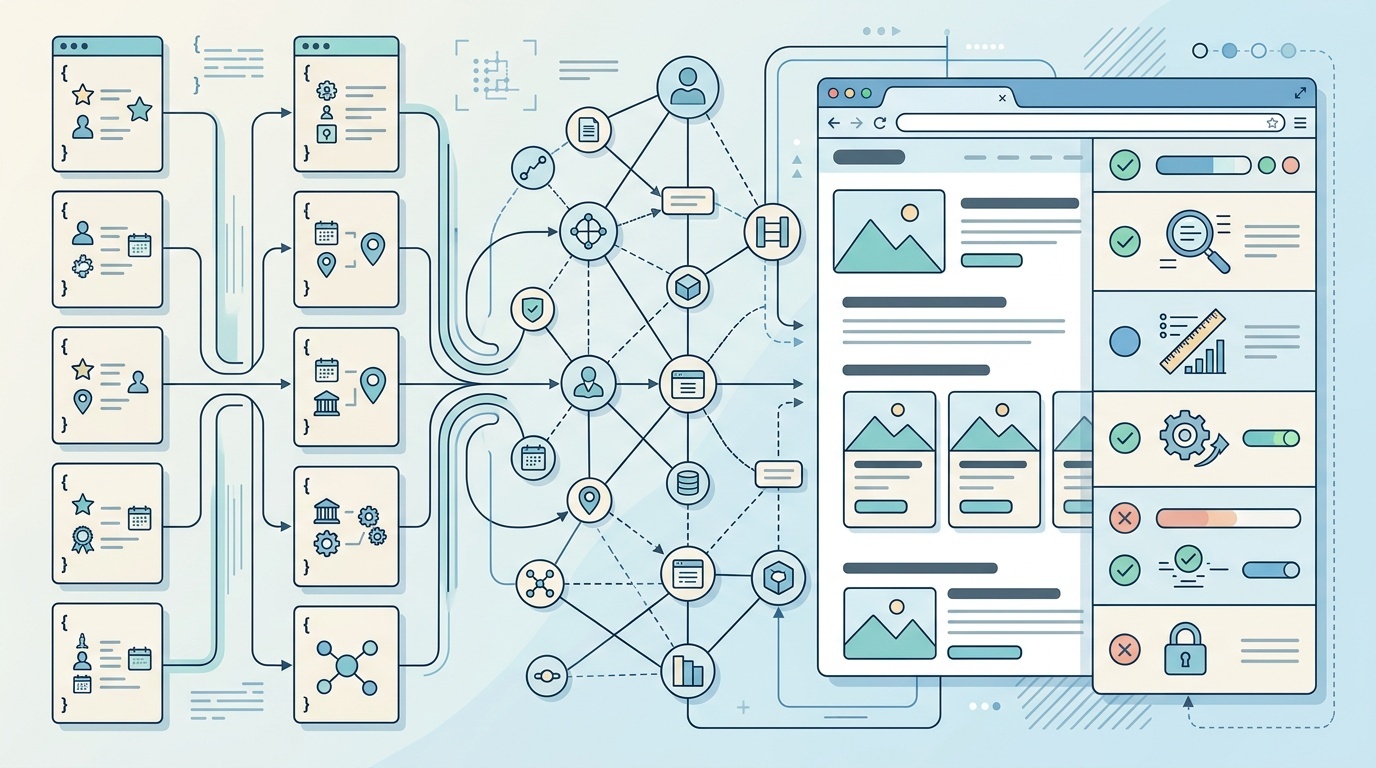
더 나은 워크플로는 표준 우선이다. 먼저 데이터를 데이터로서 검증하고, 그다음 어휘를 검증한 뒤, 프로덕션에 존재하는 페이지 자체를 검증한다.
실제로 무엇을 검증하는가?
“구조화된 데이터”는 하나의 단일한 것이 아니다. 대부분의 웹사이트에서는 네 개의 층으로 구성된다.
- JSON 구문 — 코드를 파싱할 수 있는가?
- JSON-LD 모델 — 의미 있는 연결 데이터로 확장되는가?
- Schema.org 어휘 — 타입과 속성이 타당한가?
- 페이지 수준의 사실성 — 마크업이 사용자와 크롤러가 볼 수 있는 내용과 일치하는가?
Google 도구는 주로 네 번째 층과 Google 고유의 리치 결과 자격에 초점을 맞춘다. 유용하기는 하다. 그러나 완전하지는 않다.
예를 들어, 다음은 유효한 JSON-LD일 수 있지만 여전히 좋지 않은 구조화된 데이터일 수 있다.
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "Best winter jackets",
  "datePublished": "2026-01-12",
  "author": {
    "@type": "Organization",
    "name": "Editorial Team"
  }
}
여기에는 깨진 부분이 없다. 하지만 보이는 페이지의 헤드라인이 다르고, 저자 표기가 없으며, 최종 수정일이 마크업과 모순된다면 이는 구문 문제가 아니라 품질 문제다.
Step 1: SEO를 생각하기 전에 JSON을 파싱하라
지루한 점검부터 시작하라. JSON을 파싱할 수 있는가?
HTML에 삽입된 JSON-LD는 작은 템플릿 실수 때문에 자주 깨진다.
- trailing comma
- 제품명 안의 이스케이프되지 않은 따옴표
- 문자열 내부의 잘못된 줄바꿈
- 조건부 필드 뒤에 누락된 중괄호
- 레이아웃 상속으로 인한 중복 script 블록
- CMS 플러그인이 출력하는 불완전한 객체
로컬 점검에는 SEO 플랫폼이 필요하지 않다. 개발 스택에 이미 있는 도구를 사용하면 된다.
JavaScript에서는 다음과 같다.
const blocks = [...document.querySelectorAll('script[type="application/ld+json"]')];

for (const block of blocks) {
  try {
    JSON.parse(block.textContent);
  } catch (error) {
    console.error('Invalid JSON-LD:', error.message, block);
  }
}
CI에서는 렌더링된 HTML에서 script 내용을 추출해 JSON으로 파싱하라. 이렇게 하면 많은 문제가 프로덕션에 도달하기 전에 잡힌다.
중요한 점은 이것을 Schema.org 검증보다 먼저 해야 한다는 것이다. 데이터가 유효한 JSON이 아니라면 어휘 검증기는 도움을 줄 수 없다.
Step 2: JSON 구문뿐 아니라 JSON-LD 동작을 확인하라
유효한 JSON이 자동으로 유효한 JSON-LD가 되는 것은 아니다. JSON-LD는 @context, @type, @id, 그래프 관계 같은 개념을 사용한다. 이것들이 잘못 구성되면 파서가 의도와 다르게 데이터를 해석할 수 있다.
최소한 다음을 확인하라.
- 모든 블록에 적절한
@context가 있는지 - 주요 엔티티에 명확한
@type값이 있는지 - 반복되는 엔티티가 유용한 경우 안정적인
@id값을 사용하는지 - 중첩된 엔티티가 논리적으로 연결되어 있는지
- 여러 값이 가능할 때 배열을 사용하는지
규모가 큰 사이트에서는 안정적인 식별자가 특히 유용하다. 조직이 Article, Product, BreadcrumbList, FAQPage 데이터에 등장한다면 같은 @id를 사용하는 것이 소비자가 이들을 같은 엔티티에 대한 참조로 이해하는 데 도움이 된다. 같은 이름을 가진 서로 무관한 네 개의 조직으로 보이지 않게 해준다.
일반적인 패턴은 다음과 같다.
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "@id": "https://example.com/#organization",
  "name": "Example Ltd",
  "url": "https://example.com/"
}
여기서 검증기를 감탄시키려는 것이 아니다. 데이터를 덜 모호하게 만드는 것이다.
Step 3: Schema.org 어휘에 맞춰 검증하라
JSON과 JSON-LD 구조가 탄탄해졌다면 어휘를 점검하라.
Schema.org validator는 하나의 검색 엔진 리치 결과 규칙이 아니라 Schema.org 용어를 기준으로 테스트하기 때문에 유용하다. 속성이 인식되는지, 타입이 예상대로 해석되는지, 중첩 구조가 타당한지 보여줄 수 있다.
이 단계에서 다음과 같은 실수를 잡을 수 있다.
datePublished대신publishingDate를 사용한 경우image가 예상되는 곳에imageUrl을 사용한 경우- 제품이 아닌 카테고리 목록에
Product마크업을 넣은 경우 - 의미 있는 리뷰 대상 없이
AggregateRating을 사용한 경우 - 브랜드 계정에
Person을 사용한 경우
경고는 신중하게 다뤄야 한다. Schema.org는 의도적으로 유연하다. 검증기가 사용 사례에 별 도움이 되지 않는 속성을 허용할 수도 있고, 선택 사항에 대해 경고할 수도 있다. 검증은 판결이 아니라 증거로 다뤄라.
실용적인 규칙은 이렇다. 어떤 속성이 기계가 페이지를 더 정확히 이해하는 데 도움이 된다면 유지하라. 단지 누군가가 스니펫 생성기에서 복사해 왔기 때문에 존재한다면 의심하라.
Step 4: 마크업을 보이는 콘텐츠와 비교하라
검색 엔진과 다른 데이터 소비자는 페이지와 일치하지 않는 마크업을 신뢰하지 않는 경향이 있다. 더 중요하게는, 사용자는 일관성을 받을 자격이 있다.
각 구조화된 데이터 타입에 대해 마크업을 보이는 페이지와 비교하라.
Article 및 BlogPosting
헤드라인, 저자, 게시일, 수정일, 이미지, 게시자가 보이거나 합리적으로 추론 가능한지 확인하라. AI 보조 콘텐츠를 게시한다면 구조화된 데이터를 불명확한 저자성을 세탁하는 데 사용해서는 안 된다. 우리는 작은 웹사이트에서 정직한 AI 공개가 어떤 모습이어야 하는지에 대해 별도로 쓴 적이 있으며, 여기에도 같은 원칙이 적용된다. 메타데이터는 흐리게 하는 것이 아니라 명확히 해야 한다.
Product
이름, 가격, 재고 상태, 통화, 변형 상품, 평점, 리뷰 수를 확인하라. 제품 구조화된 데이터는 가격과 재고 상태가 CMS 밖에서 바뀌는 경우가 많기 때문에 특히 오래된 정보가 되기 쉽다.
LocalBusiness
이름, 주소, 전화번호, 영업시간, 서비스 지역을 확인하라. 푸터에는 한 가지가 적혀 있고 JSON-LD에는 다른 내용이 적혀 있다면 JSON-LD가 “더 낫다”는 뜻이 아니다. 서로 모순된다는 뜻이다.
BreadcrumbList
breadcrumb 위치가 보이는 breadcrumb 경로와 일치하는지, URL이 canonical이고 크롤링 가능하며 불필요하게 리디렉션되지 않는지 확인하라.
화려한 작업은 아니다. 하지만 많은 구조화된 데이터 문제가 발견되는 곳이기도 하다.
Step 5: 템플릿이 아니라 렌더링된 페이지를 검증하라
많은 사이트가 JavaScript, tag manager, 개인화 레이어, 컴포넌트 hydration을 통해 JSON-LD를 생성한다. 즉 템플릿 파일은 크롤러나 브라우저가 실제로 보는 것을 대표하지 않을 수 있다.
최소 세 가지 상태에서 렌더링된 HTML을 검증하라.
- 로컬 개발 빌드
- 스테이징 또는 미리보기 URL
- 프로덕션 URL
Browser DevTools를 사용해 최종 DOM을 검사하라. application/ld+json을 검색하고 렌더링 이후 실제로 존재하는 정확한 script 내용을 복사하라. 서버 렌더링 마크업이 hydration 이후 마크업과 다르다면, 소비자가 어느 버전을 읽기를 기대하는지 결정하라.
구조화된 데이터가 중복되고 있는지도 확인하라. CMS 플러그인과 커스텀 컴포넌트가 둘 다 schema를 출력할 때 중복된 Article 또는 Product 블록이 흔히 생긴다. 중복이 항상 치명적인 것은 아니지만, 충돌하는 중복은 문제다. 두 개의 가격, 두 명의 저자, 두 개의 게시일, 두 개의 canonical URL이 있는 경우다.
이는 성능 및 진단 보고서를 읽는 일과 비슷하다. 첫 번째 과제는 당황하는 것이 아니라 신호와 잡음을 분리하는 것이다. Lighthouse 보고서를 당황하지 않고 읽을 때도 같은 습관이 도움이 된다. 다만 구조화된 데이터 자체를 하나의 점수로 축소해서는 안 된다.
Step 6: 프로덕션 전송 세부사항을 확인하라
구조화된 데이터가 소스에서는 완벽해도, 페이지가 예상한 방식으로 접근 가능하지 않으면 프로덕션에서 실패할 수 있다.
다음을 확인하라.
- 최종 상태 코드가 soft 404가 아니라
200인지 - canonical URL이 검증 중인 페이지와 일치하는지
- 리디렉션이 의도적이고 안정적인지
- 인덱싱이 예상되는 곳에서 robots 지시문이 인덱싱을 막지 않는지
- 특정 user agent에 대해 HTML이 오류 페이지로 대체되지 않는지
- 캐시된 페이지가 오래된 JSON-LD를 제공하지 않는지
여기서는 HTTP 검사가 중요하다. 제품 페이지가 canonical 목적지에 도달하기 전에 세 개의 URL을 거쳐 리디렉션된다면, CMS에서 복사한 첫 번째 URL이 아니라 최종 페이지를 검증하라. 원시적인 작동 방식에 대해서는 프로덕션에서 리디렉션과 HTTP 헤더를 디버깅하는 작은 도구 모음 가이드가 유용한 동반 자료다.
구조화된 데이터는 진공 상태에 존재하지 않는다. 헤더, 리디렉션, 캐싱, canonical 태그, robots 지시문과 함께 이동한다.
Step 7: 릴리스 프로세스에 구조화된 데이터 테스트를 추가하라
수동 검증은 한 페이지에는 괜찮다. 하지만 수백 또는 수천 개의 URL로 확장되지는 않는다.
간단한 자동화 테스트 모음만으로도 비용이 큰 실수를 잡을 수 있다.
- 각 템플릿 유형에서 대표 URL을 가져오기
- 모든 JSON-LD 블록 추출하기
JSON.parse로 파싱하기- 각 페이지 유형의 필수 필드 검증하기
- 날짜가 유효한 ISO 8601 문자열인지 확인하기
- URL이 절대 URL이고 canonical인지 확인하기
- 제품 페이지에 가격과 재고 상태가 있는지 확인하기
- 중복 엔티티가 충돌하지 않는지 확인하기
템플릿에 대해서는 CI에서, 프로덕션 URL에 대해서는 일정에 따라 이를 실행할 수 있다. 목표는 모든 리치 결과 기능이 표시될 것임을 증명하는 것이 아니다. 검색 엔진 밖에서는 누구도 그것을 약속할 수 없다. 목표는 자신의 데이터를 정확하고, 파싱 가능하며, 일관되게 유지하는 것이다.
<!-- tool-cta:start -->
💡 이것을 시도해 보세요: 스키마 로직을 검증하기 전에 JSON-LD를 JSON Formatter에 통과시켜, 그렇지 않으면 모든 후속 검사를 망가뜨릴 구문 오류를 찾아내세요.
<!-- tool-cta:end -->
표준 우선 검증 체크리스트
검색 엔진이 페이지를 좋아하는지 묻기 전에 이 짧은 체크리스트를 사용하라.
- 모든 JSON-LD 블록이 유효한 JSON인가?
- 각 블록에 올바른
@context와@type이 포함되어 있는가? - Schema.org 속성의 철자가 정확한가?
- 마크업이 보이는 콘텐츠와 일치하는가?
- 날짜, 가격, 평점, 재고 상태가 최신인가?
- URL이 절대 URL이고 canonical이며 접근 가능한가?
- 렌더링된 프로덕션 페이지가 테스트한 페이지와 같은가?
- 중복 엔티티가 의도적이며 서로 충돌하지 않는가?
이 질문들에 예라고 답할 수 있다면, 구조화된 데이터 작업에서 오래 지속되는 부분은 완료한 것이다. 검색별 테스트는 이후에도 유용할 수 있지만, 검증 프로세스의 기반이 아니라 최종 호환성 점검이어야 한다.
자주 묻는 질문
Google을 전혀 사용하지 않고 구조화된 데이터를 검증할 수 있나요?
유효한 Schema.org 마크업이면 리치 결과를 얻기에 충분한가요?
구조화된 데이터는 항상 서버 렌더링해야 하나요?
프로덕션 구조화된 데이터는 얼마나 자주 확인해야 하나요?
가장 흔한 구조화된 데이터 실수는 무엇인가요?
출처 및 추가 읽기