Så validerar du strukturerade data utan Googles verktyg
Ett praktiskt arbetsflöde för att kontrollera JSON-LD, Schema.org-vokabulär, renderad HTML och produktionsbeteende utan att behandla Google som den enda sanningskällan.
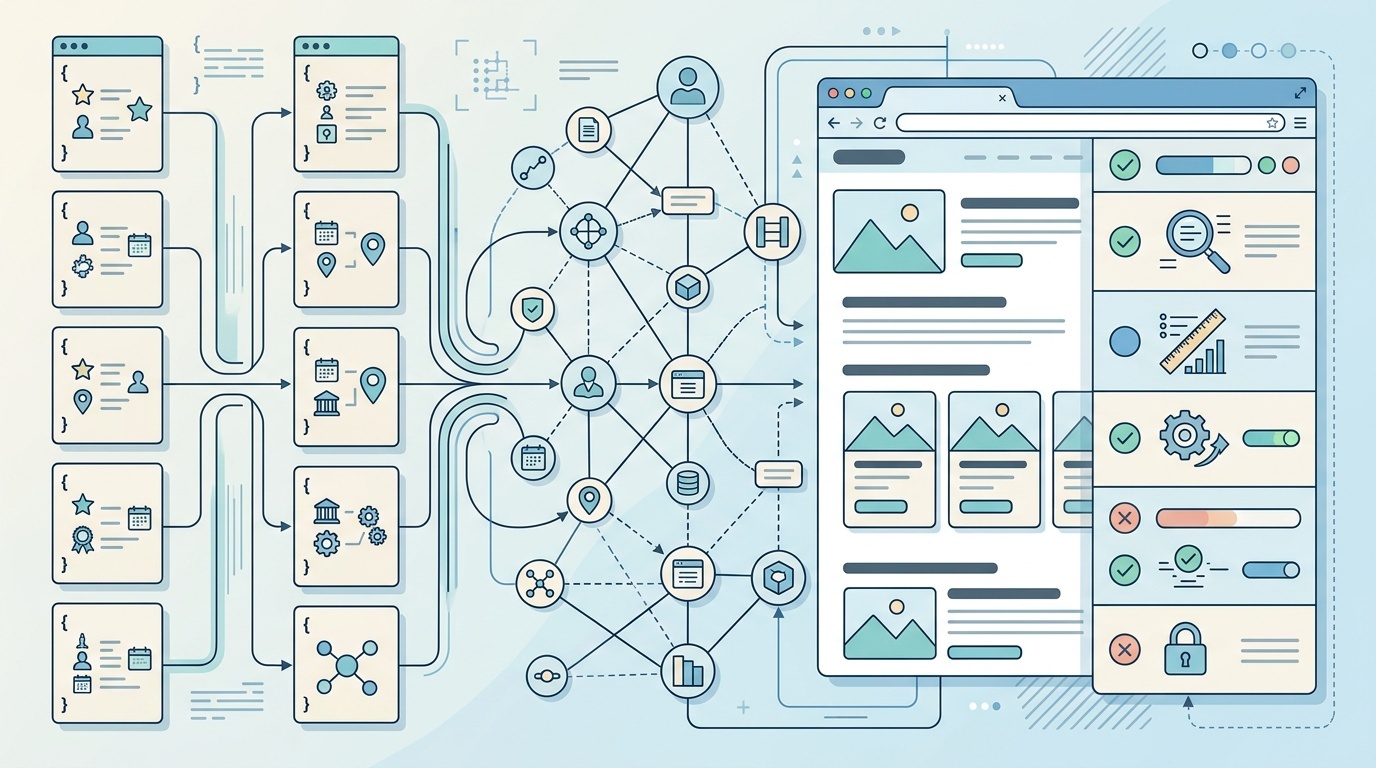
Innehållsförteckning
- Vad validerar du egentligen?
- Steg 1: Parsa JSON innan du tänker på SEO
- Steg 2: Kontrollera JSON-LD-beteende, inte bara JSON-syntax
- Steg 3: Validera mot Schema.org-vokabulären
- Steg 4: Jämför markup med synligt innehåll
- Article och BlogPosting
- Product
- LocalBusiness
- BreadcrumbList
- Steg 5: Validera den renderade sidan, inte din mall
- Steg 6: Kontrollera transportdetaljer i produktion
- Steg 7: Lägg till tester för strukturerade data i er releaseprocess
- En standarder-först-checklista för validering
Validering av strukturerade data har blivit märkligt beroende av verktyg riktade mot Google. Det är begripligt: många team lägger till JSON-LD för att de vill ha utökade resultat, och Googles testverktyg är välbekanta. Men strukturerade data är inte ett Google-format. Det är vanligtvis JSON-LD med Schema.org-vokabulär, inbäddat i HTML, tolkat av många konsumenter och underhållet av ert eget publiceringsflöde.
Om du bara validerar genom en sökmotorlins kan du missa grundläggande problem: ogiltig JSON, data som försvinner efter rendering, inaktuella produktpriser, motstridiga kanoniska URL:er eller markup som är tekniskt giltig men semantiskt märklig.
Ett bättre arbetsflöde utgår först från standarder. Validera datan som data, validera sedan vokabulären och därefter sidan så som den faktiskt finns i produktion.
Vad validerar du egentligen?
”Strukturerade data” är inte en enda sak. På de flesta webbplatser består det av fyra lager:
- JSON-syntax — går koden att parsa?
- JSON-LD-modell — expanderar den till meningsfull länkad data?
- Schema.org-vokabulär — är typerna och egenskaperna rimliga?
- Sanning på sidnivå — stämmer markupen med det användare och crawlers kan se?
Googles verktyg fokuserar främst på det fjärde lagret plus Google-specifik behörighet för utökade resultat. Användbart, ja. Fullständigt, nej.
Det här kan till exempel vara giltig JSON-LD och ändå vara svaga strukturerade data:
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "Best winter jackets",
  "datePublished": "2026-01-12",
  "author": {
    "@type": "Organization",
    "name": "Editorial Team"
  }
}
Inget är trasigt här. Men om den synliga sidan har en annan rubrik, ingen författarattribuering och ett senast ändrad-datum som motsäger markupen, har du ett kvalitetsproblem snarare än ett syntaxproblem.
Steg 1: Parsa JSON innan du tänker på SEO
Börja med den tråkiga kontrollen: går JSON att parsa?
JSON-LD inbäddad i HTML går ofta sönder på grund av små mallfel:
- avslutande kommatecken
- icke-escapade citattecken i produktnamn
- ogiltiga radbrytningar inuti strängar
- saknade klamrar efter villkorade fält
- dubbla script-block från layoutarv
- CMS-plugins som matar ut ofullständiga objekt
För lokala kontroller behöver du ingen SEO-plattform. Använd verktygen som redan finns i din utvecklingsstack.
I JavaScript:
const blocks = [...document.querySelectorAll('script[type="application/ld+json"]')];

for (const block of blocks) {
  try {
    JSON.parse(block.textContent);
  } catch (error) {
    console.error('Invalid JSON-LD:', error.message, block);
  }
}
I CI kan du extrahera script-innehållet från renderad HTML och parsa det som JSON. Det fångar många problem innan de når produktion.
Den viktiga poängen: gör detta före all Schema.org-validering. En vokabulärvalidator kan inte hjälpa om datan inte är giltig JSON.
Steg 2: Kontrollera JSON-LD-beteende, inte bara JSON-syntax
Giltig JSON är inte automatiskt giltig JSON-LD. JSON-LD använder begrepp som @context, @type, @id och grafrelationer. Om de är felaktigt utformade kan parsers tolka din data annorlunda än du avsåg.
Bekräfta åtminstone att:
- varje block har en lämplig
@context - primära entiteter har tydliga
@type-värden - återkommande entiteter använder stabila
@id-värden där det är användbart - nästlade entiteter är logiskt kopplade
- arrayer används när flera värden är möjliga
För större webbplatser är stabila identifierare särskilt hjälpsamma. Om din organisation förekommer i data för Article, Product, BreadcrumbList och FAQPage hjälper samma @id konsumenter att förstå att detta är referenser till samma entitet, inte fyra orelaterade organisationer med samma namn.
Ett typiskt mönster ser ut så här:
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "@id": "https://example.com/#organization",
  "name": "Example Ltd",
  "url": "https://example.com/"
}
Du försöker inte imponera på en validator här. Du gör din data mindre tvetydig.
Steg 3: Validera mot Schema.org-vokabulären
När JSON- och JSON-LD-strukturen är stabil kontrollerar du vokabulären.
Schema.org-validatorn är användbar eftersom den testar mot Schema.org-termer snarare än en enskild sökmotors regler för utökade resultat. Den kan visa om egenskaper känns igen, om typer tolkas som förväntat och om dina nästlade strukturer är rimliga.
Det är här du fångar misstag som:
publishingDatei stället fördatePublishedimageUrldärimageförväntasProduct-markup på en kategorilista som inte är en produktAggregateRatingutan ett meningsfullt recenserat objektPersonanvänt för ett varumärkeskonto
Var försiktig med varningar. Schema.org är avsiktligt flexibelt. En validator kan tillåta en egenskap som inte är användbar för ditt användningsfall, eller varna för något som är valfritt. Behandla validering som bevis, inte som en dom.
En praktisk regel: om en egenskap hjälper en maskin att förstå sidan mer korrekt, behåll den. Om den bara finns där för att någon kopierade den från en snippet-generator, ifrågasätt den.
Steg 4: Jämför markup med synligt innehåll
Sökmotorer och andra datakonsumenter tenderar att misstro markup som inte stämmer med sidan. Ännu viktigare är att användare förtjänar konsekvens.
För varje typ av strukturerade data, jämför markupen med den synliga sidan:
Article och BlogPosting
Kontrollera att rubrik, författare, publiceringsdatum, ändringsdatum, bild och utgivare är synliga eller rimligt går att härleda. Om du publicerar AI-assisterat innehåll bör dina strukturerade data inte användas för att tvätta oklar upphovsinformation. Vi har skrivit separat om ärlig AI-redovisning på en liten webbplats, och samma princip gäller här: metadata ska förtydliga, inte dölja.
Product
Kontrollera namn, pris, tillgänglighet, valuta, varianter, betyg och antal recensioner. Strukturerade produktdata är särskilt benägna att bli inaktuella eftersom priser och lagerstatus ändras utanför CMS:et.
LocalBusiness
Kontrollera namn, adress, telefonnummer, öppettider och serviceområde. Om sidfoten säger en sak och din JSON-LD säger något annat är JSON-LD inte ”bättre”. Den är motsägelsefull.
BreadcrumbList
Kontrollera att brödsmulornas positioner matchar den synliga brödsmulenavigeringen och att URL:erna är kanoniska, crawlbara och inte omdirigeras i onödan.
Det här är inte glamoröst arbete. Det är också där många problem med strukturerade data hittas.
Steg 5: Validera den renderade sidan, inte din mall
Många webbplatser genererar JSON-LD via JavaScript, tagghanterare, personaliseringslager eller komponenthydrering. Det betyder att mallfilen kanske inte representerar vad en crawler eller webbläsare faktiskt ser.
Validera den renderade HTML:en i minst tre tillstånd:
- lokal utvecklingsbuild
- staging- eller förhandsvisnings-URL
- produktions-URL
Använd webbläsarens DevTools för att inspektera den slutliga DOM:en. Sök efter application/ld+json och kopiera det exakta script-innehåll som finns efter rendering. Om serverrenderad markup skiljer sig från hydrerad markup, bestäm vilken version du förväntar dig att konsumenter ska läsa.
Kontrollera också om strukturerade data dupliceras. Dubbla Article- eller Product-block är vanliga när både ett CMS-plugin och en anpassad komponent matar ut schema. Duplicering är inte alltid förödande, men motstridig duplicering är ett problem: två priser, två författare, två publiceringsdatum eller två kanoniska URL:er.
Det liknar att läsa prestanda- och diagnostikrapporter: den första uppgiften är inte att få panik, utan att skilja signal från brus. Samma vana hjälper när du läser en Lighthouse-rapport utan att få panik — även om strukturerade data i sig inte bör reduceras till en enda poäng.
Steg 6: Kontrollera transportdetaljer i produktion
Strukturerade data kan vara perfekta i din källkod och ändå misslyckas i produktion eftersom sidan inte är tillgänglig på det sätt du antar.
Kontrollera:
- slutlig statuskod är
200, inte en soft 404 - kanonisk URL matchar sidan du validerar
- omdirigeringar är avsiktliga och stabila
- robots-direktiv blockerar inte indexering där indexering förväntas
- HTML ersätts inte av en felsida för vissa user agents
- cachade sidor serverar inte inaktuell JSON-LD
Det är här HTTP-inspektion spelar roll. Om en produktsida omdirigeras genom tre URL:er innan den når en kanonisk destination, validera slutsidan, inte den första URL:en som kopierades från CMS:et. För den råa mekaniken är vår guide till felsökning av omdirigeringar och HTTP-headers i produktion en användbar följeslagare.
Strukturerade data lever inte i ett vakuum. De färdas med headers, omdirigeringar, cachelagring, kanoniska taggar och robots-direktiv.
Steg 7: Lägg till tester för strukturerade data i er releaseprocess
Manuell validering fungerar bra för en sida. Den skalar inte över hundratals eller tusentals URL:er.
En enkel automatiserad testsvit kan fånga de dyraste misstagen:
- hämta representativa URL:er från varje malltyp
- extrahera alla JSON-LD-block
- parsa dem med
JSON.parse - verifiera obligatoriska fält för varje sidtyp
- kontrollera att datum är giltiga ISO 8601-strängar
- kontrollera att URL:er är absoluta och kanoniska
- kontrollera att priser och tillgänglighet finns för produktsidor
- kontrollera att duplicerade entiteter inte står i konflikt
Du kan köra detta i CI för mallar och enligt schema för produktions-URL:er. Målet är inte att bevisa att varje funktion för utökade resultat kommer att visas. Ingen utanför sökmotorn kan lova det. Målet är att hålla er egen data korrekt, parsbar och konsekvent.
<!-- tool-cta:start -->
💡 Prova detta: Innan du validerar schemalogiken, kör din JSON-LD genom JSON Formatter för att fånga syntaxfel som annars skulle förstöra varje efterföljande kontroll.
<!-- tool-cta:end -->
En standarder-först-checklista för validering
Använd den här korta checklistan innan du frågar om en sökmotor gillar sidan:
- Är varje JSON-LD-block giltig JSON?
- Innehåller varje block rätt
@contextoch@type? - Är Schema.org-egenskaper stavade korrekt?
- Stämmer markupen med synligt innehåll?
- Är datum, priser, betyg och tillgänglighet aktuella?
- Är URL:er absoluta, kanoniska och nåbara?
- Är den renderade produktionssidan samma sida som du testade?
- Är duplicerade entiteter avsiktliga och utan konflikter?
Om du kan svara ja på de frågorna har du gjort den hållbara delen av arbetet med strukturerade data. Sökspecifik testning kan fortfarande vara användbar senare, men den bör vara den sista kompatibilitetskontrollen, inte grunden för din valideringsprocess.
Vanliga frågor
Kan jag validera strukturerade data utan att använda Google alls?
Räcker giltig Schema.org-markup för att få utökade resultat?
Bör strukturerade data alltid vara serverrenderade?
Hur ofta bör strukturerade data i produktion kontrolleras?
Vilket är det vanligaste misstaget med strukturerade data?
Källor och vidare läsning