Cara memvalidasi structured data tanpa alat Google
Alur kerja praktis untuk memeriksa JSON-LD, kosakata Schema.org, HTML yang dirender, dan perilaku produksi tanpa menjadikan Google sebagai satu-satunya sumber kebenaran.
Daftar isi
- Apa yang sebenarnya Anda validasi?
- Langkah 1: Parse JSON sebelum memikirkan SEO
- Langkah 2: Periksa perilaku JSON-LD, bukan hanya sintaks JSON
- Langkah 3: Validasi terhadap kosakata Schema.org
- Langkah 4: Bandingkan markup dengan konten yang terlihat
- Article dan BlogPosting
- Product
- LocalBusiness
- BreadcrumbList
- Langkah 5: Validasi halaman yang dirender, bukan template Anda
- Langkah 6: Periksa detail transport produksi
- Langkah 7: Tambahkan pengujian structured data ke proses rilis Anda
- Checklist validasi yang mengutamakan standar
Validasi structured data menjadi agak terlalu bergantung pada alat yang berorientasi Google. Itu dapat dimengerti: banyak tim menambahkan JSON-LD karena mereka menginginkan rich results, dan alat pengujian Google sudah akrab digunakan. Namun structured data bukan format Google. Biasanya, ini adalah JSON-LD yang menggunakan kosakata Schema.org, disematkan dalam HTML, diinterpretasikan oleh banyak konsumen, dan dikelola oleh alur kerja penerbitan Anda sendiri.
Jika Anda hanya memvalidasi melalui lensa mesin pencari, Anda bisa melewatkan masalah dasar: JSON yang tidak valid, data yang hilang setelah rendering, harga produk yang kedaluwarsa, URL kanonis yang saling bertentangan, atau markup yang secara teknis valid tetapi secara semantik janggal.
Alur kerja yang lebih baik adalah mengutamakan standar. Validasi data sebagai data, lalu validasi kosakatanya, lalu validasi halaman sebagaimana adanya di produksi.
Apa yang sebenarnya Anda validasi?
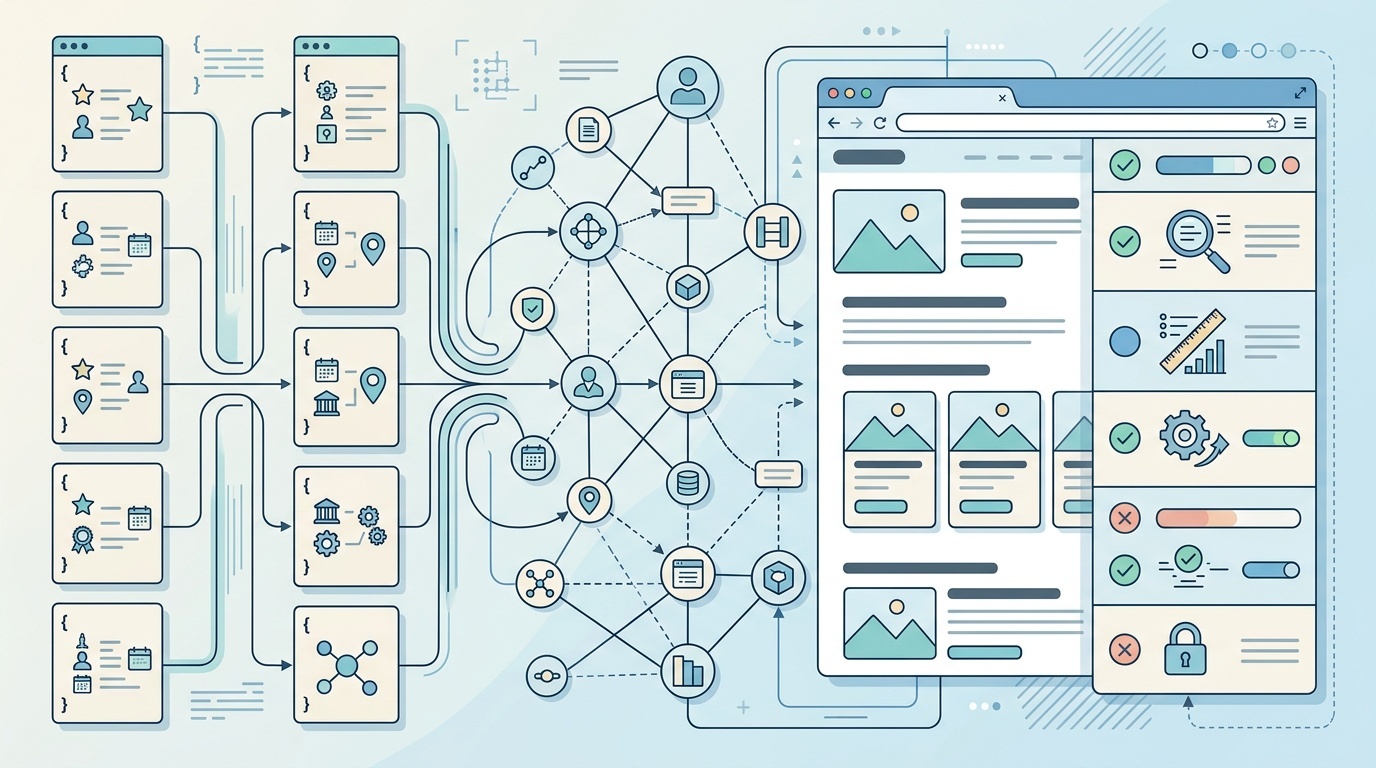
“Structured data” bukan satu hal tunggal. Di sebagian besar situs web, ia memiliki empat lapisan:
- Sintaks JSON — apakah kode dapat di-parse?
- Model JSON-LD — apakah ia dapat diekspansi menjadi linked data yang bermakna?
- Kosakata Schema.org — apakah tipe dan propertinya masuk akal?
- Kebenaran tingkat halaman — apakah markup sesuai dengan apa yang dapat dilihat pengguna dan crawler?
Alat Google sebagian besar berfokus pada lapisan keempat plus kelayakan rich-result khusus Google. Berguna, ya. Lengkap, tidak.
Sebagai contoh, ini bisa berupa JSON-LD yang valid dan tetap menjadi structured data yang buruk:
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "Best winter jackets",
  "datePublished": "2026-01-12",
  "author": {
    "@type": "Organization",
    "name": "Editorial Team"
  }
}
Tidak ada yang rusak di sini. Namun jika halaman yang terlihat memiliki judul berbeda, tidak ada atribusi penulis, dan tanggal terakhir dimodifikasi yang bertentangan dengan markup, Anda memiliki masalah kualitas, bukan masalah sintaks.
Langkah 1: Parse JSON sebelum memikirkan SEO
Mulailah dengan pemeriksaan yang membosankan: apakah JSON dapat di-parse?
JSON-LD yang disematkan dalam HTML sering rusak karena kesalahan kecil pada template:
- koma di akhir
- tanda kutip yang tidak di-escape pada nama produk
- pemutusan baris yang tidak valid di dalam string
- kurung kurawal yang hilang setelah field bersyarat
- blok script duplikat dari pewarisan layout
- plugin CMS yang menghasilkan objek parsial
Untuk pemeriksaan lokal, Anda tidak memerlukan platform SEO. Gunakan alat yang sudah ada dalam stack pengembangan Anda.
Dalam JavaScript:
const blocks = [...document.querySelectorAll('script[type="application/ld+json"]')];

for (const block of blocks) {
  try {
    JSON.parse(block.textContent);
  } catch (error) {
    console.error('Invalid JSON-LD:', error.message, block);
  }
}
Dalam CI, ekstrak isi script dari HTML yang dirender dan parse sebagai JSON. Ini menangkap banyak masalah sebelum mencapai produksi.
Poin pentingnya: lakukan ini sebelum validasi Schema.org apa pun. Validator kosakata tidak dapat membantu jika datanya bukan JSON yang valid.
Langkah 2: Periksa perilaku JSON-LD, bukan hanya sintaks JSON
JSON yang valid tidak otomatis berarti JSON-LD yang valid. JSON-LD menggunakan konsep seperti @context, @type, @id, dan relasi graph. Jika hal-hal tersebut salah bentuk, parser dapat menginterpretasikan data Anda secara berbeda dari yang Anda maksudkan.
Minimal, pastikan:
- setiap blok memiliki
@contextyang sesuai - entitas utama memiliki nilai
@typeyang jelas - entitas yang berulang menggunakan nilai
@idyang stabil jika berguna - entitas bertingkat terhubung secara logis
- array digunakan ketika beberapa nilai memungkinkan
Untuk situs yang lebih besar, identifier yang stabil sangat membantu. Jika organisasi Anda muncul dalam data Article, Product, BreadcrumbList, dan FAQPage, penggunaan @id yang sama membantu konsumen memahami bahwa ini adalah referensi ke entitas yang sama, bukan empat organisasi tidak terkait dengan nama yang sama.
Pola umum terlihat seperti ini:
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "@id": "https://example.com/#organization",
  "name": "Example Ltd",
  "url": "https://example.com/"
}
Anda tidak sedang mencoba membuat validator terkesan di sini. Anda sedang membuat data Anda tidak terlalu ambigu.
Langkah 3: Validasi terhadap kosakata Schema.org
Setelah struktur JSON dan JSON-LD sudah baik, periksa kosakatanya.
Validator Schema.org berguna karena menguji terhadap istilah Schema.org, bukan aturan rich-result dari satu mesin pencari. Ia dapat menunjukkan apakah properti dikenali, apakah tipe diinterpretasikan sebagaimana diharapkan, dan apakah struktur bertingkat Anda masuk akal.
Di sinilah Anda menangkap kesalahan seperti:
publishingDatealih-alihdatePublishedimageUrlketika yang diharapkan adalahimage- markup
Productpada daftar kategori yang bukan produk AggregateRatingtanpa item yang diulas secara bermaknaPersondigunakan untuk akun merek
Berhati-hatilah dengan peringatan. Schema.org memang sengaja fleksibel. Validator mungkin mengizinkan properti yang tidak berguna untuk kasus penggunaan Anda, atau memperingatkan sesuatu yang opsional. Perlakukan validasi sebagai bukti, bukan vonis.
Aturan praktis: jika sebuah properti membantu mesin memahami halaman dengan lebih akurat, pertahankan. Jika properti itu ada hanya karena seseorang menyalinnya dari generator snippet, pertanyakan.
Langkah 4: Bandingkan markup dengan konten yang terlihat
Mesin pencari dan konsumen data lainnya cenderung tidak mempercayai markup yang tidak sesuai dengan halaman. Yang lebih penting, pengguna berhak mendapatkan konsistensi.
Untuk setiap tipe structured data, bandingkan markup dengan halaman yang terlihat:
Article dan BlogPosting
Periksa bahwa judul, penulis, tanggal publikasi, tanggal modifikasi, gambar, dan publisher terlihat atau dapat disimpulkan secara wajar. Jika Anda menerbitkan konten yang dibantu AI, structured data Anda tidak boleh digunakan untuk menyamarkan kepenulisan yang tidak jelas. Kami telah menulis secara terpisah tentang pengungkapan AI yang jujur pada situs web kecil, dan prinsip yang sama berlaku di sini: metadata seharusnya memperjelas, bukan mengaburkan.
Product
Periksa nama, harga, ketersediaan, mata uang, varian, rating, dan jumlah ulasan. Structured data produk sangat rentan menjadi kedaluwarsa karena harga dan status stok berubah di luar CMS.
LocalBusiness
Periksa nama, alamat, nomor telepon, jam buka, dan area layanan. Jika footer Anda mengatakan satu hal dan JSON-LD Anda mengatakan hal lain, JSON-LD tidak “lebih baik”. Ia kontradiktif.
BreadcrumbList
Periksa bahwa posisi breadcrumb sesuai dengan jejak breadcrumb yang terlihat dan bahwa URL bersifat kanonis, dapat di-crawl, dan tidak dialihkan secara tidak perlu.
Ini bukan pekerjaan yang glamor. Ini juga tempat banyak masalah structured data ditemukan.
Langkah 5: Validasi halaman yang dirender, bukan template Anda
Banyak situs menghasilkan JSON-LD melalui JavaScript, tag manager, lapisan personalisasi, atau hydration komponen. Itu berarti file template mungkin tidak merepresentasikan apa yang sebenarnya dilihat crawler atau browser.
Validasi HTML yang dirender setidaknya dalam tiga keadaan:
- build pengembangan lokal
- URL staging atau preview
- URL produksi
Gunakan browser DevTools untuk memeriksa DOM akhir. Cari application/ld+json dan salin persis isi script yang ada setelah rendering. Jika markup yang dirender server berbeda dari markup yang sudah di-hydrate, tentukan versi mana yang Anda harapkan dibaca oleh konsumen.
Periksa juga apakah structured data diduplikasi. Blok Article atau Product duplikat umum terjadi ketika plugin CMS dan komponen kustom sama-sama mengeluarkan schema. Duplikasi tidak selalu fatal, tetapi duplikasi yang bertentangan adalah masalah: dua harga, dua penulis, dua tanggal publikasi, atau dua URL kanonis.
Ini mirip dengan membaca laporan performa dan diagnostik: tugas pertama bukan panik, melainkan memisahkan sinyal dari noise. Kebiasaan yang sama membantu saat Anda membaca laporan Lighthouse tanpa panik — meskipun structured data itu sendiri tidak seharusnya direduksi menjadi satu skor.
Langkah 6: Periksa detail transport produksi
Structured data bisa sempurna di source Anda dan tetap gagal di produksi karena halaman tidak dapat diakses dengan cara yang Anda asumsikan.
Periksa:
- status code akhir adalah
200, bukan soft 404 - URL kanonis sesuai dengan halaman yang Anda validasi
- redirect disengaja dan stabil
- direktif robots tidak memblokir indexing ketika indexing diharapkan
- HTML tidak digantikan oleh halaman error untuk beberapa user agent
- halaman cache tidak menyajikan JSON-LD yang kedaluwarsa
Di sinilah inspeksi HTTP penting. Jika halaman produk dialihkan melalui tiga URL sebelum mencapai tujuan kanonis, validasi halaman akhir, bukan URL pertama yang disalin dari CMS. Untuk mekanisme mentahnya, panduan kami tentang debugging redirect dan header HTTP di produksi adalah pendamping yang berguna.
Structured data tidak hidup dalam ruang hampa. Ia berjalan bersama header, redirect, caching, tag kanonis, dan direktif robots.
Langkah 7: Tambahkan pengujian structured data ke proses rilis Anda
Validasi manual baik untuk satu halaman. Namun itu tidak dapat diskalakan ke ratusan atau ribuan URL.
Rangkaian pengujian otomatis sederhana dapat menangkap kesalahan yang paling mahal:
- fetch URL representatif dari setiap tipe template
- ekstrak semua blok JSON-LD
- parse dengan
JSON.parse - assert field wajib untuk setiap tipe halaman
- periksa bahwa tanggal adalah string ISO 8601 yang valid
- periksa bahwa URL bersifat absolut dan kanonis
- periksa bahwa harga dan ketersediaan ada untuk halaman produk
- periksa bahwa entitas duplikat tidak saling bertentangan
Anda dapat menjalankannya di CI untuk template dan secara terjadwal untuk URL produksi. Tujuannya bukan membuktikan bahwa setiap fitur rich-result akan muncul. Tidak ada orang di luar mesin pencari yang dapat menjanjikan itu. Tujuannya adalah menjaga data Anda sendiri tetap akurat, dapat di-parse, dan konsisten.
<!-- tool-cta:start -->
💡 Coba ini: Sebelum memvalidasi logika skema, jalankan JSON-LD Anda melalui JSON Formatter untuk menangkap kesalahan sintaks yang jika tidak akan merusak setiap pemeriksaan lanjutan.
<!-- tool-cta:end -->
Checklist validasi yang mengutamakan standar
Gunakan checklist singkat ini sebelum bertanya apakah mesin pencari menyukai halaman tersebut:
- Apakah setiap blok JSON-LD merupakan JSON yang valid?
- Apakah setiap blok menyertakan
@contextdan@typeyang benar? - Apakah properti Schema.org dieja dengan benar?
- Apakah markup sesuai dengan konten yang terlihat?
- Apakah tanggal, harga, rating, dan ketersediaan masih mutakhir?
- Apakah URL bersifat absolut, kanonis, dan dapat dijangkau?
- Apakah halaman produksi yang dirender adalah halaman yang sama dengan yang Anda uji?
- Apakah entitas duplikat disengaja dan tidak saling bertentangan?
Jika Anda dapat menjawab ya untuk pertanyaan-pertanyaan tersebut, Anda telah melakukan bagian yang tahan lama dari pekerjaan structured data. Pengujian khusus pencarian masih dapat berguna nanti, tetapi seharusnya menjadi pemeriksaan kompatibilitas terakhir, bukan fondasi proses validasi Anda.
Pertanyaan yang sering diajukan
Bisakah saya memvalidasi structured data tanpa menggunakan Google sama sekali?
Apakah markup Schema.org yang valid cukup untuk mendapatkan rich results?
Apakah structured data harus selalu dirender di server?
Seberapa sering structured data produksi harus diperiksa?
Apa kesalahan structured data yang paling umum?
Sumber & bacaan lebih lanjut