Slik validerer du strukturerte data uten Google-verktøy
En praktisk arbeidsflyt for å kontrollere JSON-LD, Schema.org-vokabular, gjengitt HTML og produksjonsatferd uten å behandle Google som den eneste sannhetskilden.
Innholdsfortegnelse
- Hva validerer du egentlig?
- Trinn 1: Parse JSON før du tenker på SEO
- Trinn 2: Kontroller JSON-LD-atferd, ikke bare JSON-syntaks
- Trinn 3: Valider mot Schema.org-vokabular
- Trinn 4: Sammenlign markup med synlig innhold
- Article og BlogPosting
- Product
- LocalBusiness
- BreadcrumbList
- Trinn 5: Valider den gjengitte siden, ikke malen din
- Trinn 6: Kontroller transportdetaljer i produksjon
- Trinn 7: Legg til tester for strukturerte data i release-prosessen
- En standardbasert valideringssjekkliste
Validering av strukturerte data har blitt merkelig avhengig av Google-rettede verktøy. Det er forståelig: mange team legger til JSON-LD fordi de ønsker rich results, og Googles testverktøy er kjente. Men strukturerte data er ikke et Google-format. Det er vanligvis JSON-LD med Schema.org-vokabular, innebygd i HTML, tolket av mange forbrukere og vedlikeholdt av din egen publiseringsflyt.
Hvis du bare validerer gjennom en søkemotorlinse, kan du overse grunnleggende problemer: ugyldig JSON, data som forsvinner etter gjengivelse, utdaterte produktpriser, motstridende kanoniske URL-er eller markup som teknisk sett er gyldig, men semantisk meningsløs.
En bedre arbeidsflyt starter med standardene. Valider dataene som data, valider deretter vokabularet, og valider så siden slik den faktisk finnes i produksjon.
Hva validerer du egentlig?
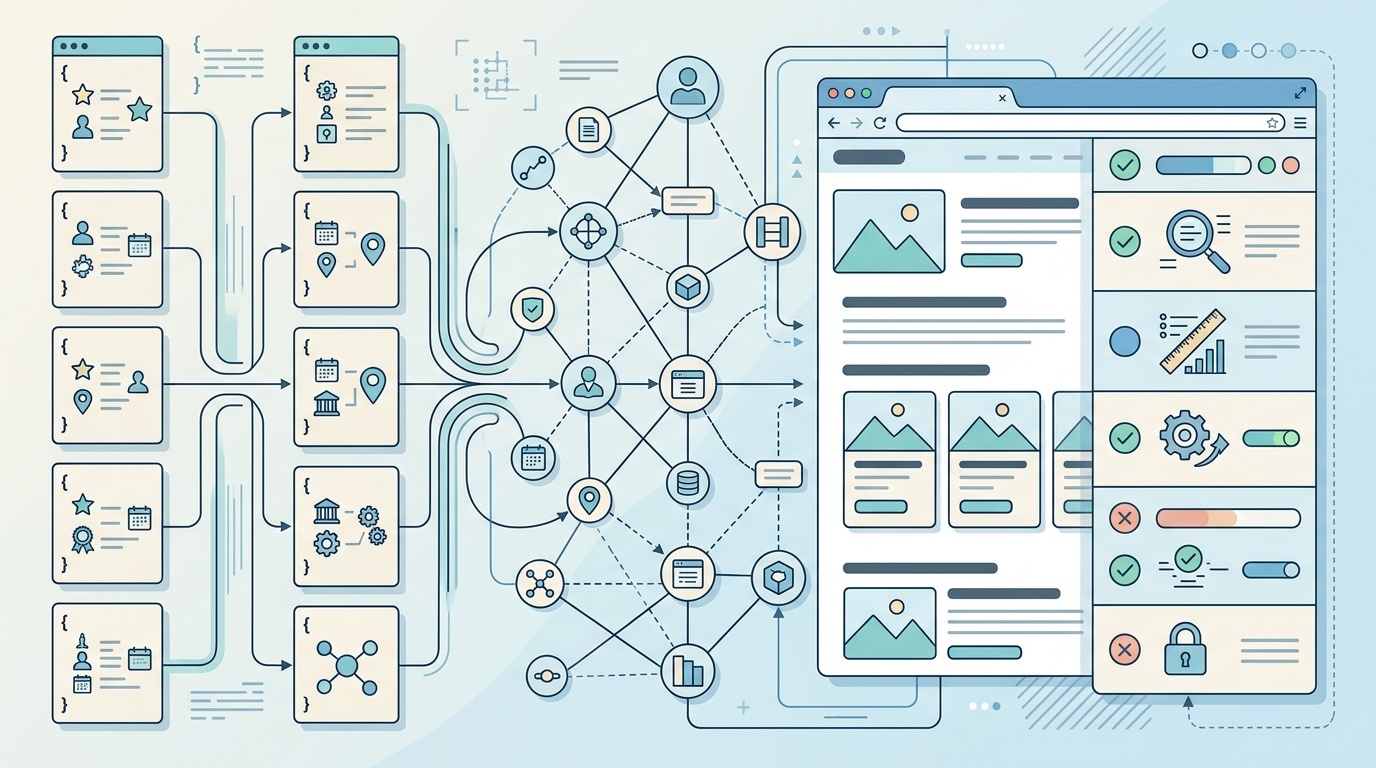
«Strukturerte data» er ikke én ting. På de fleste nettsteder har det fire lag:
- JSON-syntaks — kan koden parses?
- JSON-LD-modell — utvides den til meningsfulle lenkede data?
- Schema.org-vokabular — er typene og egenskapene plausible?
- Sannhet på sidenivå — samsvarer markupen med det brukere og crawlere kan se?
Google-verktøy fokuserer hovedsakelig på det fjerde laget pluss Google-spesifikk kvalifisering for rich results. Nyttig, ja. Fullstendig, nei.
Dette kan for eksempel være gyldig JSON-LD og likevel være dårlige strukturerte data:
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "Best winter jackets",
  "datePublished": "2026-01-12",
  "author": {
    "@type": "Organization",
    "name": "Editorial Team"
  }
}
Ingenting er ødelagt her. Men hvis den synlige siden har en annen overskrift, ingen forfatterangivelse og en sist endret-dato som motsier markupen, har du et kvalitetsproblem snarere enn et syntaksproblem.
Trinn 1: Parse JSON før du tenker på SEO
Start med den kjedelige kontrollen: kan JSON parses?
JSON-LD som er innebygd i HTML, går ofte i stykker på grunn av små feil i maler:
- etterfølgende kommaer
- uescapede anførselstegn i produktnavn
- ugyldige linjeskift inne i strenger
- manglende klammeparenteser etter betingede felt
- dupliserte script-blokker fra layoutarv
- CMS-plugins som skriver ut delvise objekter
For lokale kontroller trenger du ikke en SEO-plattform. Bruk verktøyene du allerede har i utviklingsstakken.
I JavaScript:
const blocks = [...document.querySelectorAll('script[type="application/ld+json"]')];

for (const block of blocks) {
  try {
    JSON.parse(block.textContent);
  } catch (error) {
    console.error('Invalid JSON-LD:', error.message, block);
  }
}
I CI kan du hente ut script-innholdet fra gjengitt HTML og parse det som JSON. Dette fanger mange problemer før de når produksjon.
Det viktige poenget: gjør dette før all Schema.org-validering. En vokabularvalidator kan ikke hjelpe hvis dataene ikke er gyldig JSON.
Trinn 2: Kontroller JSON-LD-atferd, ikke bare JSON-syntaks
Gyldig JSON er ikke automatisk gyldig JSON-LD. JSON-LD bruker begreper som @context, @type, @id og grafforhold. Hvis disse er feilformet, kan parsere tolke dataene annerledes enn du mente.
Bekreft som et minimum:
- at hver blokk har en passende
@context - at primærenheter har tydelige
@type-verdier - at gjentatte enheter bruker stabile
@id-verdier der det er nyttig - at nestede enheter er logisk koblet sammen
- at arrays brukes når flere verdier er mulige
For større nettsteder er stabile identifikatorer spesielt nyttige. Hvis organisasjonen din vises i Article-, Product-, BreadcrumbList- og FAQPage-data, hjelper bruk av samme @id forbrukere med å forstå at dette er referanser til samme enhet, ikke fire urelaterte organisasjoner med samme navn.
Et typisk mønster ser slik ut:
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "@id": "https://example.com/#organization",
  "name": "Example Ltd",
  "url": "https://example.com/"
}
Du prøver ikke å imponere en validator her. Du gjør dataene dine mindre tvetydige.
Trinn 3: Valider mot Schema.org-vokabular
Når JSON- og JSON-LD-strukturen er solid, kontrollerer du vokabularet.
Schema.org-validatoren er nyttig fordi den tester mot Schema.org-termer i stedet for én søkemotors regler for rich results. Den kan vise om egenskaper gjenkjennes, om typer tolkes som forventet, og om de nestede strukturene dine gir mening.
Det er her du fanger feil som:
publishingDatei stedet fordatePublishedimageUrlderimageforventesProduct-markup på en kategoriliste som ikke er et produktAggregateRatinguten et meningsfullt vurdert elementPersonbrukt for en merkevarekonto
Vær forsiktig med advarsler. Schema.org er med vilje fleksibelt. En validator kan tillate en egenskap som ikke er nyttig for ditt bruksområde, eller advare om noe som er valgfritt. Behandle validering som bevis, ikke som en dom.
En praktisk regel: hvis en egenskap hjelper en maskin med å forstå siden mer presist, behold den. Hvis den bare finnes fordi noen kopierte den fra en snippet-generator, bør du stille spørsmål ved den.
Trinn 4: Sammenlign markup med synlig innhold
Søkemotorer og andre dataforbrukere har en tendens til å mistro markup som ikke samsvarer med siden. Enda viktigere: brukere fortjener konsistens.
For hver type strukturerte data sammenligner du markupen med den synlige siden:
Article og BlogPosting
Kontroller at overskrift, forfatter, publiseringsdato, endringsdato, bilde og utgiver er synlige eller rimelig utledbare. Hvis du publiserer KI-støttet innhold, bør ikke de strukturerte dataene dine brukes til å hvitvaske uklar forfatterskap. Vi har skrevet separat om ærlig KI-merking på et lite nettsted, og det samme prinsippet gjelder her: metadata bør klargjøre, ikke tilsløre.
Product
Kontroller navn, pris, tilgjengelighet, valuta, varianter, vurderinger og antall anmeldelser. Strukturerte produktdata blir særlig ofte utdaterte fordi priser og lagerstatus endres utenfor CMS-et.
LocalBusiness
Kontroller navn, adresse, telefonnummer, åpningstider og tjenesteområde. Hvis footeren din sier én ting og JSON-LD-en sier noe annet, er ikke JSON-LD-en «bedre». Den er motstridende.
BreadcrumbList
Kontroller at brødsmuleposisjonene samsvarer med den synlige brødsmulestien, og at URL-er er kanoniske, crawlbare og ikke omdirigeres unødvendig.
Dette er ikke glamorøst arbeid. Det er også her mange problemer med strukturerte data blir funnet.
Trinn 5: Valider den gjengitte siden, ikke malen din
Mange nettsteder genererer JSON-LD gjennom JavaScript, tag managers, personaliseringslag eller komponenthydrering. Det betyr at malfilen ikke nødvendigvis representerer det en crawler eller nettleser faktisk ser.
Valider den gjengitte HTML-en i minst tre tilstander:
- lokal utviklingsbuild
- staging- eller forhåndsvisnings-URL
- produksjons-URL
Bruk nettleserens DevTools til å inspisere den endelige DOM-en. Søk etter application/ld+json og kopier det nøyaktige script-innholdet som finnes etter gjengivelse. Hvis servergjengitt markup skiller seg fra hydrert markup, må du avgjøre hvilken versjon du forventer at forbrukere skal lese.
Kontroller også om strukturerte data dupliseres. Dupliserte Article- eller Product-blokker er vanlige når en CMS-plugin og en tilpasset komponent begge sender ut schema. Duplisering er ikke alltid fatalt, men motstridende duplisering er et problem: to priser, to forfattere, to publiseringsdatoer eller to kanoniske URL-er.
Dette ligner på å lese ytelses- og diagnostikkrapporter: den første oppgaven er ikke å få panikk, men å skille signal fra støy. Den samme vanen hjelper når du leser en Lighthouse-rapport uten å få panikk — selv om strukturerte data i seg selv ikke bør reduseres til én enkelt poengsum.
Trinn 6: Kontroller transportdetaljer i produksjon
Strukturerte data kan være perfekte i kildekoden din og likevel feile i produksjon fordi siden ikke er tilgjengelig på den måten du antar.
Kontroller:
- at endelig statuskode er
200, ikke en soft 404 - at kanonisk URL samsvarer med siden du validerer
- at omdirigeringer er tilsiktede og stabile
- at robots-direktiver ikke blokkerer indeksering der indeksering forventes
- at HTML ikke erstattes av en feilside for enkelte user agents
- at cachede sider ikke serverer utdatert JSON-LD
Det er her HTTP-inspeksjon betyr noe. Hvis en produktside omdirigerer gjennom tre URL-er før den når en kanonisk destinasjon, validerer du den endelige siden, ikke den første URL-en som ble kopiert fra CMS-et. For de rå mekanismene er guiden vår til feilsøking av omdirigeringer og HTTP-headere i produksjon en nyttig følgesvenn.
Strukturerte data lever ikke i et vakuum. De reiser sammen med headere, omdirigeringer, caching, kanoniske tagger og robots-direktiver.
Trinn 7: Legg til tester for strukturerte data i release-prosessen
Manuell validering er greit for én side. Det skalerer ikke på tvers av hundrevis eller tusenvis av URL-er.
En enkel automatisert testpakke kan fange de dyreste feilene:
- hent representative URL-er fra hver maltype
- trekk ut alle JSON-LD-blokker
- parse dem med
JSON.parse - verifiser obligatoriske felt for hver sidetype
- kontroller at datoer er gyldige ISO 8601-strenger
- kontroller at URL-er er absolutte og kanoniske
- kontroller at priser og tilgjengelighet finnes for produktsider
- kontroller at dupliserte enheter ikke er i konflikt
Du kan kjøre dette i CI for maler og etter en tidsplan for produksjons-URL-er. Målet er ikke å bevise at hver rich-result-funksjon vil vises. Ingen utenfor søkemotoren kan love det. Målet er å holde dine egne data nøyaktige, parsebare og konsistente.
<!-- tool-cta:start -->
💡 Prøv dette: Før du validerer skjemalogikken, kjør JSON-LD-en din gjennom JSON Formatter for å fange syntaksfeil som ellers ville ødelagt hver etterfølgende kontroll.
<!-- tool-cta:end -->
En standardbasert valideringssjekkliste
Bruk denne korte sjekklisten før du spør om en søkemotor liker siden:
- Er hver JSON-LD-blokk gyldig JSON?
- Inneholder hver blokk riktig
@contextog@type? - Er Schema.org-egenskaper stavet riktig?
- Samsvarer markupen med synlig innhold?
- Er datoer, priser, vurderinger og tilgjengelighet oppdaterte?
- Er URL-er absolutte, kanoniske og tilgjengelige?
- Er den gjengitte produksjonssiden den samme siden du testet?
- Er dupliserte enheter tilsiktede og uten konflikter?
Hvis du kan svare ja på disse spørsmålene, har du gjort den robuste delen av arbeidet med strukturerte data. Søkespecifikk testing kan fortsatt være nyttig senere, men den bør være den siste kompatibilitetskontrollen, ikke fundamentet for valideringsprosessen din.
Ofte stilte spørsmål
Kan jeg validere strukturerte data uten å bruke Google i det hele tatt?
Er gyldig Schema.org-markup nok til å få rich results?
Bør strukturerte data alltid server-renderes?
Hvor ofte bør strukturerte data i produksjon kontrolleres?
Hva er den vanligste feilen med strukturerte data?
Kilder og videre lesning