Cum să validezi datele structurate fără instrumentele Google
Un flux de lucru practic pentru verificarea JSON-LD, a vocabularului Schema.org, a HTML-ului randat și a comportamentului în producție, fără a trata Google drept singura sursă de adevăr.
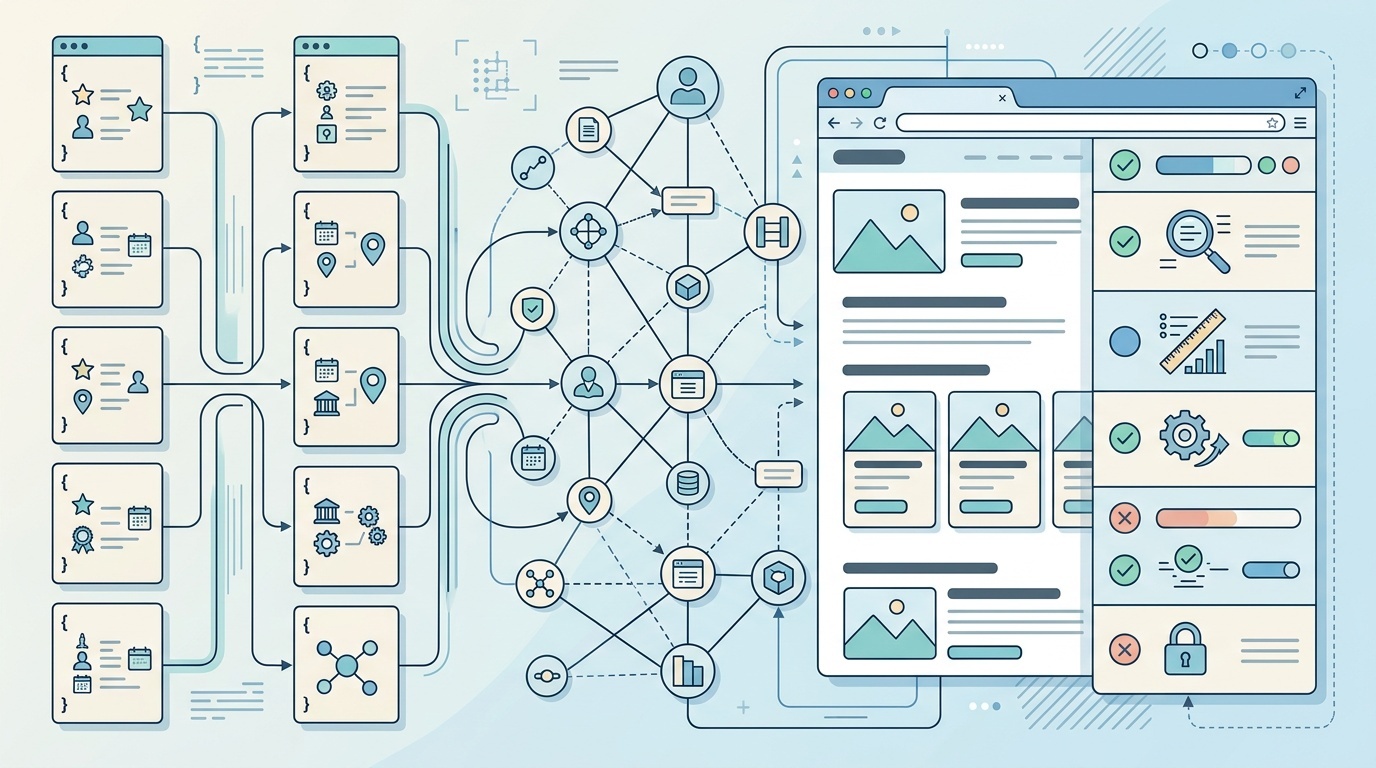
Cuprins
- Ce validezi, de fapt?
- Pasul 1: Parsează JSON-ul înainte să te gândești la SEO
- Pasul 2: Verifică comportamentul JSON-LD, nu doar sintaxa JSON
- Pasul 3: Validează în raport cu vocabularul Schema.org
- Pasul 4: Compară markupul cu conținutul vizibil
- Article și BlogPosting
- Product
- LocalBusiness
- BreadcrumbList
- Pasul 5: Validează pagina randată, nu templateul
- Pasul 6: Verifică detaliile de transport în producție
- Pasul 7: Adaugă teste pentru date structurate în procesul de release
- O listă de verificare orientată pe standarde
Validarea datelor structurate a devenit surprinzător de dependentă de instrumentele orientate către Google. Este de înțeles: multe echipe adaugă JSON-LD pentru că vor rezultate îmbogățite, iar instrumentele de testare Google sunt familiare. Dar datele structurate nu sunt un format Google. De obicei, sunt JSON-LD folosind vocabularul Schema.org, încorporate în HTML, interpretate de mulți consumatori și întreținute prin propriul tău flux de publicare.
Dacă validezi doar prin lentila unui motor de căutare, poți rata probleme de bază: JSON invalid, date care dispar după randare, prețuri de produs învechite, URL-uri canonice contradictorii sau markup valid din punct de vedere tehnic, dar absurd semantic.
Un flux de lucru mai bun pornește de la standarde. Validează datele ca date, apoi validează vocabularul, apoi validează pagina așa cum există ea în producție.
Ce validezi, de fapt?
„Date structurate” nu înseamnă un singur lucru. Pe majoritatea site-urilor, au patru straturi:
- Sintaxa JSON — codul poate fi parsat?
- Modelul JSON-LD — se extinde în date conectate semnificative?
- Vocabularul Schema.org — tipurile și proprietățile sunt plauzibile?
- Adevărul la nivel de pagină — markupul corespunde cu ceea ce pot vedea utilizatorii și crawlerele?
Instrumentele Google se concentrează în mare parte pe al patrulea strat, plus eligibilitatea specifică Google pentru rezultate îmbogățite. Utile, da. Complete, nu.
De exemplu, acesta poate fi JSON-LD valid și totuși date structurate slabe:
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "Best winter jackets",
  "datePublished": "2026-01-12",
  "author": {
    "@type": "Organization",
    "name": "Editorial Team"
  }
}
Nimic nu este stricat aici. Dar dacă pagina vizibilă are un titlu diferit, nu are atribuire de autor și are o dată a ultimei modificări care contrazice markupul, ai o problemă de calitate, nu o problemă de sintaxă.
Pasul 1: Parsează JSON-ul înainte să te gândești la SEO
Începe cu verificarea plictisitoare: JSON-ul poate fi parsat?
JSON-LD încorporat în HTML se strică adesea din cauza unor mici greșeli de template:
- virgule finale
- ghilimele neescapate în numele produselor
- întreruperi de linie invalide în interiorul șirurilor
- acolade lipsă după câmpuri condiționale
- blocuri script duplicate din moștenirea layoutului
- pluginuri CMS care generează obiecte parțiale
Pentru verificări locale, nu ai nevoie de o platformă SEO. Folosește instrumentele pe care le ai deja în stackul de dezvoltare.
În JavaScript:
const blocks = [...document.querySelectorAll('script[type="application/ld+json"]')];

for (const block of blocks) {
  try {
    JSON.parse(block.textContent);
  } catch (error) {
    console.error('Invalid JSON-LD:', error.message, block);
  }
}
În CI, extrage conținutul scripturilor din HTML-ul randat și parsează-l ca JSON. Astfel prinzi multe probleme înainte să ajungă în producție.
Ideea importantă: fă asta înainte de orice validare Schema.org. Un validator de vocabular nu te poate ajuta dacă datele nu sunt JSON valid.
Pasul 2: Verifică comportamentul JSON-LD, nu doar sintaxa JSON
JSON valid nu înseamnă automat JSON-LD valid. JSON-LD folosește concepte precum @context, @type, @id și relații de graf. Dacă acestea sunt malformate, parser-ele îți pot interpreta datele diferit față de intenția ta.
Cel puțin, confirmă că:
- fiecare bloc are un
@contextadecvat - entitățile principale au valori
@typeclare - entitățile repetate folosesc valori
@idstabile acolo unde este util - entitățile imbricate sunt conectate logic
- array-urile sunt folosite atunci când sunt posibile valori multiple
Pentru site-uri mai mari, identificatorii stabili sunt deosebit de utili. Dacă organizația ta apare în date de tip Article, Product, BreadcrumbList și FAQPage, folosirea aceluiași @id îi ajută pe consumatori să înțeleagă că acestea sunt referințe la aceeași entitate, nu patru organizații fără legătură între ele, dar cu același nume.
Un tipar obișnuit arată așa:
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "@id": "https://example.com/#organization",
  "name": "Example Ltd",
  "url": "https://example.com/"
}
Nu încerci să impresionezi un validator aici. Îți faci datele mai puțin ambigue.
Pasul 3: Validează în raport cu vocabularul Schema.org
După ce structura JSON și JSON-LD este solidă, verifică vocabularul.
Validatorul Schema.org este util pentru că testează în raport cu termenii Schema.org, nu cu regulile pentru rezultate îmbogățite ale unui singur motor de căutare. Poate arăta dacă proprietățile sunt recunoscute, dacă tipurile sunt interpretate conform așteptărilor și dacă structurile imbricate au sens.
Aici prinzi greșeli precum:
publishingDateîn loc dedatePublishedimageUrlacolo unde este așteptatimage- markup
Productpe o listare de categorie care nu este un produs AggregateRatingfără un element evaluat semnificativPersonfolosit pentru un cont de brand
Ai grijă cu avertismentele. Schema.org este intenționat flexibil. Un validator poate permite o proprietate care nu este utilă pentru cazul tău de utilizare sau poate avertiza despre ceva opțional. Tratează validarea ca dovadă, nu ca verdict.
O regulă practică: dacă o proprietate ajută o mașină să înțeleagă pagina mai exact, păstreaz-o. Dacă există doar pentru că cineva a copiat-o dintr-un generator de snippeturi, pune-o sub semnul întrebării.
Pasul 4: Compară markupul cu conținutul vizibil
Motoarele de căutare și alți consumatori de date tind să nu aibă încredere în markupul care nu corespunde paginii. Mai important, utilizatorii merită consecvență.
Pentru fiecare tip de date structurate, compară markupul cu pagina vizibilă:
Article și BlogPosting
Verifică dacă titlul, autorul, data publicării, data modificării, imaginea și publisherul sunt vizibile sau rezonabil de inferat. Dacă publici conținut asistat de AI, datele tale structurate nu ar trebui folosite pentru a masca o autorie neclară. Am scris separat despre dezvăluirea onestă a utilizării AI pe un site mic, iar același principiu se aplică aici: metadatele ar trebui să clarifice, nu să ascundă.
Product
Verifică numele, prețul, disponibilitatea, moneda, variantele, ratingurile și numărul de recenzii. Datele structurate pentru produse sunt deosebit de predispuse să devină învechite, deoarece prețurile și stocurile se schimbă în afara CMS-ului.
LocalBusiness
Verifică numele, adresa, numărul de telefon, programul de funcționare și zona de servicii. Dacă footerul spune una, iar JSON-LD spune alta, JSON-LD nu este „mai bun”. Este contradictoriu.
BreadcrumbList
Verifică dacă pozițiile breadcrumburilor corespund traseului breadcrumb vizibil și dacă URL-urile sunt canonice, crawlable și nu sunt redirecționate inutil.
Aceasta nu este muncă spectaculoasă. Este însă locul în care sunt găsite multe probleme de date structurate.
Pasul 5: Validează pagina randată, nu templateul
Multe site-uri generează JSON-LD prin JavaScript, tag manageri, straturi de personalizare sau hidratarea componentelor. Asta înseamnă că fișierul de template poate să nu reprezinte ceea ce vede de fapt un crawler sau un browser.
Validează HTML-ul randat în cel puțin trei stări:
- build local de dezvoltare
- URL de staging sau preview
- URL de producție
Folosește browser DevTools pentru a inspecta DOM-ul final. Caută application/ld+json și copiază conținutul exact al scriptului care există după randare. Dacă markupul randat pe server diferă de markupul hidratat, decide ce versiune te aștepți să citească consumatorii.
Verifică și dacă datele structurate sunt duplicate. Blocurile Article sau Product duplicate sunt comune atunci când un plugin CMS și o componentă custom emit ambele schema. Duplicarea nu este întotdeauna fatală, dar duplicarea contradictorie este o problemă: două prețuri, doi autori, două date de publicare sau două URL-uri canonice.
Este similar cu citirea rapoartelor de performanță și diagnostic: prima sarcină nu este să intri în panică, ci să separi semnalul de zgomot. Același obicei ajută când citești un raport Lighthouse fără panică — deși datele structurate în sine nu ar trebui reduse la un singur scor.
Pasul 6: Verifică detaliile de transport în producție
Datele structurate pot fi perfecte în sursă și totuși pot eșua în producție, deoarece pagina nu este accesibilă în felul în care presupui.
Verifică:
- codul de stare final este
200, nu un soft 404 - URL-ul canonic corespunde paginii pe care o validezi
- redirecționările sunt intenționate și stabile
- directivele robots nu blochează indexarea acolo unde indexarea este așteptată
- HTML-ul nu este înlocuit de o pagină de eroare pentru unii user agents
- paginile din cache nu servesc JSON-LD învechit
Aici contează inspecția HTTP. Dacă o pagină de produs trece prin trei URL-uri înainte de a ajunge la o destinație canonică, validează pagina finală, nu primul URL copiat din CMS. Pentru mecanica brută, ghidul nostru despre depanarea redirecționărilor și a headerelor HTTP în producție este un companion util.
Datele structurate nu trăiesc în vid. Călătoresc împreună cu headere, redirecționări, caching, taguri canonice și directive robots.
Pasul 7: Adaugă teste pentru date structurate în procesul de release
Validarea manuală este suficientă pentru o singură pagină. Nu scalează la sute sau mii de URL-uri.
O suită simplă de teste automate poate prinde cele mai costisitoare greșeli:
- preia URL-uri reprezentative din fiecare tip de template
- extrage toate blocurile JSON-LD
- parsează-le cu
JSON.parse - verifică prin aserțiuni câmpurile obligatorii pentru fiecare tip de pagină
- verifică dacă datele calendaristice sunt șiruri ISO 8601 valide
- verifică dacă URL-urile sunt absolute și canonice
- verifică dacă prețurile și disponibilitatea există pentru paginile de produs
- verifică dacă entitățile duplicate nu intră în conflict
Poți rula asta în CI pentru templateuri și programat pentru URL-urile de producție. Scopul nu este să demonstrezi că fiecare funcționalitate de rezultat îmbogățit va apărea. Nimeni din afara motorului de căutare nu poate promite asta. Scopul este să îți menții propriile date exacte, parsabile și consecvente.
<!-- tool-cta:start -->
💡 Încercați asta: Înainte de a valida logica schemei, treceți JSON-LD-ul prin JSON Formatter pentru a prinde erorile de sintaxă care altfel ar strica fiecare verificare ulterioară.
<!-- tool-cta:end -->
O listă de verificare orientată pe standarde
Folosește această listă scurtă înainte să întrebi dacă unui motor de căutare îi place pagina:
- Este fiecare bloc JSON-LD JSON valid?
- Include fiecare bloc
@contextși@typecorecte? - Sunt proprietățile Schema.org scrise corect?
- Markupul corespunde conținutului vizibil?
- Datele, prețurile, ratingurile și disponibilitatea sunt actuale?
- URL-urile sunt absolute, canonice și accesibile?
- Pagina de producție randată este aceeași pagină pe care ai testat-o?
- Entitățile duplicate sunt intenționate și neconflictuale?
Dacă poți răspunde da la aceste întrebări, ai făcut partea durabilă a muncii cu date structurate. Testarea specifică motoarelor de căutare poate fi în continuare utilă mai târziu, dar ar trebui să fie verificarea finală de compatibilitate, nu fundația procesului tău de validare.
Întrebări frecvente
Pot valida datele structurate fără să folosesc deloc Google?
Este suficient markupul Schema.org valid pentru a obține rezultate îmbogățite?
Datele structurate ar trebui întotdeauna randate pe server?
Cât de des ar trebui verificate datele structurate din producție?
Care este cea mai frecventă greșeală legată de datele structurate?
Surse și lecturi suplimentare