如何在不使用 Google 工具的情况下验证结构化数据
一个实用工作流,用于检查 JSON-LD、Schema.org 词汇、渲染后的 HTML 和生产环境行为,而不是把 Google 视为唯一的事实来源。
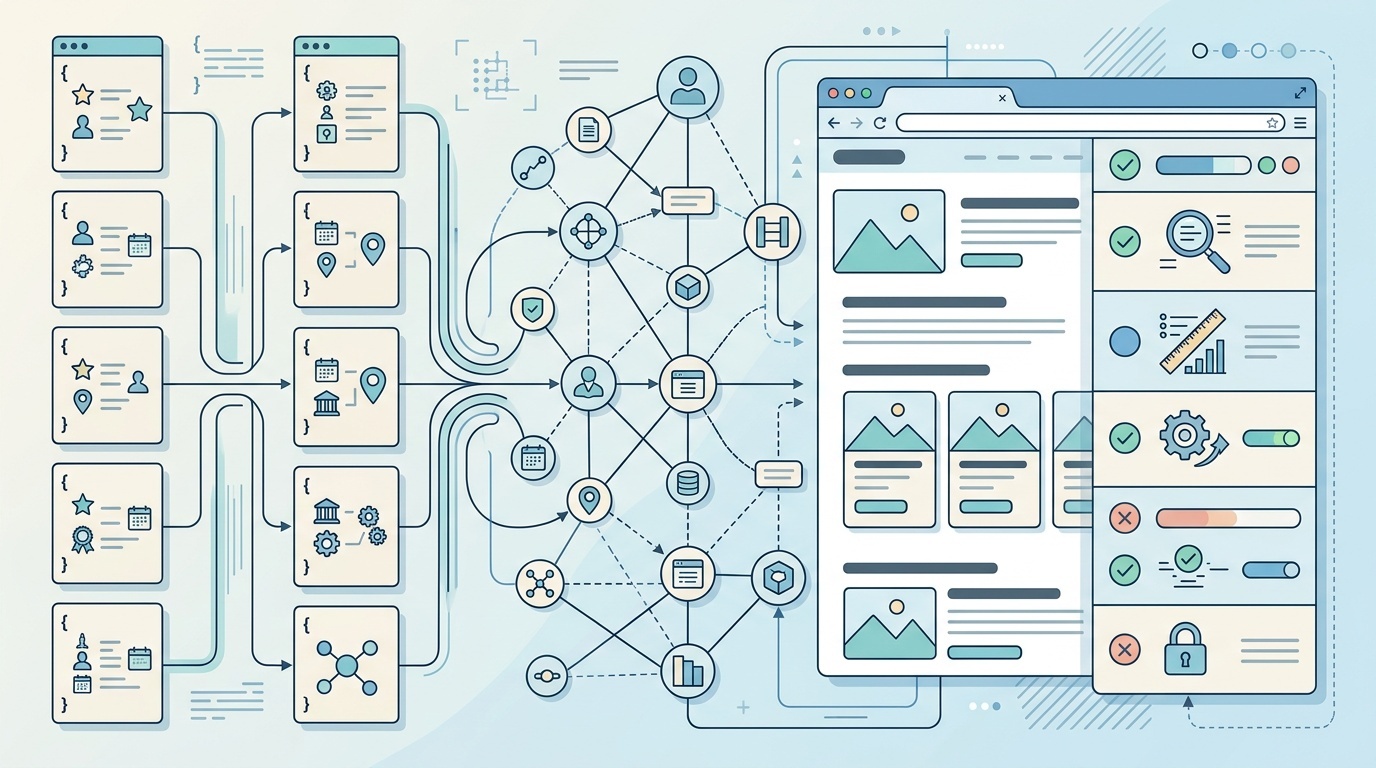
目录
结构化数据验证已经变得出奇地依赖面向 Google 的工具。这可以理解:许多团队添加 JSON-LD,是因为他们想获得富媒体搜索结果,而 Google 的测试工具也很熟悉。但结构化数据并不是 Google 的格式。它通常是在 HTML 中嵌入使用 Schema.org 词汇的 JSON-LD,由许多消费者解释,并由你自己的发布流程维护。
如果你只通过搜索引擎的视角来验证,可能会漏掉一些基本问题:无效的 JSON、渲染后消失的数据、过期的产品价格、相互冲突的规范 URL,或者技术上有效但语义上很荒唐的标记。
更好的工作流是标准优先。先把数据作为数据来验证,再验证词汇,最后验证生产环境中实际存在的页面。
你到底在验证什么?
“结构化数据”并不是单一事物。在大多数网站上,它有四层:
- JSON 语法 — 代码是否可解析?
- JSON-LD 模型 — 它是否能展开为有意义的链接数据?
- Schema.org 词汇 — 类型和属性是否合理?
- 页面层面的真实性 — 标记是否与用户和爬虫能看到的内容一致?
Google 工具主要关注第四层,以及 Google 特定的富媒体搜索结果资格。它有用,但并不完整。
例如,下面这段可以是有效的 JSON-LD,但仍然是糟糕的结构化数据:
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "Best winter jackets",
  "datePublished": "2026-01-12",
  "author": {
    "@type": "Organization",
    "name": "Editorial Team"
  }
}
这里没有任何损坏。但如果可见页面有不同的标题、没有作者署名,并且最后修改日期与标记相矛盾,那么你遇到的是质量问题,而不是语法问题。
第 1 步:在考虑 SEO 之前先解析 JSON
从最枯燥的检查开始:JSON 能否被解析?
嵌入 HTML 的 JSON-LD 经常因为细小的模板错误而损坏:
- 尾随逗号
- 产品名称中未转义的引号
- 字符串内部的无效换行
- 条件字段之后缺少大括号
- 布局继承导致重复的 script 块
- CMS 插件输出不完整对象
对于本地检查,你不需要 SEO 平台。使用你开发栈中已有的工具即可。
在 JavaScript 中:
const blocks = [...document.querySelectorAll('script[type="application/ld+json"]')];

for (const block of blocks) {
  try {
    JSON.parse(block.textContent);
  } catch (error) {
    console.error('Invalid JSON-LD:', error.message, block);
  }
}
在 CI 中,从渲染后的 HTML 提取 script 内容,并将其作为 JSON 解析。这可以在问题进入生产环境之前捕获许多错误。
关键点是:在任何 Schema.org 验证之前先做这件事。如果数据不是有效 JSON,词汇验证器帮不上忙。
第 2 步:检查 JSON-LD 行为,而不只是 JSON 语法
有效的 JSON 并不自动等于有效的 JSON-LD。JSON-LD 使用 @context、@type、@id 和图关系等概念。如果这些内容格式不正确,解析器可能会以不同于你预期的方式解释数据。
至少确认:
- 每个块都有合适的
@context - 主要实体有清晰的
@type值 - 重复实体在有用时使用稳定的
@id值 - 嵌套实体在逻辑上相互连接
- 当可能有多个值时使用数组
对于较大的网站,稳定标识符尤其有帮助。如果你的组织出现在 Article、Product、BreadcrumbList 和 FAQPage 数据中,使用相同的 @id 可以帮助消费者理解这些都是对同一个实体的引用,而不是四个名称相同但互不相关的组织。
典型模式如下:
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "@id": "https://example.com/#organization",
  "name": "Example Ltd",
  "url": "https://example.com/"
}
你在这里不是为了打动验证器。你是在让数据更少产生歧义。
第 3 步:根据 Schema.org 词汇进行验证
当 JSON 和 JSON-LD 结构都可靠之后,再检查词汇。
Schema.org 验证器很有用,因为它是根据 Schema.org 术语进行测试,而不是根据某个搜索引擎的富媒体搜索结果规则。它可以显示属性是否被识别、类型是否按预期被解释,以及你的嵌套结构是否合理。
在这里你可以捕获类似这样的错误:
- 使用
publishingDate而不是datePublished - 在需要
image的地方使用imageUrl - 在并非产品的分类列表页上使用
Product标记 - 没有有意义的被评价对象却使用
AggregateRating - 将
Person用于品牌账号
谨慎对待警告。Schema.org 有意保持灵活。验证器可能允许某个对你的用例并不有用的属性,也可能对某个可选项发出警告。把验证当作证据,而不是裁决。
一个实用规则是:如果某个属性能帮助机器更准确地理解页面,就保留它。如果它存在的唯一原因是有人从代码片段生成器里复制了它,就应该质疑它。
第 4 步:将标记与可见内容进行比较
搜索引擎和其他数据消费者往往不信任与页面不匹配的标记。更重要的是,用户理应获得一致的信息。
对于每种结构化数据类型,都要将标记与可见页面进行比较:
Article and BlogPosting
检查标题、作者、发布日期、修改日期、图片和发布方是否可见或可合理推断。如果你发布 AI 辅助内容,不应使用结构化数据来掩盖不清晰的作者身份。我们另文讨论过小型网站上的诚实 AI 披露应该是什么样,同样的原则也适用于这里:元数据应该澄清,而不是遮蔽。
Product
检查名称、价格、库存状态、货币、变体、评分和评论数量。产品结构化数据尤其容易过期,因为价格和库存状态会在 CMS 之外变化。
LocalBusiness
检查名称、地址、电话号码、营业时间和服务区域。如果你的页脚说的是一回事,而 JSON-LD 说的是另一回事,那么 JSON-LD 并不是“更好”。它是矛盾的。
BreadcrumbList
检查面包屑位置是否与可见的面包屑路径匹配,以及 URL 是否为规范、可抓取,并且没有不必要的重定向。
这不是光鲜的工作。但许多结构化数据问题正是在这里被发现的。
第 5 步:验证渲染后的页面,而不是你的模板
许多网站通过 JavaScript、标签管理器、个性化层或组件 hydration 生成 JSON-LD。这意味着模板文件可能并不代表爬虫或浏览器实际看到的内容。
至少在三种状态下验证渲染后的 HTML:
- 本地开发构建
- staging 或预览 URL
- 生产 URL
使用浏览器 DevTools 检查最终 DOM。搜索 application/ld+json,并复制渲染后实际存在的准确 script 内容。如果服务端渲染标记与 hydration 后的标记不同,就要决定你期望消费者读取哪个版本。
还要检查结构化数据是否被重复输出。当 CMS 插件和自定义组件都生成 schema 时,重复的 Article 或 Product 块很常见。重复并不总是致命,但相互冲突的重复就是问题:两个价格、两个作者、两个发布日期,或两个规范 URL。
这类似于阅读性能和诊断报告:首要任务不是恐慌,而是区分信号与噪音。当你阅读 Lighthouse 报告而不恐慌时,同样的习惯也有帮助——尽管结构化数据本身不应被简化为一个分数。
第 6 步:检查生产环境传输细节
结构化数据在源代码中可能是完美的,但仍然会在生产环境中失败,因为页面并没有按你假设的方式可访问。
检查:
- 最终状态码是
200,而不是软 404 - 规范 URL 与你正在验证的页面匹配
- 重定向是有意且稳定的
- robots 指令不会在预期被索引的地方阻止索引
- HTML 不会针对某些用户代理被错误页面替换
- 缓存页面没有提供过期的 JSON-LD
这就是 HTTP 检查重要的地方。如果一个产品页在到达规范目标之前经过三个 URL 重定向,那么应验证最终页面,而不是从 CMS 复制出来的第一个 URL。关于底层机制,我们的在生产环境中调试重定向和 HTTP 标头的小工具包可以作为有用的参考。
结构化数据并不生活在真空中。它会与标头、重定向、缓存、规范标签和 robots 指令一起传递。
第 7 步:将结构化数据测试加入发布流程
手动验证一个页面没有问题。但它无法扩展到数百或数千个 URL。
一个简单的自动化测试套件可以捕获代价最高的错误:
- 从每种模板类型获取代表性 URL
- 提取所有 JSON-LD 块
- 用
JSON.parse解析它们 - 断言每种页面类型的必需字段
- 检查日期是否为有效的 ISO 8601 字符串
- 检查 URL 是否为绝对且规范
- 检查产品页面是否存在价格和库存状态
- 检查重复实体是否不存在冲突
你可以在 CI 中针对模板运行这些测试,也可以按计划针对生产 URL 运行。目标不是证明每个富媒体搜索结果功能都会出现。搜索引擎之外没有人能承诺这一点。目标是让你自己的数据保持准确、可解析和一致。
<!-- tool-cta:start -->
💡 试试这个: 在验证架构逻辑之前,先将你的 JSON-LD 通过 JSON Formatter 处理,以发现那些否则会破坏所有后续检查的语法错误。
<!-- tool-cta:end -->
标准优先的验证清单
在询问搜索引擎是否喜欢这个页面之前,先使用这份简短清单:
- 每个 JSON-LD 块都是有效 JSON 吗?
- 每个块都包含正确的
@context和@type吗? - Schema.org 属性拼写正确吗?
- 标记是否与可见内容匹配?
- 日期、价格、评分和库存状态是否为最新?
- URL 是否为绝对、规范且可访问?
- 渲染后的生产页面是否就是你测试过的同一个页面?
- 重复实体是否有意存在且不冲突?
如果你能对这些问题回答“是”,你就已经完成了结构化数据工作中持久可靠的部分。之后,面向特定搜索引擎的测试仍然有用,但它应该是最终的兼容性检查,而不是验证流程的基础。
常见问题
我可以完全不使用 Google 来验证结构化数据吗?
有效的 Schema.org 标记是否足以获得富媒体搜索结果?
结构化数据是否总应由服务端渲染?
生产环境中的结构化数据应该多久检查一次?
最常见的结构化数据错误是什么?
来源与进一步阅读