不使用 Google 工具驗證結構化資料的方法
一套實務流程,用來檢查 JSON-LD、Schema.org 詞彙、渲染後的 HTML,以及正式環境行為,而不把 Google 視為唯一真相來源。
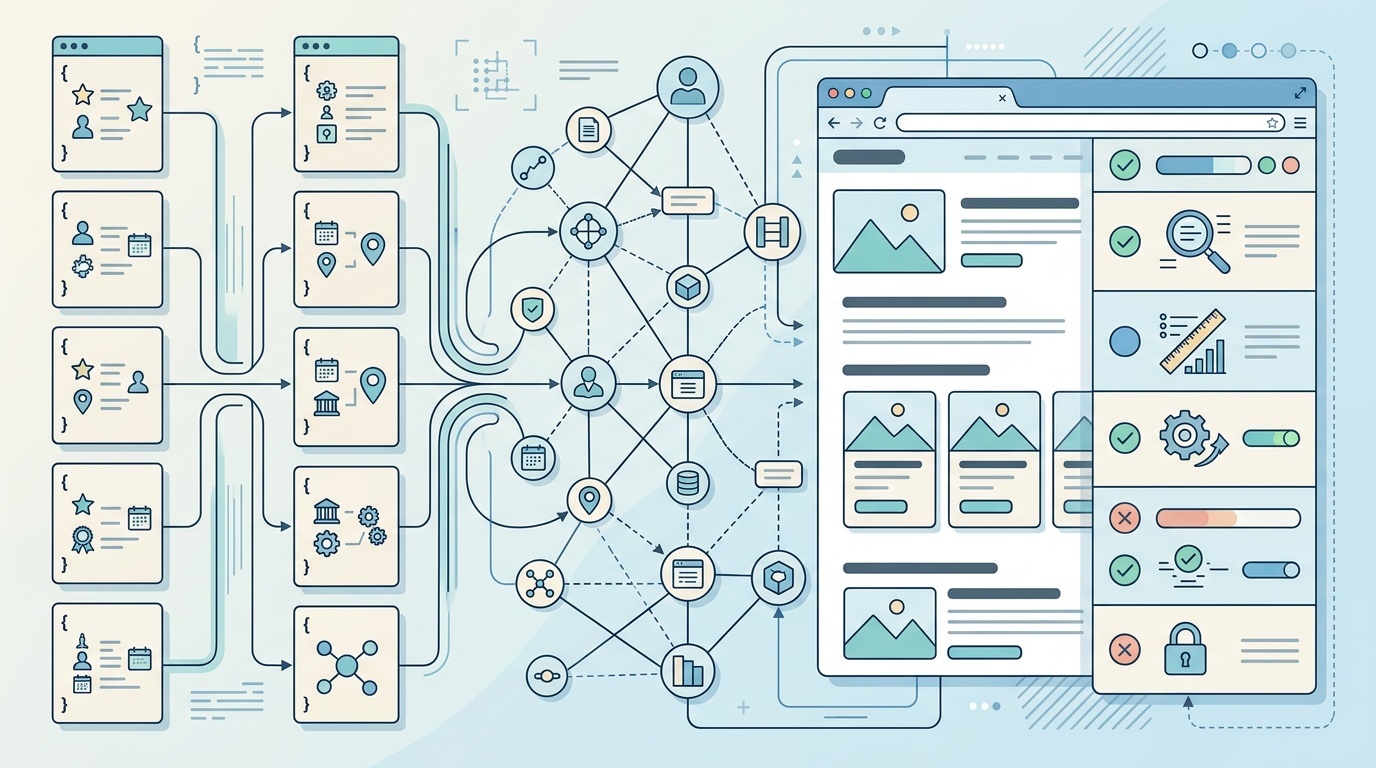
目錄
結構化資料驗證已經變得有些過度依賴面向 Google 的工具。這可以理解:許多團隊加入 JSON-LD,是因為想取得複合式搜尋結果,而 Google 的測試工具也很熟悉。但結構化資料不是 Google 格式。它通常是在 HTML 中嵌入使用 Schema.org 詞彙的 JSON-LD,會被許多消費者解讀,並由你自己的發布流程維護。
如果你只透過搜尋引擎的視角驗證,就可能漏掉基本問題:無效的 JSON、渲染後消失的資料、過期的產品價格、彼此衝突的 canonical URL,或技術上有效但語意上荒謬的標記。
更好的流程是標準優先。先把資料當作資料來驗證,接著驗證詞彙,最後驗證頁面在正式環境中的實際狀態。
你實際上在驗證什麼?
「結構化資料」不是單一事物。在大多數網站上,它有四個層次:
- JSON 語法 — 程式碼能被解析嗎?
- JSON-LD 模型 — 它能展開成有意義的連結資料嗎?
- Schema.org 詞彙 — 類型與屬性合理嗎?
- 頁面層級的真實性 — 標記是否符合使用者與爬蟲能看到的內容?
Google 工具多半聚焦在第四層,加上 Google 特定的複合式搜尋結果資格。很有用,沒錯。但不完整。
例如,下面這段可以是有效的 JSON-LD,但仍然是品質不佳的結構化資料:
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "Best winter jackets",
  "datePublished": "2026-01-12",
  "author": {
    "@type": "Organization",
    "name": "Editorial Team"
  }
}
這裡沒有任何東西壞掉。但如果可見頁面上的標題不同、沒有作者署名,而且最後修改日期與標記互相矛盾,那你面對的是品質問題,而不是語法問題。
Step 1: 在思考 SEO 之前先解析 JSON
從乏味的檢查開始:JSON 能被解析嗎?
嵌入 HTML 的 JSON-LD 經常因為小型模板錯誤而壞掉:
- trailing commas
- 產品名稱中的未跳脫引號
- 字串內的無效換行
- 條件式欄位後缺少大括號
- 版面繼承造成重複的 script 區塊
- CMS 外掛輸出不完整的物件
若是在本機檢查,你不需要 SEO 平台。使用開發堆疊中既有的工具即可。
在 JavaScript 中:
const blocks = [...document.querySelectorAll('script[type="application/ld+json"]')];

for (const block of blocks) {
  try {
    JSON.parse(block.textContent);
  } catch (error) {
    console.error('Invalid JSON-LD:', error.message, block);
  }
}
在 CI 中,從渲染後的 HTML 擷取 script 內容,並將它們當作 JSON 解析。這能在問題進入正式環境前抓到許多錯誤。
重點是:先做這件事,再做任何 Schema.org 驗證。如果資料不是有效的 JSON,詞彙驗證器也幫不上忙。
Step 2: 檢查 JSON-LD 行為,而不只是 JSON 語法
有效的 JSON 不會自動等於有效的 JSON-LD。JSON-LD 使用 @context、@type、@id 與圖譜關係等概念。如果這些格式錯誤,解析器可能會以不同於你預期的方式解讀資料。
至少請確認:
- 每個區塊都有適當的
@context - 主要實體有清楚的
@type值 - 重複出現的實體在有幫助時使用穩定的
@id值 - 巢狀實體在邏輯上有所連結
- 當可能有多個值時使用陣列
對較大型的網站來說,穩定識別碼特別有幫助。如果你的組織出現在 Article、Product、BreadcrumbList 和 FAQPage 資料中,使用相同的 @id 有助於消費者理解它們指向的是同一個實體,而不是四個同名但互不相關的組織。
典型模式如下:
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "@id": "https://example.com/#organization",
  "name": "Example Ltd",
  "url": "https://example.com/"
}
你在這裡不是要取悅驗證器。你是在讓資料更不含糊。
Step 3: 依照 Schema.org 詞彙驗證
一旦 JSON 與 JSON-LD 結構都健全,就檢查詞彙。
Schema.org validator 很有用,因為它是依據 Schema.org 術語測試,而不是依據某個搜尋引擎的複合式搜尋結果規則。它可以顯示屬性是否被辨識、類型是否如預期被解讀,以及你的巢狀結構是否合理。
這是在抓出下列錯誤的地方:
- 使用
publishingDate而不是datePublished - 在預期使用
image的地方使用imageUrl - 在不是產品的分類列表上使用
Product標記 - 沒有有意義受評論項目的
AggregateRating - 對品牌帳號使用
Person
請小心看待警告。Schema.org 是刻意保持彈性的。驗證器可能允許某個對你的使用情境沒有幫助的屬性,也可能對某個選填項目提出警告。把驗證當作證據,而不是判決。
一條實用規則是:如果某個屬性能幫助機器更準確理解頁面,就保留它。如果它存在只是因為有人從 snippet generator 複製過來,就該質疑它。
Step 4: 將標記與可見內容比對
搜尋引擎與其他資料消費者通常不信任與頁面不一致的標記。更重要的是,使用者值得一致性。
針對每一種結構化資料類型,將標記與可見頁面比對:
Article and BlogPosting
確認標題、作者、發布日期、修改日期、圖片與發布者是可見的,或至少可合理推論。如果你發布 AI 輔助內容,結構化資料不應被用來漂白不清楚的作者身分。我們另外寫過小型網站上的誠實 AI 揭露應該是什麼樣子,同樣原則也適用於這裡:metadata 應該用來釐清,而不是遮掩。
Product
檢查名稱、價格、供應狀態、幣別、變體、評分與評論數。產品結構化資料特別容易過期,因為價格與庫存狀態會在 CMS 之外變動。
LocalBusiness
檢查名稱、地址、電話號碼、營業時間與服務區域。如果頁尾說一件事,而 JSON-LD 說另一件事,JSON-LD 並不是「比較好」。它是互相矛盾的。
BreadcrumbList
確認 breadcrumb 位置符合可見的 breadcrumb 路徑,而且 URL 是 canonical、可爬取,且沒有不必要的重新導向。
這不是光鮮亮麗的工作。但許多結構化資料問題也正是在這裡被發現。
Step 5: 驗證渲染後的頁面,而不是你的模板
許多網站透過 JavaScript、tag managers、個人化層,或元件 hydration 產生 JSON-LD。這表示模板檔案可能無法代表爬蟲或瀏覽器實際看到的內容。
至少在三種狀態下驗證渲染後的 HTML:
- 本機開發建置
- staging 或 preview URL
- production URL
使用瀏覽器 DevTools 檢查最終 DOM。搜尋 application/ld+json,並複製渲染後實際存在的精確 script 內容。如果 server-rendered markup 與 hydrated markup 不同,請決定你期望消費者讀取的是哪個版本。
也要檢查結構化資料是否被重複輸出。當 CMS 外掛與自訂元件都輸出 schema 時,重複的 Article 或 Product 區塊很常見。重複不一定致命,但衝突的重複就是問題:兩個價格、兩位作者、兩個發布日期,或兩個 canonical URL。
這和閱讀效能與診斷報告很像:第一個任務不是驚慌,而是區分訊號與雜訊。當你閱讀 Lighthouse report 而不驚慌時,同樣的習慣也有幫助——雖然結構化資料本身不應被簡化成單一分數。
Step 6: 檢查正式環境的傳輸細節
結構化資料在原始碼中可能完美無缺,卻仍然因為頁面無法以你假設的方式被存取,而在正式環境中失敗。
檢查:
- 最終狀態碼是
200,不是 soft 404 - canonical URL 符合你正在驗證的頁面
- redirects 是有意且穩定的
- robots directives 不會在預期可索引時阻擋索引
- HTML 不會對某些 user agents 被替換成錯誤頁
- 快取頁面沒有提供過期的 JSON-LD
這就是 HTTP 檢查很重要的地方。如果產品頁在抵達 canonical 目的地前會經過三個 URL 重新導向,請驗證最終頁面,而不是從 CMS 複製出來的第一個 URL。若要了解底層機制,我們的在正式環境中除錯重新導向與 HTTP headers 的小工具包是有用的搭配閱讀。
結構化資料不是存在於真空中。它會和 headers、redirects、caching、canonical tags 與 robots directives 一起傳遞。
Step 7: 將結構化資料測試加入發布流程
手動驗證一個頁面還可以。但它無法擴展到數百或數千個 URL。
一套簡單的自動化測試可以抓住成本最高的錯誤:
- 從每種模板類型抓取代表性 URL
- 擷取所有 JSON-LD 區塊
- 使用
JSON.parse解析它們 - 針對每種頁面類型斷言必要欄位
- 檢查日期是否為有效的 ISO 8601 字串
- 檢查 URL 是否為絕對 URL 且 canonical
- 檢查產品頁是否有價格與供應狀態
- 檢查重複實體是否沒有衝突
你可以在 CI 中針對模板執行,也可以排程針對正式環境 URL 執行。目標不是證明每個複合式搜尋結果功能都會出現。搜尋引擎之外沒有人能承諾這點。目標是讓你自己的資料保持準確、可解析且一致。
<!-- tool-cta:start -->
💡 試試這個: 在驗證結構描述邏輯之前,先將你的 JSON-LD 透過 JSON Formatter 處理,以找出那些否則會破壞所有後續檢查的語法錯誤。
<!-- tool-cta:end -->
一份標準優先的驗證清單
在詢問搜尋引擎是否喜歡這個頁面之前,先使用這份簡短清單:
- 每個 JSON-LD 區塊都是有效的 JSON 嗎?
- 每個區塊都包含正確的
@context與@type嗎? - Schema.org 屬性拼寫正確嗎?
- 標記符合可見內容嗎?
- 日期、價格、評分與供應狀態是最新的嗎?
- URL 是絕對、canonical 且可到達的嗎?
- 渲染後的正式環境頁面,就是你測試的同一個頁面嗎?
- 重複實體是有意的,且彼此不衝突嗎?
如果你能對這些問題回答是,你就已經完成結構化資料工作中最耐久的部分。搜尋特定測試之後仍然可能有用,但它應該是最後的相容性檢查,而不是驗證流程的基礎。
常見問題
我可以完全不使用 Google 來驗證結構化資料嗎?
有效的 Schema.org 標記足以取得複合式搜尋結果嗎?
結構化資料一定都應該 server-rendered 嗎?
正式環境中的結構化資料應該多久檢查一次?
最常見的結構化資料錯誤是什麼?
來源與進一步閱讀