Как да валидирате структурирани данни без инструменти на Google
Практичен работен процес за проверка на JSON-LD, речника на Schema.org, рендерирания HTML и поведението в продукция, без Google да се приема като единствения източник на истина.
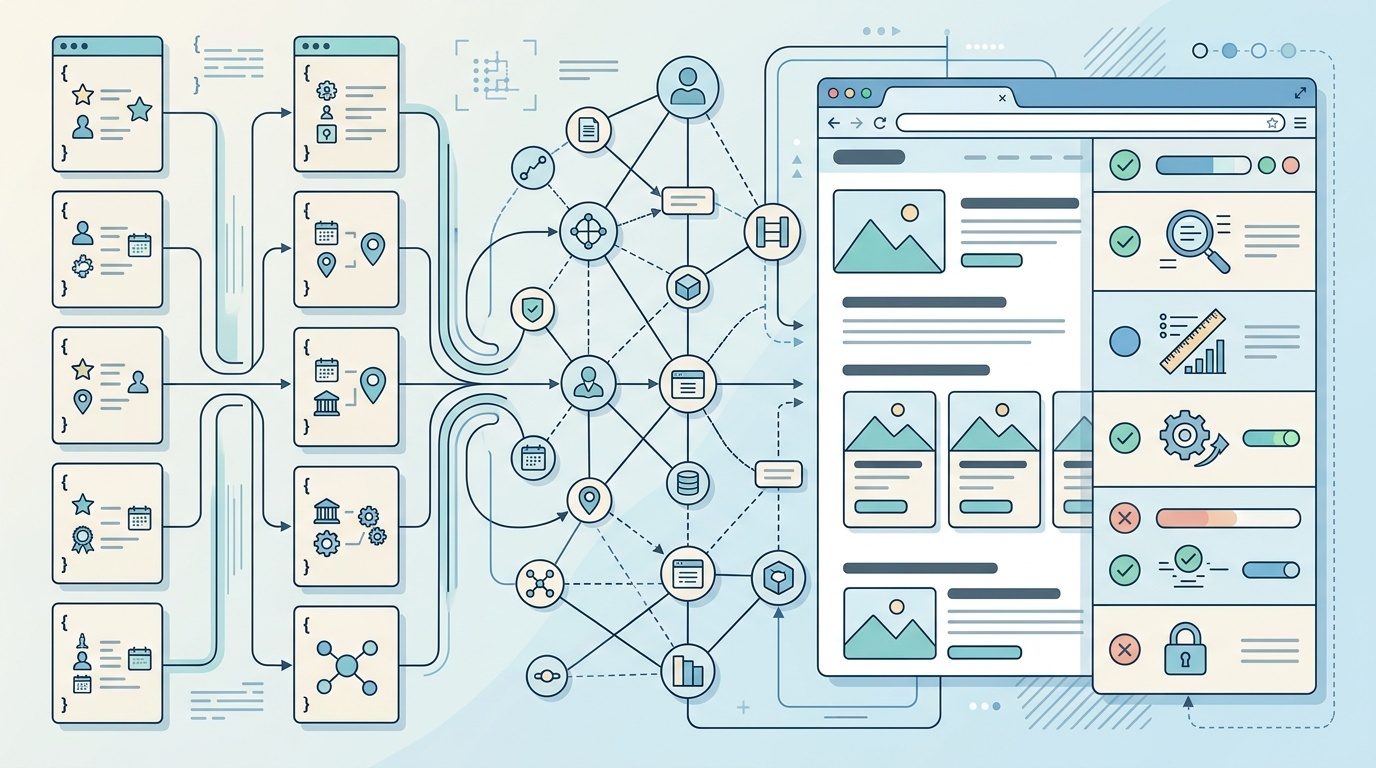
Съдържание
- Какво всъщност валидирате?
- Стъпка 1: Парснете JSON, преди да мислите за SEO
- Стъпка 2: Проверете поведението на JSON-LD, не само JSON синтаксиса
- Стъпка 3: Валидирайте спрямо речника на Schema.org
- Стъпка 4: Сравнете маркирането с видимото съдържание
- Article и BlogPosting
- Product
- LocalBusiness
- BreadcrumbList
- Стъпка 5: Валидирайте рендерираната страница, не шаблона си
- Стъпка 6: Проверете продукционните транспортни детайли
- Стъпка 7: Добавете тестове за структурирани данни към процеса си за release
- Чеклист за валидация, започваща от стандартите
Валидирането на структурирани данни стана странно зависимо от инструменти, насочени към Google. Това е разбираемо: много екипи добавят JSON-LD, защото искат обогатени резултати, а инструментите за тестване на Google са познати. Но структурираните данни не са формат на Google. Обикновено това е JSON-LD с речник Schema.org, вграден в HTML, интерпретиран от много потребители на данни и поддържан от вашия собствен издателски процес.
Ако валидирате само през призмата на търсачка, може да пропуснете основни проблеми: невалиден JSON, данни, които изчезват след рендериране, остарели цени на продукти, конфликтни canonical URL адреси или маркиране, което е технически валидно, но семантично нелепо.
По-добрият работен процес започва от стандартите. Валидирайте данните като данни, след това валидирайте речника и накрая валидирайте страницата така, както съществува в продукция.
Какво всъщност валидирате?
„Структурирани данни“ не е едно-единствено нещо. В повечето уебсайтове те имат четири слоя:
- JSON синтаксис — може ли кодът да бъде парснат?
- JSON-LD модел — разширява ли се до смислени свързани данни?
- Речник Schema.org — правдоподобни ли са типовете и свойствата?
- Истина на ниво страница — съответства ли маркирането на това, което потребителите и crawler-ите могат да видят?
Инструментите на Google се фокусират най-вече върху четвъртия слой плюс специфичната за Google допустимост за обогатени резултати. Полезно — да. Пълно — не.
Например това може да е валиден JSON-LD и въпреки това да е слаб пример за структурирани данни:
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "Best winter jackets",
  "datePublished": "2026-01-12",
  "author": {
    "@type": "Organization",
    "name": "Editorial Team"
  }
}
Тук няма нищо счупено. Но ако видимата страница има различно заглавие, няма посочен автор и датата на последна промяна противоречи на маркирането, имате проблем с качеството, а не със синтаксиса.
Стъпка 1: Парснете JSON, преди да мислите за SEO
Започнете със скучната проверка: може ли JSON да бъде парснат?
JSON-LD, вграден в HTML, често се чупи заради малки грешки в шаблоните:
- запетаи в края
- неескейпнати кавички в имена на продукти
- невалидни нови редове вътре в низове
- липсващи скоби след условни полета
- дублирани script блокове от наследяване на layout
- CMS плъгини, които извеждат частични обекти
За локални проверки не ви е нужна SEO платформа. Използвайте инструментите, които вече са във вашия development stack.
В JavaScript:
const blocks = [...document.querySelectorAll('script[type="application/ld+json"]')];

for (const block of blocks) {
  try {
    JSON.parse(block.textContent);
  } catch (error) {
    console.error('Invalid JSON-LD:', error.message, block);
  }
}
В CI извличайте съдържанието на script елементите от рендерирания HTML и го парсвайте като JSON. Това улавя много проблеми, преди да стигнат до продукция.
Важното: направете това преди каквато и да е Schema.org валидация. Валидатор на речник не може да помогне, ако данните не са валиден JSON.
Стъпка 2: Проверете поведението на JSON-LD, не само JSON синтаксиса
Валиден JSON не означава автоматично валиден JSON-LD. JSON-LD използва понятия като @context, @type, @id и връзки в граф. Ако те са неправилно оформени, парсърите може да интерпретират данните ви различно от намерението ви.
Като минимум потвърдете, че:
- всеки блок има подходящ
@context - основните обекти имат ясни стойности за
@type - повтарящите се обекти използват стабилни стойности за
@id, когато е полезно - вложените обекти са свързани логично
- използват се масиви, когато са възможни множество стойности
За по-големи сайтове стабилните идентификатори са особено полезни. Ако вашата организация се появява в данни за Article, Product, BreadcrumbList и FAQPage, използването на същия @id помага на потребителите на данни да разберат, че това са препратки към един и същ обект, а не четири несвързани организации със същото име.
Типичният модел изглежда така:
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "@id": "https://example.com/#organization",
  "name": "Example Ltd",
  "url": "https://example.com/"
}
Тук не се опитвате да впечатлите валидатор. Правите данните си по-малко двусмислени.
Стъпка 3: Валидирайте спрямо речника на Schema.org
След като JSON и JSON-LD структурата са изрядни, проверете речника.
Валидаторът на Schema.org е полезен, защото тества спрямо термините на Schema.org, а не спрямо правилата за обогатени резултати на една търсачка. Той може да покаже дали свойствата са разпознати, дали типовете се интерпретират според очакванията и дали вложените ви структури имат смисъл.
Тук улавяте грешки като:
publishingDateвместоdatePublishedimageUrl, когато се очакваimage- маркиране
Productвърху списък с категории, който не е продукт AggregateRatingбез смислен оценяван обектPerson, използван за бранд акаунт
Бъдете внимателни с предупрежденията. Schema.org умишлено е гъвкав. Валидаторът може да позволи свойство, което не е полезно за вашия случай, или да предупреди за нещо, което е незадължително. Приемайте валидацията като доказателство, не като присъда.
Практично правило: ако дадено свойство помага на машина да разбере страницата по-точно, запазете го. Ако съществува само защото някой го е копирал от генератор на snippets, поставете го под въпрос.
Стъпка 4: Сравнете маркирането с видимото съдържание
Търсачките и другите потребители на данни обикновено не се доверяват на маркиране, което не съответства на страницата. Още по-важно: потребителите заслужават последователност.
За всеки тип структурирани данни сравнете маркирането с видимата страница:
Article и BlogPosting
Проверете дали заглавието, авторът, датата на публикуване, датата на промяна, изображението и издателят са видими или разумно подразбиращи се. Ако публикувате съдържание, подпомогнато от AI, структурираните ви данни не бива да се използват за прикриване на неясно авторство. Писали сме отделно за честното разкриване на AI на малък уебсайт, и тук важи същият принцип: метаданните трябва да изясняват, а не да замъгляват.
Product
Проверете име, цена, наличност, валута, варианти, оценки и брой отзиви. Структурираните данни за продукти са особено склонни да остаряват, защото цените и наличностите се променят извън CMS.
LocalBusiness
Проверете име, адрес, телефонен номер, работно време и обслужван район. Ако footer-ът ви казва едно, а JSON-LD казва друго, JSON-LD не е „по-добър“. Той е противоречив.
BreadcrumbList
Проверете дали позициите в breadcrumb навигацията съответстват на видимата breadcrumb пътека и дали URL адресите са canonical, crawlable и не се пренасочват излишно.
Това не е бляскава работа. Но именно тук се откриват много от проблемите със структурирани данни.
Стъпка 5: Валидирайте рендерираната страница, не шаблона си
Много сайтове генерират JSON-LD чрез JavaScript, мениджъри на тагове, слоеве за персонализация или хидратация на компоненти. Това означава, че файлът на шаблона може да не представя това, което crawler или браузър реално вижда.
Валидирайте рендерирания HTML поне в три състояния:
- локален development build
- staging или preview URL
- production URL
Използвайте browser DevTools, за да инспектирате финалния DOM. Потърсете application/ld+json и копирайте точното съдържание на script елемента, което съществува след рендериране. Ако server-rendered маркирането се различава от hydrated маркирането, решете коя версия очаквате потребителите на данни да прочетат.
Проверете също дали структурираните данни не се дублират. Дублирани блокове Article или Product са често срещани, когато CMS плъгин и custom компонент едновременно извеждат schema. Дублирането не винаги е фатално, но конфликтното дублиране е проблем: две цени, двама автори, две дати на публикуване или два canonical URL адреса.
Това прилича на четене на отчети за производителност и диагностика: първата задача не е да изпаднете в паника, а да отделите сигнала от шума. Същият навик помага, когато четете Lighthouse report without panicking — макар че самите структурирани данни не бива да се свеждат до единичен резултат.
Стъпка 6: Проверете продукционните транспортни детайли
Структурираните данни може да са перфектни в source-а ви и пак да се провалят в продукция, защото страницата не е достъпна по начина, който предполагате.
Проверете:
- финалният status code е
200, а не soft 404 - canonical URL съответства на страницата, която валидирате
- пренасочванията са умишлени и стабилни
- robots директивите не блокират индексиране там, където се очаква индексиране
- HTML не се заменя със страница за грешка за някои user agents
- кешираните страници не сервират остарял JSON-LD
Тук HTTP инспекцията има значение. Ако продуктова страница се пренасочва през три URL адреса, преди да достигне canonical дестинация, валидирайте финалната страница, а не първия URL, копиран от CMS. За суровата механика нашето ръководство за debugging redirects and HTTP headers in production е полезен спътник.
Структурираните данни не живеят във вакуум. Те пътуват с headers, redirects, caching, canonical tags и robots directives.
Стъпка 7: Добавете тестове за структурирани данни към процеса си за release
Ръчната валидация е добра за една страница. Тя не се мащабира за стотици или хиляди URL адреси.
Прост автоматизиран test suite може да улови най-скъпите грешки:
- fetch на представителни URL адреси от всеки тип шаблон
- извличане на всички JSON-LD блокове
- парсване с
JSON.parse - assert на задължителните полета за всеки тип страница
- проверка, че датите са валидни ISO 8601 низове
- проверка, че URL адресите са абсолютни и canonical
- проверка, че цени и наличност съществуват за продуктови страници
- проверка, че дублирани обекти не си противоречат
Можете да изпълнявате това в CI за шаблони и по график за production URL адреси. Целта не е да докажете, че всяка функция за обогатени резултати ще се появи. Никой извън търсачката не може да обещае това. Целта е да поддържате собствените си данни точни, парсируеми и последователни.
<!-- tool-cta:start -->
💡 Опитайте това: Преди да валидирате логиката на схемата, прекарайте своя JSON-LD през JSON Formatter, за да откриете синтактични грешки, които иначе биха нарушили всяка последваща проверка.
<!-- tool-cta:end -->
Чеклист за валидация, започваща от стандартите
Използвайте този кратък чеклист, преди да питате дали търсачката харесва страницата:
- Всеки JSON-LD блок валиден JSON ли е?
- Всеки блок включва ли правилните
@contextи@type? - Изписани ли са правилно свойствата на Schema.org?
- Съответства ли маркирането на видимото съдържание?
- Актуални ли са датите, цените, оценките и наличностите?
- Абсолютни, canonical и достъпни ли са URL адресите?
- Рендерираната production страница същата страница ли е, която сте тествали?
- Дублираните обекти умишлени ли са и без конфликти?
Ако можете да отговорите с „да“ на тези въпроси, сте свършили устойчивата част от работата със структурирани данни. Специфичното за търсачки тестване все още може да е полезно по-късно, но то трябва да бъде финалната проверка за съвместимост, а не основата на процеса ви за валидация.
Често задавани въпроси
Мога ли да валидирам структурирани данни, без изобщо да използвам Google?
Достатъчно ли е валидно Schema.org маркиране, за да се получат обогатени резултати?
Трябва ли структурираните данни винаги да са server-rendered?
Колко често трябва да се проверяват продукционните структурирани данни?
Коя е най-честата грешка при структурирани данни?
Източници и допълнително четене