Cara mengesahkan data berstruktur tanpa alat Google
Aliran kerja praktikal untuk menyemak JSON-LD, perbendaharaan kata Schema.org, HTML yang dirender, dan tingkah laku produksi tanpa menganggap Google sebagai satu-satunya sumber kebenaran.
Jadual kandungan
- Apakah yang sebenarnya anda sahkan?
- Langkah 1: Huraikan JSON sebelum memikirkan SEO
- Langkah 2: Semak tingkah laku JSON-LD, bukan hanya sintaks JSON
- Langkah 3: Sahkan terhadap perbendaharaan kata Schema.org
- Langkah 4: Bandingkan markup dengan kandungan yang kelihatan
- Article dan BlogPosting
- Product
- LocalBusiness
- BreadcrumbList
- Langkah 5: Sahkan halaman yang dirender, bukan templat anda
- Langkah 6: Semak butiran penghantaran produksi
- Langkah 7: Tambahkan ujian data berstruktur pada proses keluaran anda
- Senarai semak pengesahan berpaksikan piawaian
Pengesahan data berstruktur telah menjadi agak bergantung pada alat yang menghadap Google. Itu boleh difahami: banyak pasukan menambah JSON-LD kerana mereka mahukan hasil kaya, dan alat ujian Google memang biasa digunakan. Tetapi data berstruktur bukan format Google. Biasanya ia ialah JSON-LD yang menggunakan perbendaharaan kata Schema.org, dibenamkan dalam HTML, ditafsir oleh banyak pengguna data, dan diselenggara oleh aliran kerja penerbitan anda sendiri.
Jika anda hanya mengesahkan melalui lensa enjin carian, anda boleh terlepas masalah asas: JSON tidak sah, data yang hilang selepas rendering, harga produk yang lapuk, URL kanonik yang bercanggah, atau markup yang sah secara teknikal tetapi tidak masuk akal secara semantik.
Aliran kerja yang lebih baik ialah berpaksikan piawaian. Sahkan data sebagai data, kemudian sahkan perbendaharaan kata, kemudian sahkan halaman sebagaimana ia wujud dalam produksi.
Apakah yang sebenarnya anda sahkan?
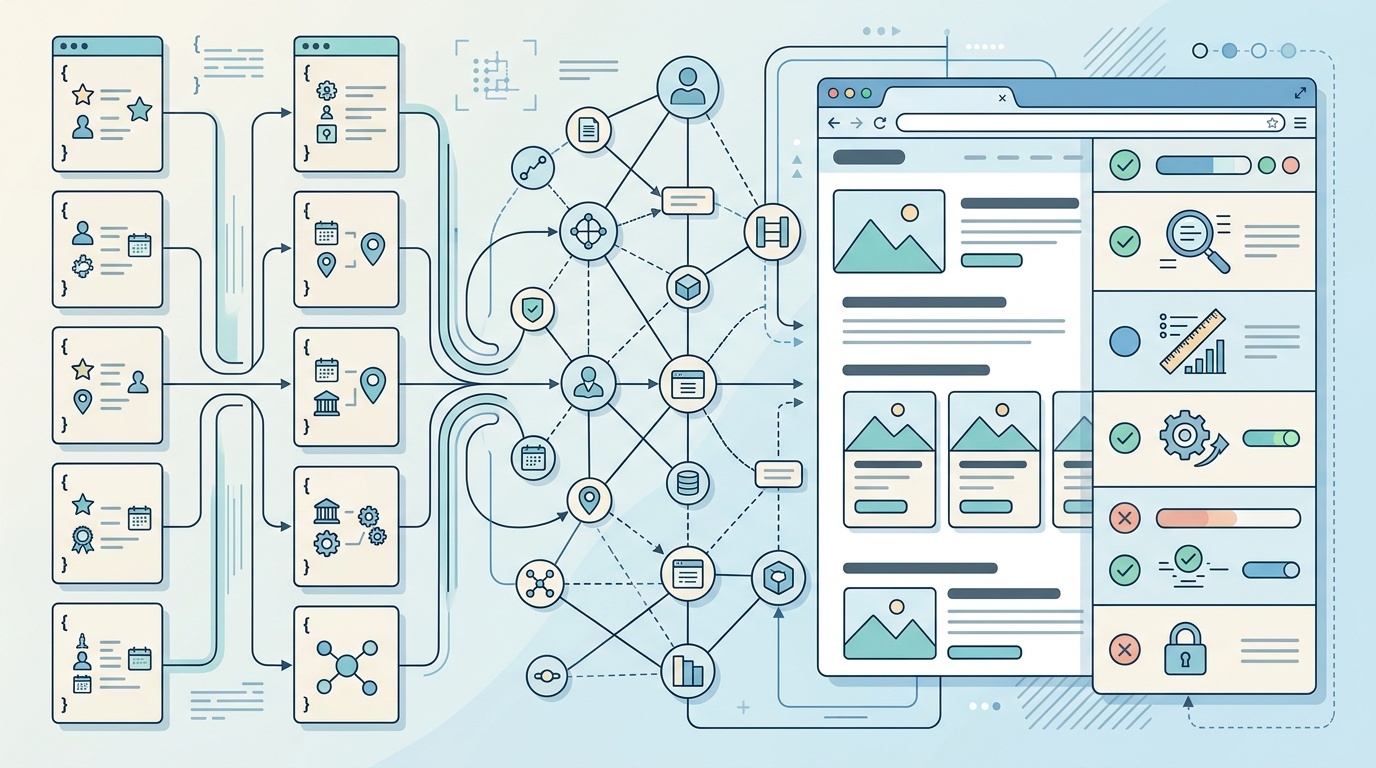
“Data berstruktur” bukan satu perkara sahaja. Pada kebanyakan laman web, ia mempunyai empat lapisan:
- Sintaks JSON — adakah kod boleh dihuraikan?
- Model JSON-LD — adakah ia berkembang menjadi data terpaut yang bermakna?
- Perbendaharaan kata Schema.org — adakah jenis dan sifatnya munasabah?
- Kebenaran peringkat halaman — adakah markup sepadan dengan perkara yang boleh dilihat oleh pengguna dan perangkak?
Alat Google kebanyakannya menumpukan pada lapisan keempat serta kelayakan hasil kaya khusus Google. Berguna, ya. Lengkap, tidak.
Sebagai contoh, ini boleh menjadi JSON-LD yang sah dan masih merupakan data berstruktur yang lemah:
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "Best winter jackets",
  "datePublished": "2026-01-12",
  "author": {
    "@type": "Organization",
    "name": "Editorial Team"
  }
}
Tiada apa-apa yang rosak di sini. Tetapi jika halaman yang kelihatan mempunyai tajuk yang berbeza, tiada atribusi pengarang, dan tarikh terakhir diubah suai yang bercanggah dengan markup, anda mempunyai masalah kualiti dan bukannya masalah sintaks.
Langkah 1: Huraikan JSON sebelum memikirkan SEO
Mulakan dengan semakan yang membosankan: bolehkah JSON dihuraikan?
JSON-LD yang dibenamkan dalam HTML sering rosak kerana kesilapan kecil dalam templat:
- koma berlebihan di hujung
- tanda petik yang tidak di-escape dalam nama produk
- pemisah baris tidak sah di dalam rentetan
- kurungan pendakap yang hilang selepas medan bersyarat
- blok skrip pendua daripada pewarisan reka letak
- plugin CMS yang mengeluarkan objek separa
Untuk semakan setempat, anda tidak memerlukan platform SEO. Gunakan alat yang sudah ada dalam stack pembangunan anda.
Dalam JavaScript:
const blocks = [...document.querySelectorAll('script[type="application/ld+json"]')];

for (const block of blocks) {
  try {
    JSON.parse(block.textContent);
  } catch (error) {
    console.error('Invalid JSON-LD:', error.message, block);
  }
}
Dalam CI, ekstrak kandungan skrip daripada HTML yang dirender dan huraikannya sebagai JSON. Ini menangkap banyak masalah sebelum ia sampai ke produksi.
Perkara penting: lakukan ini sebelum sebarang pengesahan Schema.org. Pengesah perbendaharaan kata tidak dapat membantu jika data bukan JSON yang sah.
Langkah 2: Semak tingkah laku JSON-LD, bukan hanya sintaks JSON
JSON yang sah tidak semestinya JSON-LD yang sah. JSON-LD menggunakan konsep seperti @context, @type, @id, dan hubungan graf. Jika ini dibentuk dengan salah, parser mungkin mentafsir data anda secara berbeza daripada yang anda maksudkan.
Sekurang-kurangnya, sahkan bahawa:
- setiap blok mempunyai
@contextyang sesuai - entiti utama mempunyai nilai
@typeyang jelas - entiti berulang menggunakan nilai
@idyang stabil apabila berguna - entiti bersarang disambungkan secara logik
- tatasusunan digunakan apabila berbilang nilai mungkin wujud
Untuk laman yang lebih besar, pengecam stabil amat membantu. Jika organisasi anda muncul dalam data Article, Product, BreadcrumbList, dan FAQPage, penggunaan @id yang sama membantu pengguna data memahami bahawa ini ialah rujukan kepada entiti yang sama, bukan empat organisasi tidak berkaitan dengan nama yang sama.
Corak lazim kelihatan seperti ini:
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "@id": "https://example.com/#organization",
  "name": "Example Ltd",
  "url": "https://example.com/"
}
Anda tidak cuba menarik perhatian pengesah di sini. Anda sedang menjadikan data anda kurang kabur.
Langkah 3: Sahkan terhadap perbendaharaan kata Schema.org
Selepas struktur JSON dan JSON-LD kukuh, semak perbendaharaan katanya.
Pengesah Schema.org berguna kerana ia menguji berdasarkan istilah Schema.org dan bukannya peraturan hasil kaya satu enjin carian. Ia boleh menunjukkan sama ada sifat dikenali, sama ada jenis ditafsir seperti yang dijangka, dan sama ada struktur bersarang anda masuk akal.
Di sinilah anda menangkap kesilapan seperti:
publishingDatedan bukannyadatePublishedimageUrlapabilaimagedijangka- markup
Productpada senarai kategori yang bukan produk AggregateRatingtanpa item yang disemak secara bermaknaPersondigunakan untuk akaun jenama
Berhati-hati dengan amaran. Schema.org sengaja fleksibel. Pengesah mungkin membenarkan sifat yang tidak berguna untuk kes penggunaan anda, atau memberi amaran tentang sesuatu yang bersifat pilihan. Anggap pengesahan sebagai bukti, bukan keputusan muktamad.
Peraturan praktikal: jika sesuatu sifat membantu mesin memahami halaman dengan lebih tepat, kekalkan. Jika ia wujud hanya kerana seseorang menyalinnya daripada penjana snippet, persoalkannya.
Langkah 4: Bandingkan markup dengan kandungan yang kelihatan
Enjin carian dan pengguna data lain cenderung tidak mempercayai markup yang tidak sepadan dengan halaman. Lebih penting lagi, pengguna berhak mendapat konsistensi.
Untuk setiap jenis data berstruktur, bandingkan markup dengan halaman yang kelihatan:
Article dan BlogPosting
Semak bahawa tajuk, pengarang, tarikh diterbitkan, tarikh diubah suai, imej, dan penerbit kelihatan atau boleh disimpulkan secara munasabah. Jika anda menerbitkan kandungan berbantu AI, data berstruktur anda tidak sepatutnya digunakan untuk mengaburkan kepengarangan yang tidak jelas. Kami telah menulis secara berasingan tentang pendedahan AI yang jujur di laman web kecil, dan prinsip yang sama terpakai di sini: metadata harus menjelaskan, bukan mengaburkan.
Product
Semak nama, harga, ketersediaan, mata wang, varian, penarafan, dan kiraan ulasan. Data berstruktur produk sangat mudah menjadi lapuk kerana harga dan status stok berubah di luar CMS.
LocalBusiness
Semak nama, alamat, nombor telefon, waktu operasi, dan kawasan perkhidmatan. Jika footer anda menyatakan satu perkara dan JSON-LD anda menyatakan perkara lain, JSON-LD itu bukan “lebih baik”. Ia bercanggah.
BreadcrumbList
Semak bahawa kedudukan breadcrumb sepadan dengan jejak breadcrumb yang kelihatan dan bahawa URL adalah kanonik, boleh dirangkak, dan tidak dialihkan tanpa keperluan.
Ini bukan kerja yang glamor. Ini juga tempat banyak masalah data berstruktur ditemui.
Langkah 5: Sahkan halaman yang dirender, bukan templat anda
Banyak laman menjana JSON-LD melalui JavaScript, tag manager, lapisan personalisasi, atau hydration komponen. Ini bermakna fail templat mungkin tidak mewakili perkara yang sebenarnya dilihat oleh perangkak atau pelayar.
Sahkan HTML yang dirender dalam sekurang-kurangnya tiga keadaan:
- binaan pembangunan setempat
- URL staging atau pratonton
- URL produksi
Gunakan DevTools pelayar untuk memeriksa DOM akhir. Cari application/ld+json dan salin kandungan skrip tepat yang wujud selepas rendering. Jika markup yang dirender pelayan berbeza daripada markup yang di-hydrate, tentukan versi mana yang anda jangka akan dibaca oleh pengguna data.
Semak juga sama ada data berstruktur diduplikasi. Blok Article atau Product pendua lazim berlaku apabila plugin CMS dan komponen tersuai kedua-duanya mengeluarkan schema. Penduaan tidak sentiasa membawa padah, tetapi penduaan yang bercanggah ialah masalah: dua harga, dua pengarang, dua tarikh penerbitan, atau dua URL kanonik.
Ini serupa dengan membaca laporan prestasi dan diagnostik: tugas pertama bukan untuk panik, tetapi untuk memisahkan isyarat daripada hingar. Tabiat yang sama membantu apabila anda membaca laporan Lighthouse tanpa panik — walaupun data berstruktur itu sendiri tidak patut dipermudahkan kepada satu skor.
Langkah 6: Semak butiran penghantaran produksi
Data berstruktur boleh sempurna dalam sumber anda dan masih gagal dalam produksi kerana halaman tidak boleh diakses dengan cara yang anda andaikan.
Semak:
- kod status akhir ialah
200, bukan soft 404 - URL kanonik sepadan dengan halaman yang anda sahkan
- redirect adalah disengajakan dan stabil
- arahan robots tidak menyekat pengindeksan apabila pengindeksan dijangka
- HTML tidak digantikan oleh halaman ralat untuk sesetengah user agent
- halaman cache tidak menyajikan JSON-LD yang lapuk
Di sinilah pemeriksaan HTTP penting. Jika halaman produk melalui redirect merentasi tiga URL sebelum sampai ke destinasi kanonik, sahkan halaman akhir, bukan URL pertama yang disalin daripada CMS. Untuk mekanik mentahnya, panduan kami tentang menyahpepijat redirect dan header HTTP dalam produksi ialah rujukan pendamping yang berguna.
Data berstruktur tidak wujud dalam vakum. Ia bergerak bersama header, redirect, caching, tag kanonik, dan arahan robots.
Langkah 7: Tambahkan ujian data berstruktur pada proses keluaran anda
Pengesahan manual memadai untuk satu halaman. Ia tidak berskala merentasi ratusan atau ribuan URL.
Suit ujian automatik yang ringkas boleh menangkap kesilapan paling mahal:
- ambil URL wakil daripada setiap jenis templat
- ekstrak semua blok JSON-LD
- huraikannya dengan
JSON.parse - sahkan medan wajib untuk setiap jenis halaman
- semak bahawa tarikh ialah rentetan ISO 8601 yang sah
- semak bahawa URL adalah mutlak dan kanonik
- semak bahawa harga dan ketersediaan wujud untuk halaman produk
- semak bahawa entiti pendua tidak bercanggah
Anda boleh menjalankannya dalam CI untuk templat dan mengikut jadual untuk URL produksi. Matlamatnya bukan untuk membuktikan bahawa setiap ciri hasil kaya akan muncul. Tiada sesiapa di luar enjin carian boleh menjanjikannya. Matlamatnya ialah memastikan data anda sendiri tepat, boleh dihuraikan, dan konsisten.
<!-- tool-cta:start -->
💡 Cuba ini: Sebelum mengesahkan logik skema, jalankan JSON-LD anda melalui JSON Formatter untuk mengesan ralat sintaks yang jika tidak akan merosakkan setiap semakan seterusnya.
<!-- tool-cta:end -->
Senarai semak pengesahan berpaksikan piawaian
Gunakan senarai semak ringkas ini sebelum bertanya sama ada enjin carian menyukai halaman tersebut:
- Adakah setiap blok JSON-LD merupakan JSON yang sah?
- Adakah setiap blok menyertakan
@contextdan@typeyang betul? - Adakah sifat Schema.org dieja dengan betul?
- Adakah markup sepadan dengan kandungan yang kelihatan?
- Adakah tarikh, harga, penarafan, dan ketersediaan terkini?
- Adakah URL mutlak, kanonik, dan boleh dicapai?
- Adakah halaman produksi yang dirender sama dengan halaman yang anda uji?
- Adakah entiti pendua disengajakan dan tidak bercanggah?
Jika anda boleh menjawab ya kepada soalan-soalan itu, anda telah melakukan bahagian kerja data berstruktur yang tahan lama. Ujian khusus carian masih boleh berguna kemudian, tetapi ia sepatutnya menjadi semakan keserasian terakhir, bukan asas proses pengesahan anda.
Soalan yang sering ditanya
Bolehkah saya mengesahkan data berstruktur tanpa menggunakan Google langsung?
Adakah markup Schema.org yang sah mencukupi untuk memperoleh hasil kaya?
Patutkah data berstruktur sentiasa dirender pada pelayan?
Berapa kerap data berstruktur produksi patut disemak?
Apakah kesilapan data berstruktur yang paling lazim?
Sumber & bacaan lanjut