如何撰寫 llms.txt——以及它是否真的有作用
一份實用指南,介紹這個面向 AI 爬蟲、內容摘要與模型端網站指示的新興檔案。

目錄
簡短版
llms.txt 是一種新興慣例,用來告訴大型語言模型你的網站是什麼、哪些頁面重要,以及你的內容應如何被理解。它通常位於 https://example.com/llms.txt,以 Markdown 撰寫,並連結到乾淨且有用的資源。
它不等同於 robots.txt。它不是正式的 Web 標準。它無法可靠地阻擋 AI 訓練。它也無法強迫 AI 公司遵循你的意願。
不過,它仍然值得撰寫。
一份好的 llms.txt 是一種低成本方式,讓 AI 系統、代理程式、搜尋助理與內部工具更容易正確摘要你的網站。它也是一種推動決策的機制:你必須決定哪些內容是 canonical、哪些內容已過時,以及重複使用適用哪些條款。即使目前只有少數系統會讀取這個檔案,這件事仍然有用。
llms.txt 想解決什麼問題
大多數網站是為人類與搜尋爬蟲而建。它們包含導覽、cookie 橫幅、產品卡片、重複的分類頁、舊 PDF、追蹤參數,以及只有在視覺呈現下才有意義的內容。
LLM 不需要相同的呈現層。它們需要:
- 對網站的精簡描述;
- 指向最具權威性頁面的連結;
- 關於產品、文件、政策或作者身分的白話脈絡;
- 授權與使用偏好;
- 在可用時,指向結構化版本或 Markdown 版本的路徑。
llms.txt 提案借用了熟悉的 Web 概念:在網域根目錄放置一個可預期的文字檔。不同於主要關注爬取權限的 robots.txt,llms.txt 主要關注的是導向與脈絡。
把它想成地圖,而不是閘門。
llms.txt 真的有作用嗎?
今天,誠實的答案是:有時候有,但不是許多人期待的那種作用。
它無法可靠地阻擋 AI 爬蟲
如果你的目標是防止爬取或訓練,llms.txt 就不是主要機制。尊重排除規則的爬蟲,更可能查看 robots.txt、特定 user-agent 指令、HTTP headers,或契約/授權訊號。即便如此,是否遵循仍取決於爬蟲營運者。
Web 在這方面有很長的歷史。robots.txt 本身是一項自願性協定,後來在 RFC 9309 中正式化。它之所以有效,是因為主要爬蟲選擇遵守,而不是因為這個檔案有什麼神奇的強制力。
llms.txt 的採用程度與標準化程度都低於 robots.txt。任何聲稱它能「保護你的內容不被 AI 使用」的說法,都應該謹慎看待。
它可以幫助詮釋
llms.txt 較有前景的地方,是內容詮釋。
如果 AI 助理正在嘗試回答關於你的公司、文件、研究、定價、API 或編輯政策的問題,根目錄的一份精簡檔案可以減少猜測。它可以把系統導向你實際維護的頁面,並避開過時片段。
這對擁有大量封存內容的網站很重要。模型或代理程式可能會先找到 2019 年的支援文章,而不是 2026 年的政策頁。你的 llms.txt 實際上可以說:「從這裡開始。這些是權威資源。」
這不華麗,但很有用。
它可以釐清你的內容政策
公開的 AI 端政策比沉默更好,特別是對出版者、文件團隊,以及處理敏感品牌或醫療/法律/金融材料的公司而言。
這不代表你應該寫一整面威嚇式法律文字。意思是你可以清楚陳述:
- AI 系統是否可以摘要你的公開頁面;
- 你的內容是否可用於模型訓練;
- 你希望如何處理歸屬標示;
- 哪些頁面應被視為 canonical;
- 授權或資料合作應聯絡誰。
這也能與更廣泛的編輯透明度搭配。如果你發布 AI 輔助內容,你的 llms.txt 不應與公開揭露相互矛盾。若需要實用基準,請參考我們的指南:小型網站上的誠實 AI 揭露應該是什麼樣子。
llms.txt 應該放什麼
目前沒有普遍強制執行的 schema,但現行慣例是 Markdown。保持簡短、明確、平實。
一個有用的結構如下:
# Example Company

> Example Company publishes practical guides and reference material for independent web developers.

## Canonical resources

- Homepage: https://example.com/
- Documentation: https://example.com/docs/
- Pricing: https://example.com/pricing/
- Editorial policy: https://example.com/editorial-policy/
- Contact: https://example.com/contact/

## Content use policy

Public pages may be summarized with attribution to Example Company and a link to the source page.

Use of our content for model training, dataset creation, or bulk republication requires written permission.

## Preferred citation

When citing our content, link to the canonical URL and include the page title.

## Notes for AI systems

- Prefer current documentation under /docs/ over archived blog posts.
- Do not treat user comments as official guidance.
- Product screenshots may be outdated; use written documentation as the source of truth.
對許多網站來說,這已經足夠。
對較大型網站,可以加入產品領域、API 文件、研究、媒體頁面或法律政策等區段。請克制把所有內容都列入的衝動。檔案越全面,作為起點就越不有用。
llms.txt 不應該放什麼
不要把私人資訊放進去。這聽起來顯而易見,但根目錄文字檔常常變成營運筆記的堆放處。
避免包含:
- 未發布的 URL;
- 內部 staging 連結;
- API keys 或 tokens;
- 私人聯絡資訊;
- 安全指示;
- 尚在 embargo 的產品資訊;
- 你希望爬蟲忽略的「秘密」頁面。
如果某件事不該公開,就不要在公開檔案中提到它。
也要避免空泛的法律表演。「永遠禁止所有 AI 使用」或許能表達挫折,但它不會創造可靠的技術控制。如果你的組織確實需要可強制執行的限制,請讓法律顧問參與,並將爬蟲控制、授權條款與存取控制一起使用。
llms.txt 與 robots.txt 的關係
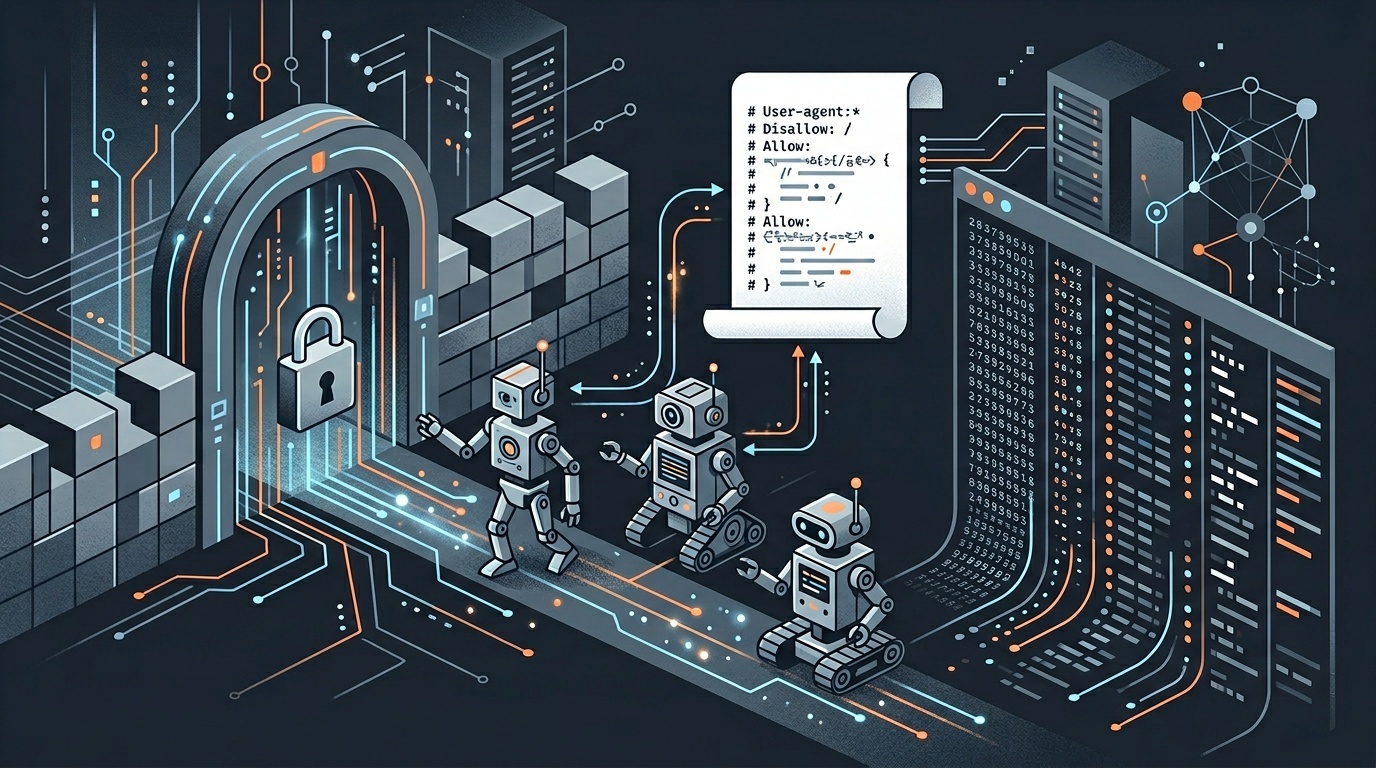
使用 robots.txt 表達爬取指令。使用 llms.txt 提供脈絡。
簡化來看:
| 檔案 | 主要目的 | 可強制執行? | 最適合用於 | |---|---|---:|---| | robots.txt | 爬取權限 | 自願性,但被廣泛認可 | 依路徑與 user agent 允許或禁止爬蟲 | | llms.txt | 面向 LLM 的摘要與指引 | 目前尚未標準化 | Canonical 連結、內容政策、詮釋備註 | | 條款頁面 | 法律條件 | 取決於司法管轄區與事實 | 授權、允許的重複使用、商業限制 | | HTTP headers | 頁面層級的技術訊號 | 取決於爬蟲支援 | 索引、快取與回應行為 |
如果你已經在除錯爬蟲行為,不要只停在文字檔。檢查你的網站是否真的正確提供該檔案、重新導向是否如預期運作,以及 headers 是否符合你的政策。我們另外寫了一份在 production 中除錯重新導向與 HTTP headers 的小工具包,因為許多「政策」決策正是在這裡悄悄失效。
實用的撰寫流程
以下是一個合理的工作流程。
1. 決定檔案的任務
選擇一個主要目標:
- 幫助 AI 系統準確描述你的網站;
- 引導代理程式前往目前的文件;
- 陳述重複使用與歸屬標示偏好;
- 減少對封存內容或使用者產生內容的混淆。
如果你試圖讓 llms.txt 解決所有 AI 治理問題,它最後什麼也解決不了。
2. 找出 canonical 頁面
選出最能代表網站的 5–20 個 URL。優先選擇穩定且持續維護的頁面,而不是高流量頁面。對 SaaS 公司而言,可能是首頁、文件、定價、安全性、隱私權、API 參考、狀態與聯絡頁。對出版者而言,可能是主題中心、編輯標準、作者頁面、更正政策與授權資訊。
3. 同時為機器與人類撰寫
使用清楚的 Markdown 標題。避免行銷文案。用一兩句話說明網站是什麼。
不佳:
我們以新世代解決方案革新數位卓越的未來。
較佳:
Acme Docs publishes technical documentation for Acme’s payments API, including authentication, webhooks, SDKs, and migration guides.
4. 謹慎加入政策文字
你的政策區段應該容易理解,而不是過度自信。例如:
公開頁面可在標示歸屬的前提下,用於搜尋、無障礙與使用者協助的摘要。大量複製、資料集建立或模型訓練需要取得許可。
這不保證對方會遵循,但比沉默清楚。
5. 發布並維護它
將它放在 /llms.txt。以 text/plain 或相容的文字回應提供。只連結到 canonical URL。當你的資訊架構變更時,重新檢視它。
過時的 llms.txt 比沒有檔案更糟,因為它給出的是自信但已不再正確的指示。
每個網站都應該有一份嗎?
不是。
五頁式的形象網站大概不需要 llms.txt。在地餐廳也不需要,除非它有 AI 助理經常誤述的結構化政策或訂位資訊。
在以下情況下,它會更有用:
- 你的網站有大量文件;
- 舊內容與新內容彼此競爭;
- 你發布研究或編輯內容;
- 授權與歸屬標示很重要;
- AI 助理經常摘要你的頁面;
- 內部團隊需要一套針對公開內容的共用政策。
它也很適合作為內部治理練習的一部分。許多公司已經有員工把網頁、文件與客戶材料貼進 AI 系統。如果這聽起來很熟悉,在假設公開文字檔能修補風險之前,請先做一次基本的 shadow AI 稽核。
SEO 影響
llms.txt 在任何既有意義上都不是排名因素。不要因為期待下週流量提升而撰寫它。
間接的 SEO 理由比較有限:
- 它迫使你思考 canonical;
- 它可能幫助 AI 中介的搜尋與回答系統理解你的網站;
- 它釐清歸屬標示偏好;
- 它減少封存頁面的模糊性;
- 它建立一份公開、可檢視的 AI 內容政策。
這對某些網站值得做。它不是神奇的最佳化層。
最好的 llms.txt 是小型、最新,且與網站其他部分一致的。如果你的 robots 規則、條款頁面、sitemap、canonical tags 與 llms.txt 全都說不同的事,問題就不是 AI 爬取。問題是治理。
<!-- tool-cta:start -->
💡 試試這樣做: 由於 llms.txt 不具強制執行力,請將其與可強制執行的規則搭配使用,並在 Robots.txt Tester 中檢查這些規則,以便遵守標準的爬蟲能夠正確運作。
<!-- tool-cta:end -->
最後建議
如果你的網站有文件、編輯內容或授權疑慮,請建立一份簡單的 llms.txt。讓它維持在幾十行以內。用它指向 canonical 資源,並陳述你的重複使用偏好。
但不要把溝通誤認為控制。
若要阻擋,請使用你可用的爬蟲機制,並理解其限制。若要制定政策,請發布清楚的條款。若要建立信任,請對讀者保持透明。llms.txt 屬於這套工具組的一部分,是有幫助的訊號,而不是盾牌。
常見問題
llms.txt 是正式標準嗎?
llms.txt 會阻止 AI 公司用我的內容訓練嗎?
我應該把 llms.txt 放在哪裡?
llms.txt 應該包含我網站上的每個頁面嗎?
llms.txt 對 SEO 有幫助嗎?
來源與進一步閱讀