Paano sumulat ng llms.txt—at kung may nagagawa nga ba ito
Isang praktikal na gabay sa umuusbong na file para sa mga AI crawler, buod ng content, at mga tagubilin ng site para sa mga modelo.
Talaan ng nilalaman
- Ang maikling bersyon
- Ano ang nilalayong lutasin ng llms.txt
- May nagagawa ba talaga ang llms.txt?
- Hindi nito maaasahang nahaharang ang mga AI crawler
- Makakatulong ito sa interpretasyon
- Maaari nitong linawin ang iyong content policy
- Ano ang ilalagay sa llms.txt
- Ano ang hindi dapat ilagay sa llms.txt
- Paano nauugnay ang llms.txt sa robots.txt
- Isang praktikal na proseso ng pagsulat
- 1. Magpasya sa trabaho ng file
- 2. Tukuyin ang mga canonical page
- 3. Sumulat para sa makina at tao
- 4. Maingat na magdagdag ng policy language
- 5. I-publish at panatilihin ito
- Dapat bang magkaroon nito ang bawat site?
- Mga implikasyon sa SEO
- Panghuling rekomendasyon
Ang maikling bersyon
Ang llms.txt ay isang umuusbong na kumbensyon para sabihin sa malalaking language model kung ano ang iyong site, aling mga page ang mahalaga, at paano dapat unawain ang iyong content. Karaniwan itong nasa https://example.com/llms.txt, nakasulat sa Markdown, at nagli-link sa malilinis at kapaki-pakinabang na resource.
Hindi ito katulad ng robots.txt. Hindi ito opisyal na web standard. Hindi nito maaasahang nahaharang ang AI training. Hindi nito napipilit ang isang AI company na sundin ang iyong kagustuhan.
Gayunpaman, maaaring sulit itong isulat.
Ang mahusay na llms.txt ay mababang-gastos na paraan para gawing mas madali para sa mga AI system, agent, search assistant, at internal tool na ibuod nang tama ang iyong site. Isa rin itong puwersang nagpapalinaw: kailangan mong magpasya kung aling content ang canonical, aling content ang luma na, at anong mga termino ang nalalapat sa muling paggamit. Kapaki-pakinabang iyon kahit iilang system pa lang ang kasalukuyang nagbabasa ng file.
Ano ang nilalayong lutasin ng llms.txt
Karamihan sa mga website ay ginawa para sa tao at search crawler. Mayroon silang navigation, cookie banner, product card, duplicate category page, lumang PDF, tracking parameter, at content na may saysay lang sa biswal na paraan.
Hindi kailangan ng mga LLM ang parehong presentation layer. Kailangan nila ng:
- maikling paglalarawan ng site;
- mga link sa pinakaawtoritatibong page;
- kontekstong nasa malinaw na wika tungkol sa mga produkto, doc, patakaran, o authorship;
- mga preference sa licensing at paggamit;
- mga pointer sa structured o Markdown na bersyon kung available.
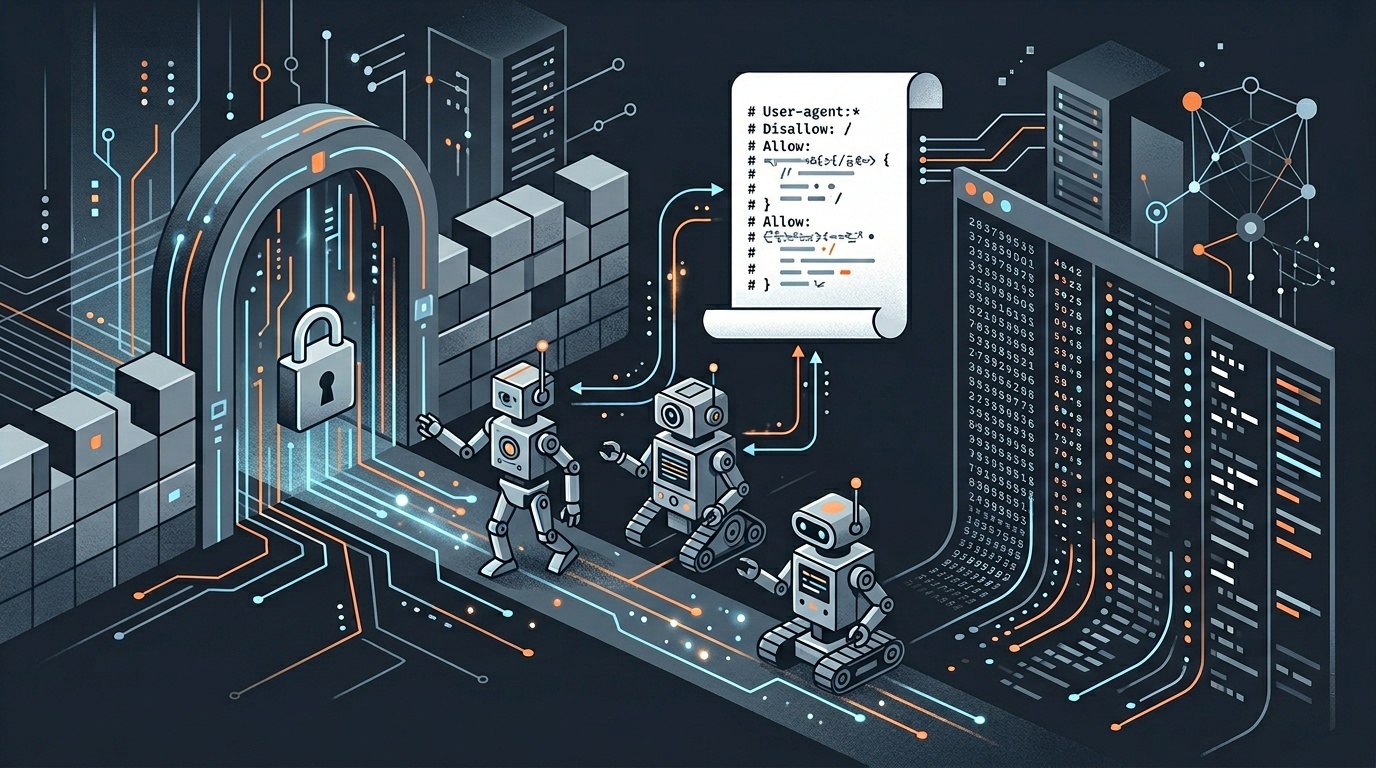
Humihiram ang panukalang llms.txt ng pamilyar na ideya sa web: maglagay ng predictable na text file sa root ng domain. Hindi tulad ng robots.txt, na pangunahing tungkol sa crawl permissions, ang llms.txt ay kadalasang tungkol sa orientation.
Isipin ito bilang mapa, hindi gate.
May nagagawa ba talaga ang llms.txt?
Sa ngayon, ang tapat na sagot ay: minsan, pero hindi sa paraang inaasahan ng marami.
Hindi nito maaasahang nahaharang ang mga AI crawler
Kung layunin mong pigilan ang crawling o training, maling pangunahing mekanismo ang llms.txt. Mas malamang na titingnan ng mga crawler na gumagalang sa exclusion rules ang robots.txt, partikular na user-agent directives, HTTP headers, o mga signal sa kontrata/licensing. Kahit noon, nakadepende ang pagsunod sa operator ng crawler.
May mahabang kasaysayan ang web dito. Ang robots.txt mismo ay boluntaryong protocol, na kalauna’y pormal na isinama sa RFC 9309. Gumagana ito dahil pinipili ng malalaking crawler na igalang ito, hindi dahil may mahiwagang kapangyarihan sa pagpapatupad ang file.
Mas kaunti ang adoption at standardization ng llms.txt kaysa robots.txt. Dapat pagdudahan ang anumang pahayag na “pinoprotektahan nito ang iyong content mula sa AI.”
Makakatulong ito sa interpretasyon
Mas promising ang llms.txt pagdating sa interpretasyon ng content.
Kung sinusubukan ng isang AI assistant na sumagot ng mga tanong tungkol sa iyong kumpanya, dokumentasyon, research, pricing, API, o editorial policy, maaaring bawasan ng isang maikling file sa root level ang panghuhula. Maaari nitong ituro ang system sa mga page na aktuwal mong pinapanatili at ilayo ito sa mga lipas na fragment.
Mahalaga ito para sa mga site na may malalaking archive. Maaaring mahanap ng isang modelo o agent ang isang support article noong 2019 bago ang policy page ng 2026. Maaaring sabihin ng iyong llms.txt, sa diwa: “Magsimula rito. Ito ang mga awtoritatibong resource.”
Hindi ito marangya, pero kapaki-pakinabang.
Maaari nitong linawin ang iyong content policy
Mas mabuti ang pampublikong policy para sa AI kaysa katahimikan, lalo na para sa mga publisher, documentation team, at kumpanyang may sensitibong brand o materyal na medikal/legal/pinansyal.
Hindi ibig sabihin nito na dapat kang magsulat ng nakakatakot na pader ng legal na teksto. Ibig sabihin, maaari mong sabihin nang malinaw:
- kung maaaring ibuod ng mga AI system ang iyong mga pampublikong page;
- kung maaaring gamitin ang iyong content para sa model training;
- paano mo gustong pangasiwaan ang attribution;
- aling mga page ang dapat ituring na canonical;
- sino ang dapat kontakin para sa licensing o data partnerships.
Maganda itong ipares sa mas malawak na editorial transparency. Kung nagpa-publish ka ng AI-assisted content, hindi dapat sumalungat ang iyong llms.txt sa iyong pampublikong disclosure. Para sa praktikal na baseline, tingnan ang aming gabay sa tapat na AI disclosure sa isang maliit na website.
Ano ang ilalagay sa llms.txt
Walang universally enforced schema, ngunit ang kasalukuyang kumbensyon ay Markdown. Panatilihin itong maikli, malinaw, at payak.
Ganito ang isang kapaki-pakinabang na estruktura:
# Example Company

> Example Company publishes practical guides and reference material for independent web developers.

## Canonical resources

- Homepage: https://example.com/
- Documentation: https://example.com/docs/
- Pricing: https://example.com/pricing/
- Editorial policy: https://example.com/editorial-policy/
- Contact: https://example.com/contact/

## Content use policy

Public pages may be summarized with attribution to Example Company and a link to the source page.

Use of our content for model training, dataset creation, or bulk republication requires written permission.

## Preferred citation

When citing our content, link to the canonical URL and include the page title.

## Notes for AI systems

- Prefer current documentation under /docs/ over archived blog posts.
- Do not treat user comments as official guidance.
- Product screenshots may be outdated; use written documentation as the source of truth.
Sapat na iyon para sa maraming site.
Para sa mas malalaking site, magdagdag ng mga seksyon para sa product areas, API docs, research, press pages, o legal policies. Pigilan ang tukso na ilista ang lahat. Habang mas nagiging komprehensibo ang file, mas nababawasan ang pagiging kapaki-pakinabang nito bilang panimulang punto.
Ano ang hindi dapat ilagay sa llms.txt
Huwag maglagay ng pribadong impormasyon dito. Parang halata ito, pero ang mga root-level text file ay madalas nagiging tambakan ng operational notes.
Iwasang isama ang:
- mga URL na hindi pa naipa-publish;
- internal staging links;
- API keys o tokens;
- pribadong contact details;
- security instructions;
- embargoed product information;
- “secret” pages na inaasahan mong hindi papansinin ng mga crawler.
Kung may bagay na hindi dapat maging pampubliko, huwag itong banggitin sa isang pampublikong file.
Iwasan din ang malabong legal theater. Maaaring maipahayag ng “All AI use is forbidden forever” ang pagkadismaya, ngunit hindi ito lumilikha ng maaasahang technical control. Kung talagang kailangan ng iyong organisasyon ng mga restriction na maipapatupad, isama ang legal counsel at gamitin nang magkakasama ang crawler controls, licensing terms, at access controls.
Paano nauugnay ang llms.txt sa robots.txt
Gamitin ang robots.txt para sa crawl directives. Gamitin ang llms.txt para sa konteksto.
Isang pinasimpleng paghahati:
| File | Pangunahing layunin | Maipapatupad? | Pinakamainam gamitin para sa | |---|---|---:|---| | robots.txt | Crawl permissions | Boluntaryo ngunit malawak na kinikilala | Pagpayag o pagbabawal sa mga crawler ayon sa path at user agent | | llms.txt | Buod at gabay para sa LLM | Hindi kasalukuyang standardized | Canonical links, content policy, mga tala sa interpretasyon | | Terms page | Mga legal na kondisyon | Nakadepende sa hurisdiksyon at facts | Licensing, pinapayagang reuse, commercial restrictions | | HTTP headers | Page-level technical signals | Nakadepende sa suporta ng crawler | Indexing, caching, at response behavior |
Kung nagde-debug ka na ng crawler behavior, huwag huminto sa text file. Suriin kung tama talagang sine-serve ng site mo ang file, kung kumikilos ang mga redirect gaya ng inaasahan, at kung tumutugma ang mga header sa iyong policy. Sumulat kami ng hiwalay na gabay sa pagde-debug ng redirects at HTTP headers sa production dahil dito tahimik na pumapalya ang maraming desisyong “policy.”
Isang praktikal na proseso ng pagsulat
Narito ang isang makatwirang workflow.
1. Magpasya sa trabaho ng file
Pumili ng isang pangunahing layunin:
- tulungan ang mga AI system na ilarawan nang tama ang iyong site;
- gabayan ang mga agent patungo sa kasalukuyang dokumentasyon;
- sabihin ang mga preference sa reuse at attribution;
- bawasan ang kalituhan sa archived o user-generated content.
Kung susubukan mong gawing solusyon ang llms.txt sa bawat problema sa AI governance, wala itong malulutas.
2. Tukuyin ang mga canonical page
Piliin ang 5–20 URL na pinakamahusay na kumakatawan sa site. Mas piliin ang stable at pinapanatiling page kaysa high-traffic pages. Para sa isang SaaS company, maaaring ito ay homepage, docs, pricing, security, privacy, API reference, status, at contact. Para sa isang publisher, maaaring ito ay topic hubs, editorial standards, author pages, corrections policy, at licensing.
3. Sumulat para sa makina at tao
Gumamit ng malinaw na Markdown headings. Iwasan ang marketing copy. Sabihin kung ano ang site sa isa o dalawang pangungusap.
Hindi maganda:
Binabago namin ang kinabukasan ng digital excellence gamit ang next-generation solutions.
Mas mabuti:
Nagpa-publish ang Acme Docs ng technical documentation para sa payments API ng Acme, kabilang ang authentication, webhooks, SDKs, at migration guides.
4. Maingat na magdagdag ng policy language
Dapat madaling maunawaan ang iyong policy section nang hindi sobra ang kumpiyansa. Halimbawa:
Maaaring ibuod ang mga pampublikong page para sa search, accessibility, at tulong sa user na may attribution. Nangangailangan ng pahintulot ang bulk copying, dataset creation, o model training.
Hindi nito ginagarantiyahan ang pagsunod, ngunit mas malinaw ito kaysa katahimikan.
5. I-publish at panatilihin ito
Ilagay ito sa /llms.txt. I-serve ito bilang text/plain o compatible na text response. Mag-link lamang sa canonical URLs. Rebyuhin ito kapag nagbago ang iyong information architecture.
Mas masama ang stale na llms.txt kaysa walang file, dahil nagbibigay ito ng kumpiyansang tagubilin na hindi na totoo.
Dapat bang magkaroon nito ang bawat site?
Hindi.
Malamang hindi kailangan ng five-page brochure site ang llms.txt. Hindi rin kailangan ng isang lokal na restaurant nito maliban kung mayroon itong structured policies o booking information na madalas mali ang pagkakasabi ng mga AI assistant.
Mas nagiging kapaki-pakinabang ito kapag:
- maraming dokumentasyon ang iyong site;
- nakikipagkompetensya ang lumang content sa bagong content;
- nagpa-publish ka ng research o editorial material;
- mahalaga ang licensing at attribution;
- madalas ibuod ng mga AI assistant ang iyong mga page;
- kailangan ng internal teams ng shared policy para sa pampublikong content.
Kapaki-pakinabang din ito bilang bahagi ng internal governance exercise. Maraming kumpanya ang mayroon nang mga empleyadong nagpa-paste ng web pages, docs, at customer material sa mga AI system. Kung pamilyar iyon, magsagawa muna ng basic na shadow AI audit bago ipagpalagay na maaayos ng isang pampublikong text file ang panganib.
Mga implikasyon sa SEO
Ang llms.txt ay hindi ranking factor sa anumang established na kahulugan. Huwag gumawa nito dahil umaasa kang tataas ang traffic sa susunod na linggo.
Mas katamtaman ang indirect SEO case:
- pinipilit nito ang canonical thinking;
- maaaring makatulong ito sa AI-mediated search at answer systems na maunawaan ang iyong site;
- nililinaw nito ang attribution preferences;
- binabawasan nito ang ambiguity sa archived pages;
- lumilikha ito ng pampubliko at nasusuring AI content policy.
Sulit iyon para sa ilang site. Hindi ito magic optimization layer.
Ang pinakamahusay na bersyon ng llms.txt ay maliit, kasalukuyan, at nakaayon sa natitirang bahagi ng iyong site. Kung magkakaiba ang sinasabi ng iyong robots rules, terms page, sitemap, canonical tags, at llms.txt, hindi AI crawling ang problema. Governance ang problema.
<!-- tool-cta:start -->
💡 Subukan ito: Dahil hindi maipapatupad ang llms.txt, ipares ito sa mga maipapatupad na panuntunan at suriin ang mga iyon sa Robots.txt Tester upang kumilos nang tama ang mga crawler na sumusunod sa mga pamantayan.
<!-- tool-cta:end -->
Panghuling rekomendasyon
Kung may dokumentasyon, editorial content, o mga alalahanin sa licensing ang iyong site, gumawa ng simpleng llms.txt. Panatilihin ito sa ilang dosenang linya lang. Gamitin ito para ituro ang canonical resources at sabihin ang iyong reuse preferences.
Ngunit huwag ipagkamali ang komunikasyon sa kontrol.
Para sa blocking, gamitin ang mga crawler mechanism na available sa iyo at unawain ang mga limitasyon ng mga ito. Para sa policy, mag-publish ng malinaw na terms. Para sa tiwala, maging transparent sa mga mambabasa. Ang llms.txt ay kabilang sa stack na iyon bilang kapaki-pakinabang na signal—hindi bilang panangga.
Mga madalas itanong
Opisyal bang standard ang llms.txt?
Mapipigilan ba ng llms.txt ang mga AI company na mag-training gamit ang content ko?
Saan ko dapat ilagay ang llms.txt?
Dapat bang isama ng llms.txt ang bawat page sa site ko?
Nakakatulong ba ang llms.txt sa SEO?
Mga mapagkukunan at karagdagang pagbabasa