Hoe je llms.txt schrijft—en of het eigenlijk iets doet
Een praktische gids voor het opkomende bestand voor AI-crawlers, contentsamenvattingen en site-instructies voor modellen.
Inhoudsopgave
- De korte versie
- Wat llms.txt moet oplossen
- Doet llms.txt echt iets?
- Het blokkeert AI-crawlers niet betrouwbaar
- Het kan helpen bij interpretatie
- Het kan je contentbeleid verduidelijken
- Wat je in llms.txt zet
- Wat je niet in llms.txt zet
- Hoe llms.txt zich verhoudt tot robots.txt
- Een praktisch schrijfproces
- 1. Bepaal de taak van het bestand
- 2. Identificeer canonieke pagina’s
- 3. Schrijf voor machines en mensen
- 4. Voeg beleidstaal zorgvuldig toe
- 5. Publiceer en onderhoud het
- Moet elke site er een hebben?
- SEO-implicaties
- Een laatste aanbeveling
De korte versie
llms.txt is een opkomende conventie om grote taalmodellen te vertellen wat je site is, welke pagina’s belangrijk zijn en hoe je content moet worden begrepen. Het bestand staat meestal op https://example.com/llms.txt, is geschreven in Markdown en linkt naar schone, nuttige bronnen.
Het is niet hetzelfde als robots.txt. Het is geen officiële webstandaard. Het blokkeert AI-training niet betrouwbaar. Het dwingt een AI-bedrijf niet om je wensen te volgen.
Toch kan het de moeite waard zijn om er een te schrijven.
Een goede llms.txt is een goedkope manier om je site makkelijker correct te laten samenvatten door AI-systemen, agents, zoekassistenten en interne tools. Het dwingt ook tot keuzes: je moet bepalen welke content canoniek is, welke content verouderd is en welke voorwaarden gelden voor hergebruik. Dat is nuttig, zelfs als momenteel maar een paar systemen het bestand lezen.
Wat llms.txt moet oplossen
De meeste websites zijn gebouwd voor mensen en zoekcrawlers. Ze bevatten navigatie, cookiebanners, productkaarten, dubbele categoriepagina’s, oude PDF’s, trackingparameters en content die alleen visueel logisch is.
LLM’s hebben niet dezelfde presentatielaag nodig. Ze hebben nodig:
- een beknopte beschrijving van de site;
- links naar de meest gezaghebbende pagina’s;
- context in gewone taal over producten, documentatie, beleid of auteurschap;
- licentie- en gebruiksvoorkeuren;
- verwijzingen naar gestructureerde of Markdown-versies waar beschikbaar.
Het llms.txt-voorstel leent een bekend webidee: plaats een voorspelbaar tekstbestand in de root van het domein. Anders dan robots.txt, dat vooral over crawltoestemmingen gaat, draait llms.txt vooral om oriëntatie.
Zie het als een kaart, niet als een poort.
Doet llms.txt echt iets?
Vandaag is het eerlijke antwoord: soms, maar niet op de manier waarop veel mensen hopen.
Het blokkeert AI-crawlers niet betrouwbaar
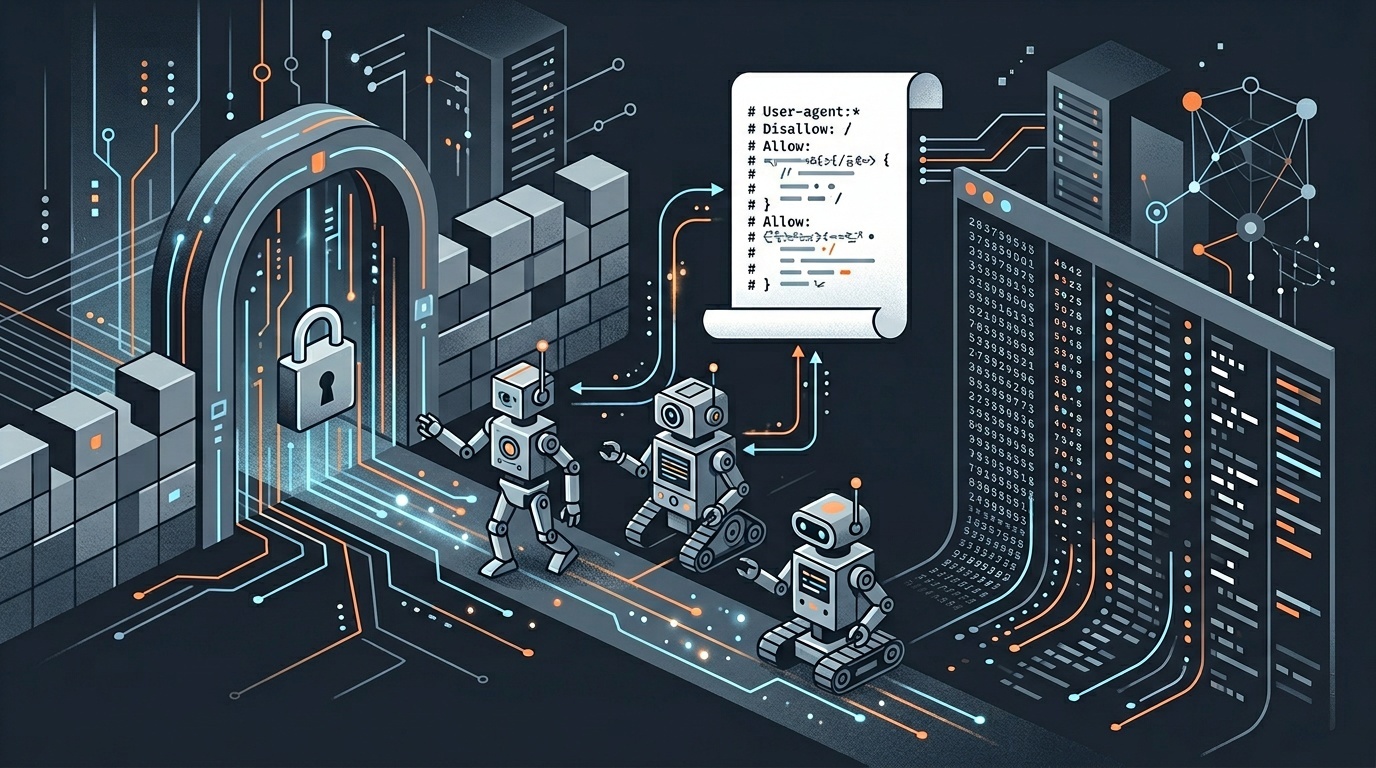
Als je doel is om crawlen of trainen te voorkomen, is llms.txt het verkeerde primaire mechanisme. Crawlers die uitsluitingsregels respecteren, zullen eerder kijken naar robots.txt, specifieke user-agent-richtlijnen, HTTP-headers of contractuele/licentiesignalen. Zelfs dan hangt naleving af van de crawlerbeheerder.
Het web heeft hier een lange geschiedenis mee. robots.txt zelf is een vrijwillig protocol, later geformaliseerd in RFC 9309. Het werkt omdat grote crawlers ervoor kiezen het te respecteren, niet omdat het bestand magische afdwingingskracht heeft.
llms.txt heeft minder adoptie en minder standaardisatie dan robots.txt. Behandel elke claim dat het “je content beschermt tegen AI” met argwaan.
Het kan helpen bij interpretatie
Waar llms.txt veelbelovender is, is contentinterpretatie.
Als een AI-assistent vragen probeert te beantwoorden over je bedrijf, documentatie, onderzoek, prijzen, API of redactioneel beleid, kan een beknopt bestand op rootniveau giswerk verminderen. Het kan het systeem naar de pagina’s sturen die je daadwerkelijk onderhoudt en weg van verouderde fragmenten.
Dit is belangrijk voor sites met grote archieven. Een model of agent kan een supportartikel uit 2019 vinden vóór een beleidspagina uit 2026. Je llms.txt kan in feite zeggen: “Begin hier. Dit zijn de gezaghebbende bronnen.”
Dat is niet glamoureus, maar wel nuttig.
Het kan je contentbeleid verduidelijken
Een openbaar AI-gericht beleid is beter dan stilte, vooral voor uitgevers, documentatieteams en bedrijven met gevoelig merk-, medisch, juridisch of financieel materiaal.
Dit betekent niet dat je een dreigende muur juridische tekst moet schrijven. Het betekent dat je helder kunt aangeven:
- of AI-systemen je openbare pagina’s mogen samenvatten;
- of je content mag worden gebruikt voor modeltraining;
- hoe je wilt dat attributie wordt behandeld;
- welke pagina’s als canoniek moeten worden beschouwd;
- met wie men contact kan opnemen voor licenties of data-partnerships.
Dit past goed bij bredere redactionele transparantie. Als je AI-ondersteunde content publiceert, mag je llms.txt je openbare toelichting niet tegenspreken. Zie voor een praktische basislijn onze gids over eerlijke AI-vermelding op een kleine website.
Wat je in llms.txt zet
Er is geen universeel afgedwongen schema, maar de huidige conventie is Markdown. Houd het kort, expliciet en saai.
Een nuttige structuur ziet er zo uit:
# Example Company

> Example Company publishes practical guides and reference material for independent web developers.

## Canonical resources

- Homepage: https://example.com/
- Documentation: https://example.com/docs/
- Pricing: https://example.com/pricing/
- Editorial policy: https://example.com/editorial-policy/
- Contact: https://example.com/contact/

## Content use policy

Public pages may be summarized with attribution to Example Company and a link to the source page.

Use of our content for model training, dataset creation, or bulk republication requires written permission.

## Preferred citation

When citing our content, link to the canonical URL and include the page title.

## Notes for AI systems

- Prefer current documentation under /docs/ over archived blog posts.
- Do not treat user comments as official guidance.
- Product screenshots may be outdated; use written documentation as the source of truth.
Dat is genoeg voor veel sites.
Voeg voor grotere sites secties toe voor productgebieden, API-documentatie, onderzoek, perspagina’s of juridisch beleid. Weersta de neiging om alles op te sommen. Hoe vollediger het bestand wordt, hoe minder nuttig het is als startpunt.
Wat je niet in llms.txt zet
Zet er geen privé-informatie in. Dit klinkt vanzelfsprekend, maar tekstbestanden op rootniveau worden vaak verzamelplekken voor operationele notities.
Vermijd het opnemen van:
- niet-gepubliceerde URL’s;
- interne staging-links;
- API-sleutels of tokens;
- privécontactgegevens;
- beveiligingsinstructies;
- productinformatie onder embargo;
- “geheime” pagina’s waarvan je hoopt dat crawlers ze zullen negeren.
Als iets niet openbaar mag zijn, noem het dan niet in een openbaar bestand.
Vermijd ook vaag juridisch theater. “Alle AI-gebruik is voor altijd verboden” kan frustratie uitdrukken, maar het creëert geen betrouwbare technische controle. Als je organisatie echt afdwingbare beperkingen nodig heeft, betrek dan juridisch advies en gebruik crawlercontroles, licentievoorwaarden en toegangscontroles samen.
Hoe llms.txt zich verhoudt tot robots.txt
Gebruik robots.txt voor crawlrichtlijnen. Gebruik llms.txt voor context.
Een vereenvoudigde verdeling:
| Bestand | Hoofddoel | Afdwingbaar? | Best gebruikt voor | |---|---|---:|---| | robots.txt | Crawltoestemmingen | Vrijwillig maar breed erkend | Crawlers toestaan of blokkeren per pad en user agent | | llms.txt | Samenvatting en richtlijnen voor LLM’s | Momenteel niet gestandaardiseerd | Canonieke links, contentbeleid, interpretatienotities | | Voorwaardenpagina | Juridische voorwaarden | Hangt af van jurisdictie en feiten | Licenties, toegestaan hergebruik, commerciële beperkingen | | HTTP-headers | Technische signalen op paginaniveau | Hangt af van crawlerondersteuning | Indexering, caching en responsgedrag |
Als je al crawlergedrag aan het debuggen bent, stop dan niet bij het tekstbestand. Controleer of je site het bestand daadwerkelijk correct serveert, of redirects zich gedragen zoals verwacht en of headers overeenkomen met je beleid. We schreven een aparte gids over redirects en HTTP-headers debuggen in productie, omdat hier veel “beleidsbeslissingen” stilletjes mislukken.
Een praktisch schrijfproces
Dit is een verstandige workflow.
1. Bepaal de taak van het bestand
Kies één primair doel:
- AI-systemen helpen je site accuraat te beschrijven;
- agents naar actuele documentatie leiden;
- voorkeuren voor hergebruik en attributie vastleggen;
- verwarring rond gearchiveerde of door gebruikers gegenereerde content verminderen.
Als je probeert llms.txt elk AI-governanceprobleem te laten oplossen, lost het er geen enkel op.
2. Identificeer canonieke pagina’s
Kies de 5–20 URL’s die de site het best vertegenwoordigen. Geef de voorkeur aan stabiele, onderhouden pagina’s boven pagina’s met veel verkeer. Voor een SaaS-bedrijf kunnen dat de homepage, documentatie, prijzen, beveiliging, privacy, API-referentie, status en contact zijn. Voor een uitgever kunnen dat onderwerp-hubs, redactionele standaarden, auteurspagina’s, correctiebeleid en licenties zijn.
3. Schrijf voor machines en mensen
Gebruik duidelijke Markdown-koppen. Vermijd marketingtaal. Zeg in één of twee zinnen wat de site is.
Slecht:
We revolutioneren de toekomst van digitale excellentie met oplossingen van de volgende generatie.
Beter:
Acme Docs publiceert technische documentatie voor Acme’s payments API, inclusief authenticatie, webhooks, SDKs en migratiegidsen.
4. Voeg beleidstaal zorgvuldig toe
Je beleidssectie moet begrijpelijk zijn zonder te stellig te zijn. Bijvoorbeeld:
Openbare pagina’s mogen worden samengevat voor zoeken, toegankelijkheid en gebruikersondersteuning met attributie. Bulk-kopiëren, datasetcreatie of modeltraining vereist toestemming.
Dat garandeert geen naleving, maar het is duidelijker dan stilte.
5. Publiceer en onderhoud het
Plaats het op /llms.txt. Serveer het als text/plain of een compatibele tekstrespons. Link alleen naar canonieke URL’s. Controleer het wanneer je informatiearchitectuur verandert.
Een verouderde llms.txt is slechter dan geen bestand, omdat het zelfverzekerde instructies geeft die niet langer waar zijn.
Moet elke site er een hebben?
Nee.
Een brochuresite van vijf pagina’s heeft waarschijnlijk geen llms.txt nodig. Een lokaal restaurant heeft er geen nodig, tenzij het gestructureerd beleid of boekingsinformatie heeft die AI-assistenten vaak verkeerd weergeven.
Het wordt nuttiger wanneer:
- je site veel documentatie heeft;
- oude content concurreert met nieuwe content;
- je onderzoek of redactioneel materiaal publiceert;
- licenties en attributie belangrijk zijn;
- AI-assistenten je pagina’s vaak samenvatten;
- interne teams een gedeeld beleid nodig hebben voor openbare content.
Het is ook nuttig als onderdeel van een interne governance-oefening. Veel bedrijven hebben al medewerkers die webpagina’s, documenten en klantmateriaal in AI-systemen plakken. Als dat bekend klinkt, voer dan een basis-shadow AI-audit uit voordat je aanneemt dat een openbaar tekstbestand het risico oplost.
SEO-implicaties
llms.txt is in geen enkele gevestigde zin een rankingfactor. Schrijf er geen omdat je volgende week een verkeersboost verwacht.
De indirecte SEO-case is bescheidener:
- het dwingt canoniek denken af;
- het kan AI-gemedieerde zoek- en antwoordsystemen helpen je site te begrijpen;
- het verduidelijkt attributievoorkeuren;
- het vermindert ambiguïteit rond gearchiveerde pagina’s;
- het creëert een openbaar, inspecteerbaar AI-contentbeleid.
Dat is voor sommige sites de moeite waard. Het is geen magische optimalisatielaag.
De beste versie van llms.txt is klein, actueel en afgestemd op de rest van je site. Als je robots-regels, voorwaardenpagina, sitemap, canonical tags en llms.txt allemaal iets anders zeggen, is AI-crawling niet het probleem. Het probleem is governance.
<!-- tool-cta:start -->
💡 Probeer dit: Omdat llms.txt niet afdwingbaar is, combineer je het met afdwingbare regels en controleer je die in Robots.txt Tester, zodat crawlers die zich aan standaarden houden zich correct gedragen.
<!-- tool-cta:end -->
Een laatste aanbeveling
Als je site documentatie, redactionele content of licentiekwesties heeft, maak dan een eenvoudige llms.txt. Houd het onder een paar dozijn regels. Gebruik het om naar canonieke bronnen te verwijzen en je hergebruikvoorkeuren vast te leggen.
Maar verwar communicatie niet met controle.
Gebruik voor blokkeren de crawlermechanismen die je tot je beschikking hebt en begrijp hun beperkingen. Publiceer duidelijke voorwaarden voor beleid. Wees transparant naar lezers voor vertrouwen. llms.txt hoort in die stack als een nuttig signaal—niet als een schild.
Veelgestelde vragen
Is llms.txt een officiële standaard?
Zal llms.txt AI-bedrijven ervan weerhouden op mijn content te trainen?
Waar moet ik llms.txt plaatsen?
Moet llms.txt elke pagina op mijn site bevatten?
Helpt llms.txt bij SEO?
Bronnen & verder lezen