Как да напишете llms.txt — и дали всъщност прави нещо
Практическо ръководство за нововъзникващия файл за AI crawlers, резюмета на съдържание и инструкции за сайта, насочени към модели.
Съдържание
- Кратката версия
- Какъв проблем трябва да решава llms.txt
- llms.txt всъщност прави ли нещо?
- Не блокира надеждно AI crawlers
- Може да помогне при тълкуването
- Може да изясни политиката ви за съдържание
- Какво да поставите в llms.txt
- Какво да не поставяте в llms.txt
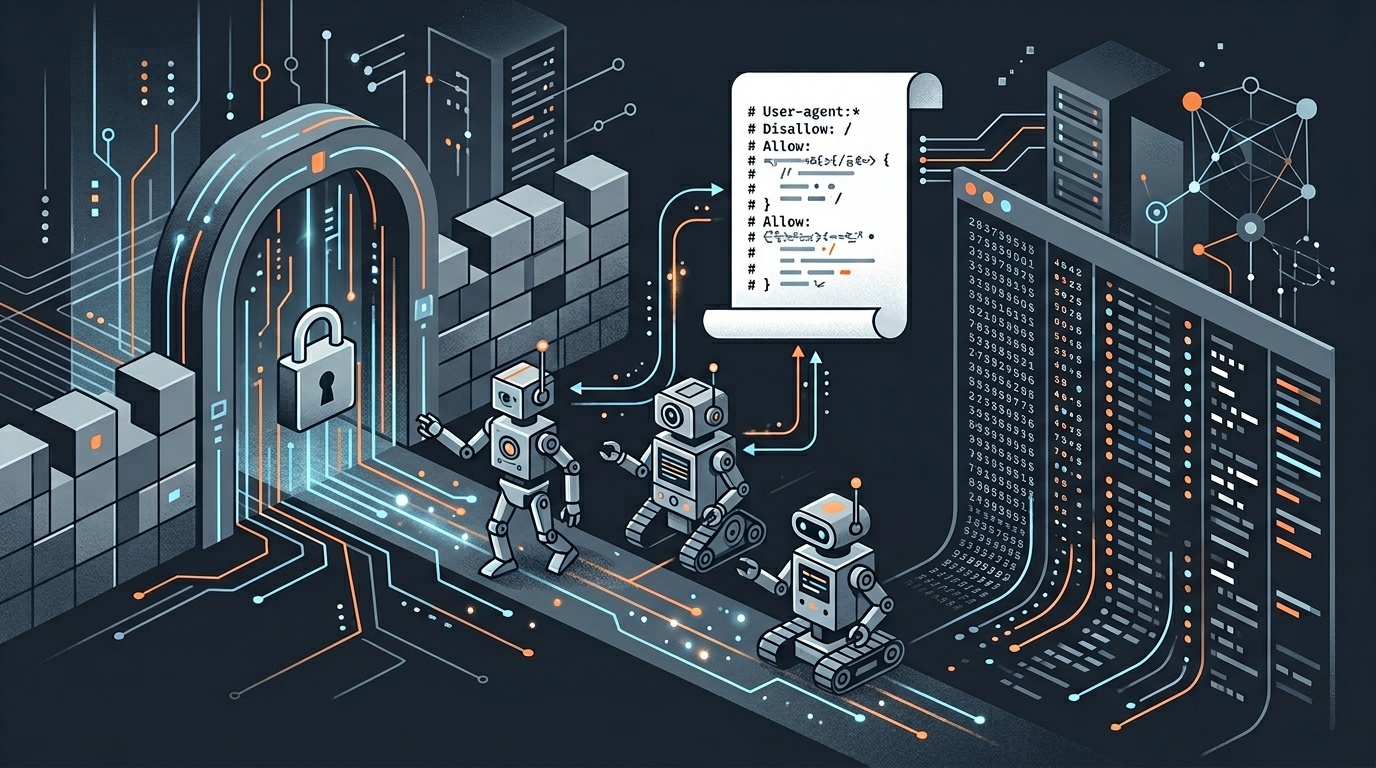
- Как llms.txt се отнася към robots.txt
- Практически процес на писане
- 1. Решете каква е задачата на файла
- 2. Определете каноничните страници
- 3. Пишете за машини и хора
- 4. Добавете език за политиката внимателно
- 5. Публикувайте го и го поддържайте
- Всеки сайт ли трябва да има такъв файл?
- SEO последици
- Финална препоръка
Кратката версия
llms.txt е нововъзникваща конвенция за това да кажете на големите езикови модели какъв е сайтът ви, кои страници са важни и как трябва да бъде разбирано съдържанието ви. Обикновено се намира на https://example.com/llms.txt, пише се в Markdown и съдържа връзки към чисти, полезни ресурси.
Това не е същото като robots.txt. Не е официален уеб стандарт. Не блокира надеждно AI обучението. Не принуждава AI компания да следва желанията ви.
И все пак може да си струва да го напишете.
Добрият llms.txt е евтин начин да направите сайта си по-лесен за правилно резюмиране от AI системи, agents, асистенти за търсене и вътрешни инструменти. Той е и полезна дисциплинираща стъпка: трябва да решите кое съдържание е канонично, кое е остаряло и какви условия важат за повторна употреба. Това е полезно дори ако в момента само няколко системи четат файла.
Какъв проблем трябва да решава llms.txt
Повечето уебсайтове са изградени за хора и search crawlers. Те съдържат навигация, банери за cookies, продуктови карти, дублирани категорийни страници, стари PDF файлове, tracking parameters и съдържание, което има смисъл само визуално.
LLMs не се нуждаят от същия презентационен слой. Те се нуждаят от:
- кратко описание на сайта;
- връзки към най-авторитетните страници;
- контекст на ясен език за продукти, документация, политики или авторство;
- предпочитания за лицензиране и употреба;
- указатели към структурирани или Markdown версии, когато са налични.
Предложението за llms.txt заема позната уеб идея: поставете предвидим текстов файл в корена на домейна. За разлика от robots.txt, който е основно за разрешения за crawl, llms.txt е най-вече за ориентация.
Мислете за него като за карта, а не като за порта.
llms.txt всъщност прави ли нещо?
Днес честният отговор е: понякога, но не по начина, на който много хора се надяват.
Не блокира надеждно AI crawlers
Ако целта ви е да предотвратите crawling или training, llms.txt е грешният основен механизъм. Crawlers, които спазват правила за изключване, по-вероятно ще гледат robots.txt, конкретни директиви за user-agent, HTTP headers или договорни/лицензионни сигнали. Дори тогава спазването зависи от оператора на crawler-а.
Уебът има дълга история тук. Самият robots.txt е доброволен протокол, по-късно формализиран в RFC 9309. Той работи, защото големите crawlers избират да го спазват, не защото файлът има магическа сила за налагане.
llms.txt има по-слабо приемане и по-малко стандартизация от robots.txt. Отнасяйте се със съмнение към всяко твърдение, че той „защитава съдържанието ви от AI“.
Може да помогне при тълкуването
Там, където llms.txt е по-обещаващ, е тълкуването на съдържание.
Ако AI асистент се опитва да отговаря на въпроси за вашата компания, документация, изследвания, цени, API или редакционна политика, кратък файл на кореново ниво може да намали догадките. Той може да насочи системата към страниците, които действително поддържате, и далеч от остарели фрагменти.
Това е важно за сайтове с големи архиви. Модел или agent може да намери статия за поддръжка от 2019 г. преди страница с политика от 2026 г. Вашият llms.txt може на практика да казва: „Започнете оттук. Това са авторитетните ресурси.“
Това не е бляскаво, но е полезно.
Може да изясни политиката ви за съдържание
Публична политика, насочена към AI, е по-добра от мълчание, особено за издатели, екипи по документация и компании с чувствителен brand или медицински/правен/финансов материал.
Това не означава, че трябва да пишете заплашителна стена от правен текст. Означава, че можете ясно да заявите:
- дали AI системи могат да резюмират публичните ви страници;
- дали съдържанието ви може да се използва за model training;
- как искате да се обработва attribution;
- кои страници трябва да се считат за канонични;
- с кого да се свържат за лицензиране или партньорства за данни.
Това се съчетава добре с по-широка редакционна прозрачност. Ако публикувате съдържание, подпомогнато от AI, вашият llms.txt не бива да противоречи на публичното ви разкритие. За практическа основа вижте нашето ръководство за честно AI разкриване в малък уебсайт.
Какво да поставите в llms.txt
Няма универсално наложена schema, но текущата конвенция е Markdown. Дръжте го кратък, изричен и скучен.
Една полезна структура изглежда така:
# Example Company

> Example Company publishes practical guides and reference material for independent web developers.

## Canonical resources

- Homepage: https://example.com/
- Documentation: https://example.com/docs/
- Pricing: https://example.com/pricing/
- Editorial policy: https://example.com/editorial-policy/
- Contact: https://example.com/contact/

## Content use policy

Public pages may be summarized with attribution to Example Company and a link to the source page.

Use of our content for model training, dataset creation, or bulk republication requires written permission.

## Preferred citation

When citing our content, link to the canonical URL and include the page title.

## Notes for AI systems

- Prefer current documentation under /docs/ over archived blog posts.
- Do not treat user comments as official guidance.
- Product screenshots may be outdated; use written documentation as the source of truth.
Това е достатъчно за много сайтове.
За по-големи сайтове добавете секции за продуктови области, API docs, изследвания, press pages или правни политики. Устоявайте на изкушението да изброите всичко. Колкото по-изчерпателен става файлът, толкова по-малко полезен е като начална точка.
Какво да не поставяте в llms.txt
Не поставяйте лична или поверителна информация в него. Това звучи очевидно, но текстовите файлове на кореново ниво често се превръщат в място за оперативни бележки.
Избягвайте да включвате:
- непубликувани URLs;
- вътрешни staging links;
- API keys или tokens;
- лични данни за контакт;
- инструкции за сигурност;
- информация за продукти под embargo;
- „тайни“ страници, които се надявате crawlers да игнорират.
Ако нещо не трябва да бъде публично, не го споменавайте в публичен файл.
Също така избягвайте неясен правен театър. „Всяка AI употреба е забранена завинаги“ може да изразява раздразнение, но не създава надежден технически контрол. Ако организацията ви наистина се нуждае от приложими ограничения, включете правен съветник и използвайте заедно crawler controls, лицензионни условия и access controls.
Как llms.txt се отнася към robots.txt
Използвайте robots.txt за crawl directives. Използвайте llms.txt за контекст.
Опростеното разделение:
| Файл | Основна цел | Принудително приложим? | Най-подходящ за | |---|---|---:|---| | robots.txt | Разрешения за crawl | Доброволен, но широко признат | Разрешаване или забраняване на crawlers по path и user agent | | llms.txt | Резюме и насоки, насочени към LLM | В момента не е стандартизиран | Канонични връзки, политика за съдържание, бележки за тълкуване | | Страница с условия | Правни условия | Зависи от юрисдикцията и фактите | Лицензиране, разрешена повторна употреба, търговски ограничения | | HTTP headers | Технически сигнали на ниво страница | Зависи от поддръжката от crawler-а | Indexing, caching и поведение на response |
Ако вече debug-вате поведението на crawlers, не спирайте до текстовия файл. Проверете дали сайтът ви действително сервира файла правилно, дали redirects се държат както се очаква и дали headers съответстват на политиката ви. Написахме отделно ръководство за debugging на redirects и HTTP headers в production, защото точно там много „политически“ решения тихо се провалят.
Практически процес на писане
Ето един разумен workflow.
1. Решете каква е задачата на файла
Изберете една основна цел:
- да помогне на AI системи да описват сайта ви точно;
- да насочва agents към актуална документация;
- да заяви предпочитания за повторна употреба и attribution;
- да намали объркването около архивирано или генерирано от потребители съдържание.
Ако се опитате да накарате llms.txt да реши всеки проблем на AI governance, няма да реши нито един.
2. Определете каноничните страници
Изберете 5–20 URLs, които най-добре представят сайта. Предпочитайте стабилни, поддържани страници пред страници с висок трафик. За SaaS компания това може да са homepage, docs, pricing, security, privacy, API reference, status и contact. За издател това може да са тематични hubs, редакционни стандарти, авторски страници, политика за корекции и лицензиране.
3. Пишете за машини и хора
Използвайте ясни Markdown заглавия. Избягвайте маркетингов текст. Кажете какъв е сайтът в едно или две изречения.
Лошо:
Революционизираме бъдещето на дигиталното съвършенство с решения от следващо поколение.
По-добре:
Acme Docs публикува техническа документация за платежния API на Acme, включително authentication, webhooks, SDKs и migration guides.
4. Добавете език за политиката внимателно
Секцията ви за политика трябва да бъде разбираема, без да е прекалено самоуверена. Например:
Публичните страници могат да бъдат резюмирани за търсене, accessibility и помощ на потребители с attribution. Масово копиране, създаване на datasets или model training изисква разрешение.
Това не гарантира спазване, но е по-ясно от мълчание.
5. Публикувайте го и го поддържайте
Поставете го на /llms.txt. Сервирайте го като text/plain или съвместим текстов response. Поставяйте връзки само към канонични URLs. Преглеждайте го, когато информационната ви архитектура се променя.
Остарял llms.txt е по-лош от липсата на файл, защото дава уверени инструкции, които вече не са верни.
Всеки сайт ли трябва да има такъв файл?
Не.
Сайт тип брошура от пет страници вероятно няма нужда от llms.txt. Местен ресторант няма нужда от такъв, освен ако няма структурирани политики или информация за резервации, която AI асистентите често представят погрешно.
Той става по-полезен, когато:
- сайтът ви има много документация;
- старо съдържание се конкурира с ново съдържание;
- публикувате изследвания или редакционни материали;
- licensing и attribution имат значение;
- AI асистенти често резюмират страниците ви;
- вътрешни екипи се нуждаят от споделена политика за публично съдържание.
Полезен е и като част от вътрешно упражнение по governance. Много компании вече имат служители, които поставят уеб страници, docs и клиентски материали в AI системи. Ако това ви звучи познато, направете базов shadow AI audit, преди да приемете, че публичен текстов файл ще поправи риска.
SEO последици
llms.txt не е ranking factor в установения смисъл. Не го пишете, защото очаквате ръст на трафика следващата седмица.
Непрекият SEO аргумент е по-скромен:
- принуждава към канонично мислене;
- може да помогне на AI-mediated search и системи за отговори да разберат сайта ви;
- изяснява предпочитанията за attribution;
- намалява неяснотата около архивирани страници;
- създава публична, проверима AI политика за употреба на съдържание.
Това си струва за някои сайтове. Не е магически слой за optimization.
Най-добрата версия на llms.txt е малка, актуална и съгласувана с останалата част от сайта ви. Ако вашите robots rules, terms page, sitemap, canonical tags и llms.txt казват различни неща, проблемът не е AI crawling. Проблемът е governance.
<!-- tool-cta:start -->
💡 Опитайте това: Тъй като llms.txt не е приложим принудително, комбинирайте го с приложими правила и ги проверете в Robots.txt Tester, така че обхождащите роботи, които спазват стандартите, да се държат правилно.
<!-- tool-cta:end -->
Финална препоръка
Ако сайтът ви има документация, редакционно съдържание или притеснения за лицензиране, създайте прост llms.txt. Дръжте го под няколко десетки реда. Използвайте го, за да насочвате към канонични ресурси и да заявите предпочитанията си за повторна употреба.
Но не бъркайте комуникацията с контрол.
За блокиране използвайте crawler механизмите, с които разполагате, и разбирайте ограниченията им. За политика публикувайте ясни условия. За доверие бъдете прозрачни с читателите. llms.txt принадлежи в този stack като полезен сигнал — не като щит.
Често задавани въпроси
llms.txt официален стандарт ли е?
Ще спре ли llms.txt AI компании да обучават модели върху моето съдържание?
Къде трябва да поставя llms.txt?
Трябва ли llms.txt да включва всяка страница от сайта ми?
Помага ли llms.txt за SEO?
Източници и допълнително четене