Як написати llms.txt — і чи він насправді щось робить
Практичний посібник із нового файлу для AI-краулерів, коротких описів контенту та інструкцій сайту для моделей.
Зміст
- Коротка версія
- Яку проблему має розв’язувати llms.txt
- Чи llms.txt насправді щось робить?
- Він не блокує AI-краулерів надійно
- Він може допомогти з інтерпретацією
- Він може прояснити вашу політику щодо контенту
- Що додати в llms.txt
- Чого не варто додавати в llms.txt
- Як llms.txt пов’язаний із robots.txt
- Практичний процес написання
- 1. Визначте завдання файлу
- 2. Визначте канонічні сторінки
- 3. Пишіть для машин і людей
- 4. Обережно додайте формулювання політики
- 5. Опублікуйте і підтримуйте його
- Чи потрібен він кожному сайту?
- Наслідки для SEO
- Фінальна рекомендація
Коротка версія
llms.txt — це нова домовленість про те, як повідомляти великим мовним моделям, що являє собою ваш сайт, які сторінки важливі та як слід розуміти ваш контент. Зазвичай він розміщується за адресою https://example.com/llms.txt, пишеться в Markdown і містить посилання на чисті, корисні ресурси.
Це не те саме, що robots.txt. Це не офіційний вебстандарт. Він не блокує надійно навчання AI. Він не змушує AI-компанію виконувати ваші побажання.
І все ж його може бути варто написати.
Хороший llms.txt — це недорогий спосіб зробити ваш сайт простішим для правильного узагальнення AI-системами, агентами, пошуковими асистентами та внутрішніми інструментами. Це також дисциплінує: вам доведеться вирішити, який контент є канонічним, який застарів і які умови застосовуються до повторного використання. Це корисно, навіть якщо наразі файл читають лише кілька систем.
Яку проблему має розв’язувати llms.txt
Більшість вебсайтів створені для людей і пошукових краулерів. Вони містять навігацію, cookie-банери, картки товарів, дублікати сторінок категорій, старі PDF, параметри відстеження та контент, який має сенс лише візуально.
LLM не потрібен той самий презентаційний шар. Їм потрібні:
- стислий опис сайту;
- посилання на найавторитетніші сторінки;
- контекст простою мовою про продукти, документацію, політики або авторство;
- ліцензійні та інші побажання щодо використання;
- вказівники на структуровані або Markdown-версії, якщо вони доступні.
Пропозиція llms.txt запозичує знайому вебідею: розмістити передбачуваний текстовий файл у корені домену. На відміну від robots.txt, який передусім стосується дозволів на сканування, llms.txt здебільшого про орієнтацію.
Думайте про нього як про мапу, а не як про ворота.
Чи llms.txt насправді щось робить?
Сьогодні чесна відповідь така: іноді так, але не так, як багато хто сподівається.
Він не блокує AI-краулерів надійно
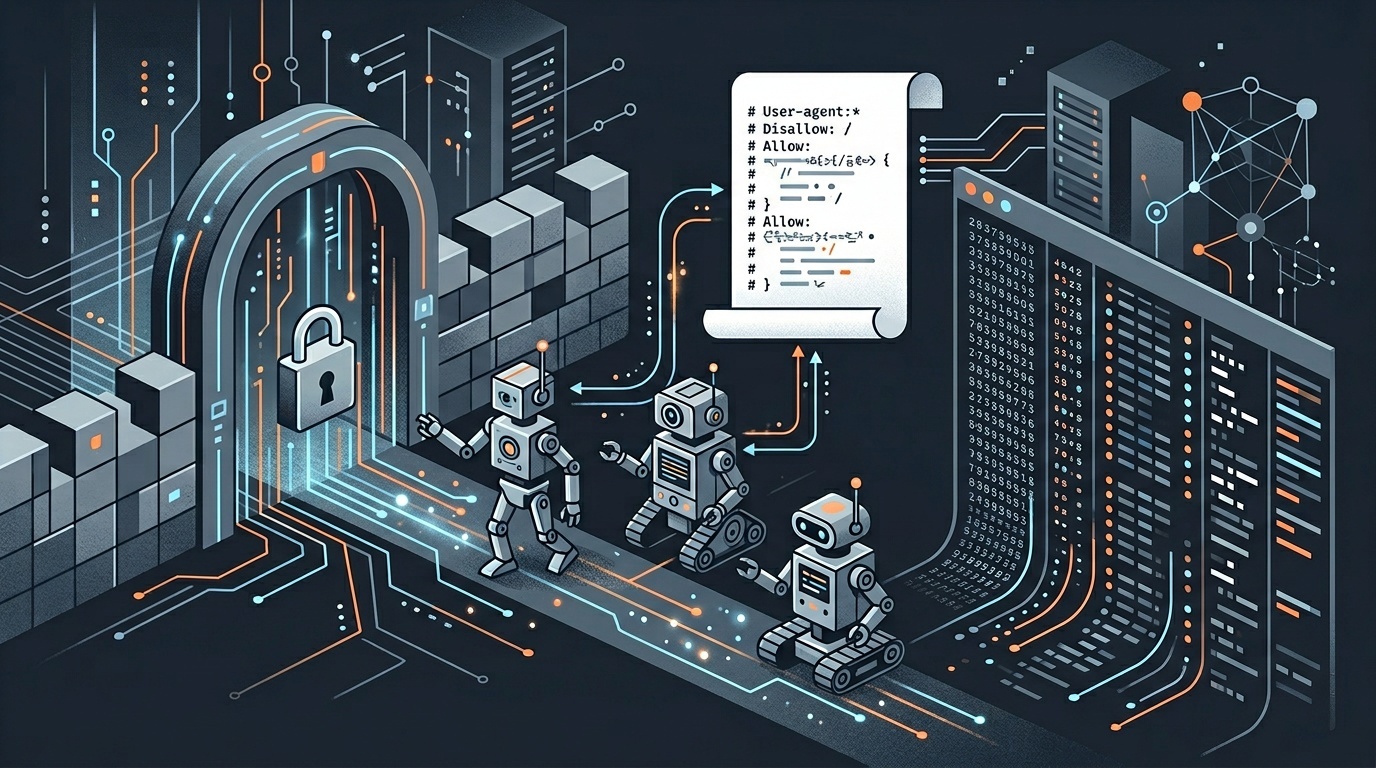
Якщо ваша мета — запобігти скануванню або навчанню, llms.txt не має бути основним механізмом. Краулери, які поважають правила виключення, радше звертатимуть увагу на robots.txt, директиви для конкретних user-agent, HTTP-заголовки або договірні/ліцензійні сигнали. Але навіть тоді дотримання залежить від оператора краулера.
У вебу тут довга історія. Сам robots.txt є добровільним протоколом, пізніше формалізованим у RFC 9309. Він працює тому, що великі краулери вирішують його поважати, а не тому, що файл має магічну силу примусу.
llms.txt має менше впровадження і менше стандартизації, ніж robots.txt. Ставтеся з підозрою до будь-яких тверджень, що він “захищає ваш контент від AI”.
Він може допомогти з інтерпретацією
Там, де llms.txt виглядає перспективніше, — це інтерпретація контенту.
Якщо AI-асистент намагається відповідати на запитання про вашу компанію, документацію, дослідження, ціни, API або редакційну політику, стислий файл у корені сайту може зменшити кількість здогадок. Він може спрямувати систему до сторінок, які ви справді підтримуєте, і відвести її від застарілих фрагментів.
Це важливо для сайтів із великими архівами. Модель або агент може знайти статтю підтримки 2019 року раніше, ніж сторінку політики 2026 року. Ваш llms.txt може фактично сказати: “Починайте тут. Це авторитетні ресурси.”
Це не ефектно, але корисно.
Він може прояснити вашу політику щодо контенту
Публічна політика для AI краща за мовчання, особливо для видавців, команд документації і компаній із чутливими бренд-матеріалами або медичним/юридичним/фінансовим контентом.
Це не означає, що слід писати загрозливу стіну юридичного тексту. Це означає, що ви можете прямо зазначити:
- чи можуть AI-системи узагальнювати ваші публічні сторінки;
- чи може ваш контент використовуватися для навчання моделей;
- як ви хочете, щоб оформлювали атрибуцію;
- які сторінки слід вважати канонічними;
- до кого звертатися щодо ліцензування або партнерств із даними.
Це добре поєднується з ширшою редакційною прозорістю. Якщо ви публікуєте контент, створений за допомогою AI, ваш llms.txt не має суперечити вашому публічному розкриттю. Як практичну основу див. наш посібник про чесне розкриття використання AI на невеликому сайті.
Що додати в llms.txt
Універсально примусової схеми немає, але поточна домовленість — Markdown. Пишіть коротко, прямо і без зайвого блиску.
Корисна структура виглядає так:
# Example Company

> Example Company publishes practical guides and reference material for independent web developers.

## Canonical resources

- Homepage: https://example.com/
- Documentation: https://example.com/docs/
- Pricing: https://example.com/pricing/
- Editorial policy: https://example.com/editorial-policy/
- Contact: https://example.com/contact/

## Content use policy

Public pages may be summarized with attribution to Example Company and a link to the source page.

Use of our content for model training, dataset creation, or bulk republication requires written permission.

## Preferred citation

When citing our content, link to the canonical URL and include the page title.

## Notes for AI systems

- Prefer current documentation under /docs/ over archived blog posts.
- Do not treat user comments as official guidance.
- Product screenshots may be outdated; use written documentation as the source of truth.
Цього достатньо для багатьох сайтів.
Для більших сайтів додайте розділи для продуктових напрямів, API-документації, досліджень, сторінок для преси або юридичних політик. Утримайтеся від бажання перелічити все. Що повнішим стає файл, то менш корисним він є як стартова точка.
Чого не варто додавати в llms.txt
Не додавайте до нього приватну інформацію. Це звучить очевидно, але текстові файли в корені сайту часто стають місцем для операційних нотаток.
Уникайте включення:
- неопублікованих URL;
- внутрішніх staging-посилань;
- API-ключів або токенів;
- приватних контактних даних;
- інструкцій із безпеки;
- ембаргованої інформації про продукт;
- “секретних” сторінок, які, як ви сподіваєтеся, краулери проігнорують.
Якщо щось не має бути публічним, не згадуйте це в публічному файлі.
Також уникайте розпливчастого юридичного театру. “Будь-яке використання AI заборонено назавжди” може виражати роздратування, але не створює надійного технічного контролю. Якщо вашій організації справді потрібні обов’язкові до виконання обмеження, залучіть юристів і використовуйте разом керування краулерами, ліцензійні умови та контроль доступу.
Як llms.txt пов’язаний із robots.txt
Використовуйте robots.txt для директив сканування. Використовуйте llms.txt для контексту.
Спрощений поділ:
| Файл | Основна мета | Обов’язковість виконання? | Найкраще використовувати для | |---|---|---:|---| | robots.txt | Дозволи на сканування | Добровільний, але широко визнаний | Дозволу або заборони краулерів за шляхом і user agent | | llms.txt | Короткий опис і настанови для LLM | Наразі не стандартизований | Канонічних посилань, політики щодо контенту, нотаток з інтерпретації | | Сторінка умов | Юридичні умови | Залежить від юрисдикції та фактів | Ліцензування, дозволеного повторного використання, комерційних обмежень | | HTTP-заголовки | Технічні сигнали на рівні сторінки | Залежить від підтримки краулером | Індексації, кешування та поведінки відповіді |
Якщо ви вже налагоджуєте поведінку краулерів, не зупиняйтеся на текстовому файлі. Перевірте, чи ваш сайт справді коректно віддає файл, чи редиректи поводяться очікувано і чи заголовки відповідають вашій політиці. Ми написали окремий посібник із налагодження редиректів і HTTP-заголовків у production, бо саме тут багато “політичних” рішень тихо ламаються.
Практичний процес написання
Ось розумний робочий процес.
1. Визначте завдання файлу
Оберіть одну основну мету:
- допомогти AI-системам точно описувати ваш сайт;
- спрямовувати агентів до актуальної документації;
- зафіксувати побажання щодо повторного використання й атрибуції;
- зменшити плутанину навколо архівного або створеного користувачами контенту.
Якщо ви спробуєте змусити llms.txt розв’язати кожну проблему AI-врядування, він не розв’яже жодної.
2. Визначте канонічні сторінки
Оберіть 5–20 URL, які найкраще представляють сайт. Надавайте перевагу стабільним, підтримуваним сторінкам, а не сторінкам із високим трафіком. Для SaaS-компанії це можуть бути головна сторінка, документація, ціни, безпека, приватність, довідник API, статус і контакти. Для видавця — тематичні хаби, редакційні стандарти, сторінки авторів, політика виправлень і ліцензування.
3. Пишіть для машин і людей
Використовуйте прості заголовки Markdown. Уникайте маркетингового тексту. Скажіть, що таке сайт, одним-двома реченнями.
Погано:
Ми революціонізуємо майбутнє цифрової досконалості рішеннями нового покоління.
Краще:
Acme Docs публікує технічну документацію для платіжного API Acme, включно з автентифікацією, webhooks, SDKs і посібниками з міграції.
4. Обережно додайте формулювання політики
Розділ політики має бути зрозумілим без надмірної самовпевненості. Наприклад:
Публічні сторінки можуть узагальнюватися для пошуку, доступності та допомоги користувачам з атрибуцією. Масове копіювання, створення датасетів або навчання моделей потребує дозволу.
Це не гарантує дотримання, але є чіткішим за мовчання.
5. Опублікуйте і підтримуйте його
Розмістіть його за адресою /llms.txt. Віддавайте його як text/plain або сумісну текстову відповідь. Посилайтеся лише на канонічні URL. Переглядайте його, коли змінюється ваша інформаційна архітектура.
Застарілий llms.txt гірший за відсутність файлу, бо дає впевнені інструкції, які вже не відповідають дійсності.
Чи потрібен він кожному сайту?
Ні.
П’ятисторінковому сайту-брошурі, ймовірно, не потрібен llms.txt. Місцевому ресторану він не потрібен, якщо тільки він не має структурованих політик або інформації про бронювання, яку AI-асистенти часто викладають неправильно.
Він стає кориснішим, коли:
- на вашому сайті багато документації;
- старий контент конкурує з новим;
- ви публікуєте дослідження або редакційні матеріали;
- ліцензування й атрибуція важливі;
- AI-асистенти часто узагальнюють ваші сторінки;
- внутрішнім командам потрібна спільна політика для публічного контенту.
Він також корисний як частина внутрішньої вправи з врядування. У багатьох компаніях працівники вже вставляють вебсторінки, документацію та клієнтські матеріали в AI-системи. Якщо це звучить знайомо, проведіть базовий аудит shadow AI, перш ніж припускати, що публічний текстовий файл виправить ризик.
Наслідки для SEO
llms.txt не є фактором ранжування в жодному усталеному сенсі. Не пишіть його, якщо очікуєте приріст трафіку вже наступного тижня.
Непрямий SEO-аргумент скромніший:
- він змушує мислити канонічно;
- він може допомогти AI-опосередкованим пошуковим і відповідальним системам зрозуміти ваш сайт;
- він прояснює побажання щодо атрибуції;
- він зменшує неоднозначність навколо архівних сторінок;
- він створює публічну, придатну для перевірки політику використання AI-контенту.
Для деяких сайтів це варте зусиль. Але це не магічний шар оптимізації.
Найкраща версія llms.txt — невелика, актуальна і узгоджена з рештою вашого сайту. Якщо ваші правила robots, сторінка умов, sitemap, canonical tags і llms.txt говорять різне, проблема не в AI-скануванні. Проблема у врядуванні.
<!-- tool-cta:start -->
💡 Спробуйте це: Оскільки llms.txt не можна примусово застосувати, поєднайте його з правилами, які можна примусово застосувати, і перевірте їх у Robots.txt Tester, щоб сканери, які дотримуються стандартів, поводилися правильно.
<!-- tool-cta:end -->
Фінальна рекомендація
Якщо ваш сайт має документацію, редакційний контент або питання ліцензування, створіть простий llms.txt. Тримайте його в межах кількох десятків рядків. Використовуйте його, щоб вказати на канонічні ресурси і сформулювати побажання щодо повторного використання.
Але не плутайте комунікацію з контролем.
Для блокування використовуйте доступні вам механізми для краулерів і розумійте їхні межі. Для політики публікуйте чіткі умови. Для довіри будьте прозорими з читачами. llms.txt належить до цього набору як корисний сигнал — не як щит.
Часто задавані питання
Чи є llms.txt офіційним стандартом?
Чи зупинить llms.txt AI-компанії від навчання на моєму контенті?
Де слід розмістити llms.txt?
Чи має llms.txt містити кожну сторінку мого сайту?
Чи допомагає llms.txt із SEO?
Джерела та подальше читання