Как написать llms.txt — и делает ли он вообще что-нибудь
Практическое руководство по появляющемуся файлу для AI-краулеров, кратких описаний контента и инструкций для моделей о сайте.
Содержание
- Краткая версия
- Какую задачу должен решать llms.txt
- Действительно ли llms.txt что-то делает?
- Он не блокирует AI-краулеры надежным образом
- Он может помочь с интерпретацией
- Он может прояснить вашу политику в отношении контента
- Что поместить в llms.txt
- Что не стоит помещать в llms.txt
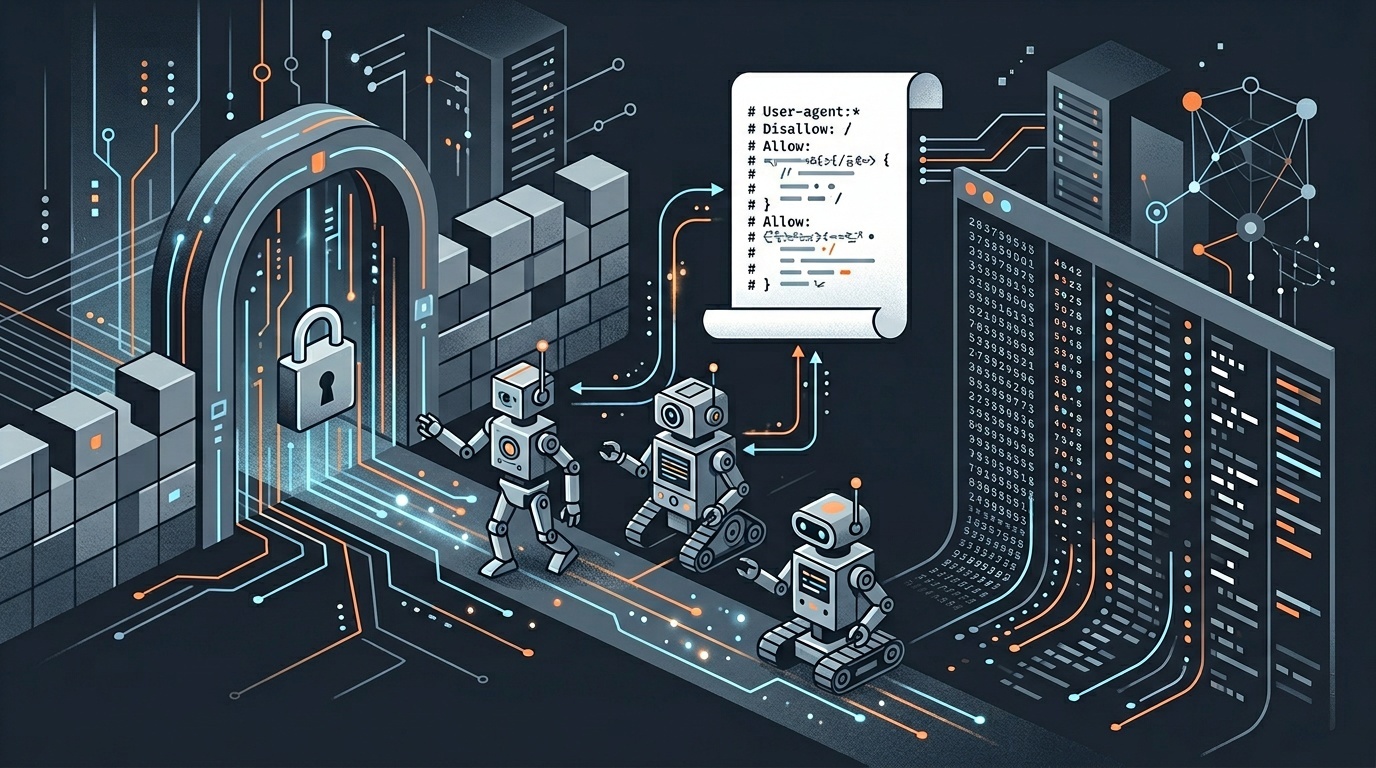
- Как llms.txt соотносится с robots.txt
- Практический процесс написания
- 1. Определите задачу файла
- 2. Определите канонические страницы
- 3. Пишите для машин и людей
- 4. Осторожно добавляйте формулировки политики
- 5. Опубликуйте и поддерживайте его
- Должен ли он быть у каждого сайта?
- SEO-последствия
- Финальная рекомендация
Краткая версия
llms.txt — это формирующаяся конвенция для того, чтобы сообщать большим языковым моделям, что представляет собой ваш сайт, какие страницы важны и как следует понимать ваш контент. Обычно он находится по адресу https://example.com/llms.txt, пишется в Markdown и содержит ссылки на чистые, полезные ресурсы.
Это не то же самое, что robots.txt. Это не официальный веб-стандарт. Он не блокирует AI-обучение надежным образом. Он не заставляет AI-компанию следовать вашим пожеланиям.
И все же его может иметь смысл написать.
Хороший llms.txt — это недорогой способ упростить AI-системам, агентам, поисковым ассистентам и внутренним инструментам корректное резюмирование вашего сайта. Это также дисциплинирующий механизм: вам придется решить, какой контент является каноническим, какой устарел и какие условия применяются к повторному использованию. Это полезно, даже если сейчас файл читают лишь немногие системы.
Какую задачу должен решать llms.txt
Большинство сайтов создаются для людей и поисковых краулеров. Они содержат навигацию, cookie-баннеры, карточки продуктов, дублирующиеся страницы категорий, старые PDF, параметры отслеживания и контент, который имеет смысл только визуально.
LLM не нужен тот же слой представления. Им нужны:
- краткое описание сайта;
- ссылки на наиболее авторитетные страницы;
- контекст простым языком о продуктах, документации, политиках или авторстве;
- лицензирование и предпочтения по использованию;
- указатели на структурированные или Markdown-версии, если они доступны.
Предложение llms.txt заимствует знакомую веб-идею: разместить предсказуемый текстовый файл в корне домена. В отличие от robots.txt, который в первую очередь касается разрешений на сканирование, llms.txt в основном про ориентацию.
Думайте о нем как о карте, а не как о воротах.
Действительно ли llms.txt что-то делает?
Сегодня честный ответ: иногда да, но не так, как многие надеются.
Он не блокирует AI-краулеры надежным образом
Если ваша цель — предотвратить сканирование или обучение, llms.txt — неверный основной механизм. Краулеры, которые соблюдают правила исключения, скорее обратят внимание на robots.txt, специальные директивы user-agent, HTTP-заголовки или договорные/лицензионные сигналы. Но и тогда соблюдение зависит от оператора краулера.
У веба здесь длинная история. Сам robots.txt — добровольный протокол, позднее формализованный в RFC 9309. Он работает потому, что крупные краулеры решают его соблюдать, а не потому, что файл обладает магической силой принуждения.
У llms.txt меньше внедрения и меньше стандартизации, чем у robots.txt. Относитесь с подозрением к любым заявлениям, что он “защищает ваш контент от AI”.
Он может помочь с интерпретацией
Где llms.txt выглядит более перспективным, так это в интерпретации контента.
Если AI-ассистент пытается ответить на вопросы о вашей компании, документации, исследованиях, ценах, API или редакционной политике, краткий файл на корневом уровне может уменьшить количество догадок. Он может направить систему к страницам, которые вы действительно поддерживаете, и увести от устаревших фрагментов.
Это важно для сайтов с большими архивами. Модель или агент может найти статью поддержки 2019 года раньше страницы политики 2026 года. Ваш llms.txt может фактически сказать: “Начинайте здесь. Это авторитетные ресурсы.”
Это не эффектно, но полезно.
Он может прояснить вашу политику в отношении контента
Публичная политика, обращенная к AI, лучше молчания, особенно для издателей, команд документации и компаний с чувствительными брендовыми, медицинскими, юридическими или финансовыми материалами.
Это не значит, что нужно писать угрожающую стену юридического текста. Это значит, что вы можете прямо указать:
- могут ли AI-системы резюмировать ваши публичные страницы;
- можно ли использовать ваш контент для обучения моделей;
- как вы хотите, чтобы оформлялась атрибуция;
- какие страницы следует считать каноническими;
- к кому обращаться по вопросам лицензирования или партнерств по данным.
Это хорошо сочетается с более широкой редакционной прозрачностью. Если вы публикуете контент, созданный с помощью AI, ваш llms.txt не должен противоречить вашему публичному раскрытию. В качестве практической основы см. наше руководство по честному раскрытию использования AI на небольшом сайте.
Что поместить в llms.txt
Универсально обязательной схемы нет, но текущая конвенция — Markdown. Делайте его коротким, явным и скучным.
Полезная структура выглядит так:
# Example Company

> Example Company publishes practical guides and reference material for independent web developers.

## Canonical resources

- Homepage: https://example.com/
- Documentation: https://example.com/docs/
- Pricing: https://example.com/pricing/
- Editorial policy: https://example.com/editorial-policy/
- Contact: https://example.com/contact/

## Content use policy

Public pages may be summarized with attribution to Example Company and a link to the source page.

Use of our content for model training, dataset creation, or bulk republication requires written permission.

## Preferred citation

When citing our content, link to the canonical URL and include the page title.

## Notes for AI systems

- Prefer current documentation under /docs/ over archived blog posts.
- Do not treat user comments as official guidance.
- Product screenshots may be outdated; use written documentation as the source of truth.
Этого достаточно для многих сайтов.
Для более крупных сайтов добавьте разделы для продуктовых направлений, API-документации, исследований, пресс-страниц или юридических политик. Сопротивляйтесь желанию перечислить все. Чем более исчерпывающим становится файл, тем менее полезен он как отправная точка.
Что не стоит помещать в llms.txt
Не помещайте в него приватную информацию. Это звучит очевидно, но текстовые файлы на корневом уровне часто превращаются в свалку операционных заметок.
Избегайте включать:
- неопубликованные URL;
- внутренние staging-ссылки;
- API-ключи или токены;
- частные контактные данные;
- инструкции по безопасности;
- информацию о продуктах под эмбарго;
- “секретные” страницы, которые, как вы надеетесь, краулеры проигнорируют.
Если что-то не должно быть публичным, не упоминайте это в публичном файле.
Также избегайте расплывчатого юридического театра. “Любое использование AI запрещено навсегда” может выражать раздражение, но не создает надежного технического контроля. Если вашей организации действительно нужны обязательные к исполнению ограничения, привлеките юриста и используйте вместе средства управления краулерами, лицензионные условия и контроль доступа.
Как llms.txt соотносится с robots.txt
Используйте robots.txt для директив сканирования. Используйте llms.txt для контекста.
Упрощенное разделение:
| File | Main purpose | Enforceable? | Best used for | |---|---|---:|---| | robots.txt | Разрешения на сканирование | Добровольно, но широко признано | Разрешение или запрет краулеров по пути и user agent | | llms.txt | Резюме и инструкции для LLM | В настоящее время не стандартизировано | Канонические ссылки, политика контента, заметки по интерпретации | | Terms page | Юридические условия | Зависит от юрисдикции и обстоятельств | Лицензирование, разрешенное повторное использование, коммерческие ограничения | | HTTP headers | Технические сигналы на уровне страницы | Зависит от поддержки краулером | Индексация, кэширование и поведение ответа |
Если вы уже отлаживаете поведение краулеров, не останавливайтесь на текстовом файле. Проверьте, действительно ли ваш сайт корректно отдает файл, ведут ли себя редиректы как ожидается и соответствуют ли заголовки вашей политике. Мы написали отдельное руководство по отладке редиректов и HTTP-заголовков в production, потому что именно здесь многие “политические” решения незаметно ломаются.
Практический процесс написания
Вот разумный рабочий процесс.
1. Определите задачу файла
Выберите одну основную цель:
- помочь AI-системам точно описывать ваш сайт;
- направлять агентов к актуальной документации;
- указать предпочтения по повторному использованию и атрибуции;
- уменьшить путаницу вокруг архивного или пользовательского контента.
Если вы попытаетесь заставить llms.txt решить все проблемы управления AI, он не решит ни одной.
2. Определите канонические страницы
Выберите 5–20 URL, которые лучше всего представляют сайт. Предпочитайте стабильные, поддерживаемые страницы страницам с высоким трафиком. Для SaaS-компании это могут быть главная страница, документация, цены, безопасность, конфиденциальность, API-справочник, статус и контакты. Для издателя — тематические хабы, редакционные стандарты, страницы авторов, политика исправлений и лицензирование.
3. Пишите для машин и людей
Используйте простые Markdown-заголовки. Избегайте маркетинговых формулировок. Скажите, что представляет собой сайт, в одном-двух предложениях.
Плохо:
Мы революционизируем будущее цифрового совершенства с помощью решений нового поколения.
Лучше:
Acme Docs публикует техническую документацию для платежного API Acme, включая аутентификацию, webhooks, SDKs и руководства по миграции.
4. Осторожно добавляйте формулировки политики
Раздел с политикой должен быть понятным, но не чрезмерно самоуверенным. Например:
Публичные страницы могут резюмироваться для поиска, доступности и помощи пользователям с атрибуцией. Массовое копирование, создание наборов данных или обучение моделей требует разрешения.
Это не гарантирует соблюдение, но яснее, чем молчание.
5. Опубликуйте и поддерживайте его
Разместите его по адресу /llms.txt. Отдавайте его как text/plain или совместимый текстовый ответ. Ссылайтесь только на канонические URL. Пересматривайте его, когда меняется ваша информационная архитектура.
Устаревший llms.txt хуже, чем отсутствие файла, потому что он дает уверенные инструкции, которые больше не соответствуют действительности.
Должен ли он быть у каждого сайта?
Нет.
Сайту-брошюре из пяти страниц, вероятно, не нужен llms.txt. Местному ресторану он не нужен, если только у него нет структурированных политик или информации о бронировании, которую AI-ассистенты часто искажают.
Он становится полезнее, когда:
- на вашем сайте много документации;
- старый контент конкурирует с новым;
- вы публикуете исследования или редакционные материалы;
- лицензирование и атрибуция имеют значение;
- AI-ассистенты часто резюмируют ваши страницы;
- внутренним командам нужна общая политика для публичного контента.
Он также полезен как часть внутреннего упражнения по управлению. Во многих компаниях сотрудники уже вставляют веб-страницы, документацию и клиентские материалы в AI-системы. Если это звучит знакомо, проведите базовый аудит shadow AI, прежде чем предполагать, что публичный текстовый файл устранит риск.
SEO-последствия
llms.txt не является фактором ранжирования в каком-либо устоявшемся смысле. Не пишите его потому, что ожидаете роста трафика на следующей неделе.
Косвенный SEO-аргумент скромнее:
- он заставляет мыслить канонически;
- он может помочь AI-опосредованному поиску и системам ответов понять ваш сайт;
- он проясняет предпочтения по атрибуции;
- он уменьшает неоднозначность вокруг архивных страниц;
- он создает публичную, проверяемую политику использования AI-контента.
Для некоторых сайтов это ценно. Это не магический слой оптимизации.
Лучшая версия llms.txt — небольшая, актуальная и согласованная с остальным сайтом. Если ваши правила robots, страница условий, sitemap, canonical tags и llms.txt говорят разные вещи, проблема не в AI-сканировании. Проблема в управлении.
<!-- tool-cta:start -->
💡 Попробуйте это: Поскольку llms.txt нельзя принудительно обеспечить, сочетайте его с правилами, которые можно принудительно обеспечить, и проверяйте их в Robots.txt Tester, чтобы краулеры, которые соблюдают стандарты, вели себя правильно.
<!-- tool-cta:end -->
Финальная рекомендация
Если на вашем сайте есть документация, редакционный контент или вопросы лицензирования, создайте простой llms.txt. Держите его в пределах нескольких десятков строк. Используйте его, чтобы указывать на канонические ресурсы и заявлять предпочтения по повторному использованию.
Но не путайте коммуникацию с контролем.
Для блокировки используйте доступные вам механизмы для краулеров и понимайте их ограничения. Для политики публикуйте ясные условия. Для доверия будьте прозрачны с читателями. llms.txt входит в этот набор как полезный сигнал, а не как щит.
Часто задаваемые вопросы
Является ли llms.txt официальным стандартом?
Остановит ли llms.txt AI-компании от обучения на моем контенте?
Где разместить llms.txt?
Должен ли llms.txt включать каждую страницу моего сайта?
Помогает ли llms.txt SEO?
Источники и дальнейшее чтение