Så skriver du llms.txt – och om den faktiskt gör något
En praktisk guide till den framväxande filen för AI-crawlers, innehållssammanfattningar och webbplatsinstruktioner riktade till modeller.
Innehållsförteckning
- Den korta versionen
- Vad llms.txt är tänkt att lösa
- Gör llms.txt faktiskt något?
- Den blockerar inte AI-crawlers på ett tillförlitligt sätt
- Den kan hjälpa till med tolkning
- Den kan förtydliga din innehållspolicy
- Vad du ska lägga i llms.txt
- Vad du inte ska lägga i llms.txt
- Hur llms.txt förhåller sig till robots.txt
- En praktisk skrivprocess
- 1. Bestäm filens uppgift
- 2. Identifiera kanoniska sidor
- 3. Skriv för maskiner och människor
- 4. Lägg till policyspråk varsamt
- 5. Publicera och underhåll den
- Bör varje webbplats ha en?
- SEO-konsekvenser
- En slutlig rekommendation
Den korta versionen
llms.txt är en framväxande konvention för att tala om för stora språkmodeller vad din webbplats är, vilka sidor som är viktiga och hur ditt innehåll bör förstås. Den finns vanligtvis på https://example.com/llms.txt, är skriven i Markdown och länkar till rena, användbara resurser.
Den är inte samma sak som robots.txt. Den är inte en officiell webbstandard. Den blockerar inte AI-träning på ett tillförlitligt sätt. Den tvingar inte ett AI-företag att följa dina önskemål.
Ändå kan den vara värd att skriva.
En bra llms.txt är ett billigt sätt att göra din webbplats enklare för AI-system, agenter, sökassistenter och interna verktyg att sammanfatta korrekt. Den fungerar också som en tvingande övning: du måste bestämma vilket innehåll som är kanoniskt, vilket innehåll som är föråldrat och vilka villkor som gäller för återanvändning. Det är användbart även om bara ett fåtal system för närvarande läser filen.
Vad llms.txt är tänkt att lösa
De flesta webbplatser är byggda för människor och sökcrawlers. De innehåller navigering, cookie-banners, produktkort, duplicerade kategorisidor, gamla PDF:er, spårningsparametrar och innehåll som bara blir begripligt visuellt.
LLM:er behöver inte samma presentationslager. De behöver:
- en kortfattad beskrivning av webbplatsen;
- länkar till de mest auktoritativa sidorna;
- sammanhang på klarspråk om produkter, dokumentation, policyer eller upphov;
- licens- och användningspreferenser;
- hänvisningar till strukturerade versioner eller Markdown-versioner där sådana finns.
Förslaget llms.txt lånar en välbekant webbidé: placera en förutsägbar textfil i domänens rot. Till skillnad från robots.txt, som främst handlar om behörigheter för genomsökning, handlar llms.txt mest om orientering.
Se den som en karta, inte en grind.
Gör llms.txt faktiskt något?
I dag är det ärliga svaret: ibland, men inte på det sätt många hoppas.
Den blockerar inte AI-crawlers på ett tillförlitligt sätt
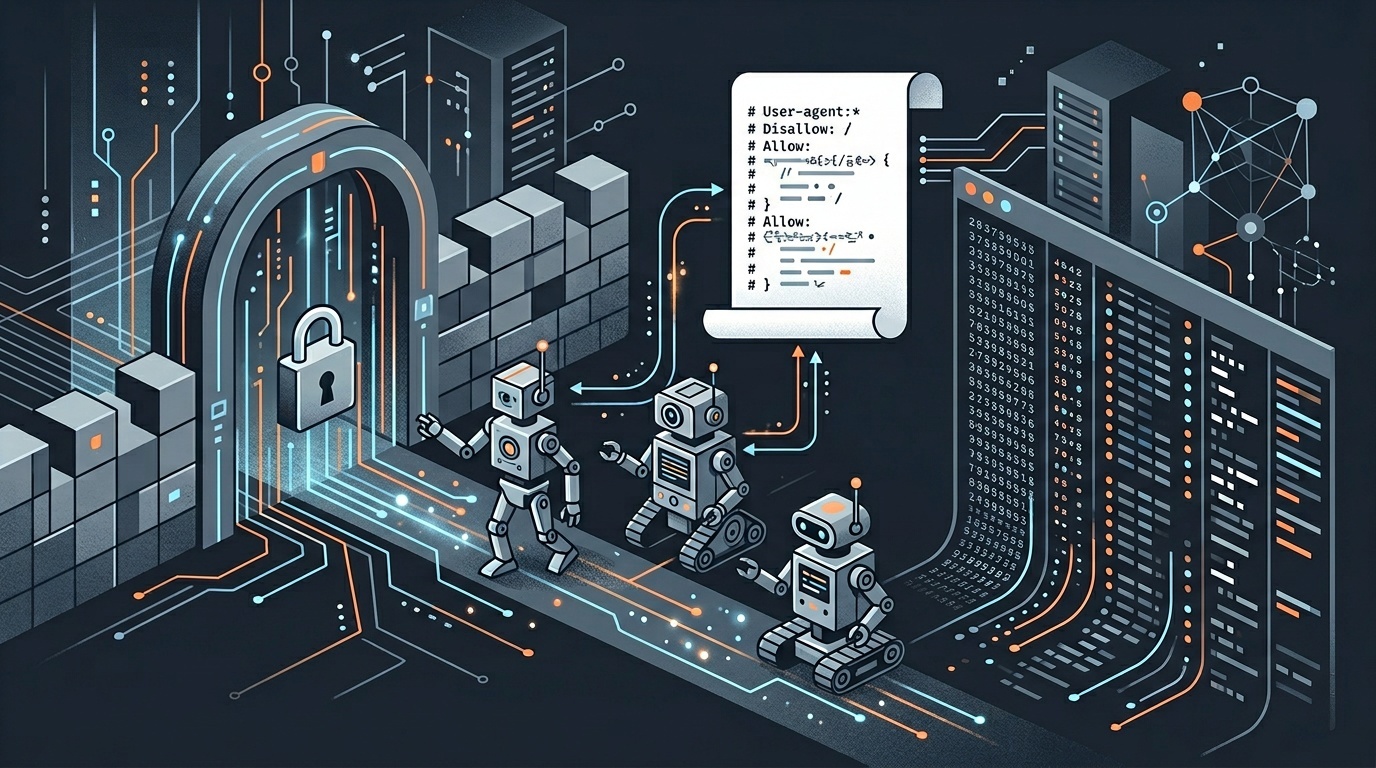
Om ditt mål är att förhindra genomsökning eller träning är llms.txt fel primär mekanism. Crawlers som respekterar exkluderingsregler är mer benägna att titta på robots.txt, specifika user-agent-direktiv, HTTP-headers eller avtals- och licenssignaler. Även då beror efterlevnaden på crawler-operatören.
Webben har en lång historia här. robots.txt är i sig ett frivilligt protokoll, senare formaliserat i RFC 9309. Det fungerar för att stora crawlers väljer att respektera det, inte för att filen har någon magisk verkställighetskraft.
llms.txt har mindre användning och mindre standardisering än robots.txt. Behandla varje påstående om att den ”skyddar ditt innehåll från AI” med skepsis.
Den kan hjälpa till med tolkning
Där llms.txt är mer lovande är innehållstolkning.
Om en AI-assistent försöker svara på frågor om ditt företag, din dokumentation, forskning, prissättning, API eller redaktionella policy kan en kortfattad fil på rotnivå minska gissningar. Den kan peka systemet mot de sidor du faktiskt underhåller och bort från föråldrade fragment.
Detta spelar roll för webbplatser med stora arkiv. En modell eller agent kan hitta en supportartikel från 2019 före en policysida från 2026. Din llms.txt kan i praktiken säga: ”Börja här. Det här är de auktoritativa resurserna.”
Det är inte glamoröst, men det är användbart.
Den kan förtydliga din innehållspolicy
En offentlig AI-riktad policy är bättre än tystnad, särskilt för publicister, dokumentationsteam och företag med känsligt varumärkesmaterial eller medicinskt, juridiskt eller finansiellt material.
Det betyder inte att du ska skriva en hotfull vägg av juridisk text. Det betyder att du kan ange, tydligt:
- om AI-system får sammanfatta dina offentliga sidor;
- om ditt innehåll får användas för modellträning;
- hur du vill att attribution ska hanteras;
- vilka sidor som ska betraktas som kanoniska;
- vem man ska kontakta för licensiering eller datasamarbeten.
Detta fungerar väl tillsammans med bredare redaktionell transparens. Om du publicerar AI-assisterat innehåll bör din llms.txt inte motsäga din offentliga deklaration. För en praktisk grundnivå, se vår guide till ärlig AI-deklaration på en liten webbplats.
Vad du ska lägga i llms.txt
Det finns inget universellt verkställt schema, men den nuvarande konventionen är Markdown. Håll den kort, uttrycklig och tråkig.
En användbar struktur ser ut så här:
# Example Company

> Example Company publishes practical guides and reference material for independent web developers.

## Canonical resources

- Homepage: https://example.com/
- Documentation: https://example.com/docs/
- Pricing: https://example.com/pricing/
- Editorial policy: https://example.com/editorial-policy/
- Contact: https://example.com/contact/

## Content use policy

Public pages may be summarized with attribution to Example Company and a link to the source page.

Use of our content for model training, dataset creation, or bulk republication requires written permission.

## Preferred citation

When citing our content, link to the canonical URL and include the page title.

## Notes for AI systems

- Prefer current documentation under /docs/ over archived blog posts.
- Do not treat user comments as official guidance.
- Product screenshots may be outdated; use written documentation as the source of truth.
Det räcker för många webbplatser.
För större webbplatser kan du lägga till avsnitt för produktområden, API-dokumentation, forskning, pressidor eller juridiska policyer. Motstå frestelsen att lista allt. Ju mer heltäckande filen blir, desto mindre användbar blir den som startpunkt.
Vad du inte ska lägga i llms.txt
Lägg inte privat information i den. Det låter självklart, men textfiler på rotnivå blir ofta avstjälpningsplatser för operativa anteckningar.
Undvik att inkludera:
- opublicerade URL:er;
- interna staging-länkar;
- API-nycklar eller tokens;
- privata kontaktuppgifter;
- säkerhetsinstruktioner;
- produktinformation under embargo;
- ”hemliga” sidor som du hoppas att crawlers ska ignorera.
Om något inte ska vara offentligt ska du inte nämna det i en offentlig fil.
Undvik också vag juridisk teater. ”All AI-användning är förbjuden för alltid” kan uttrycka frustration, men det skapar ingen tillförlitlig teknisk kontroll. Om din organisation verkligen behöver verkställbara begränsningar, involvera juridisk rådgivning och använd crawler-kontroller, licensvillkor och åtkomstkontroller tillsammans.
Hur llms.txt förhåller sig till robots.txt
Använd robots.txt för crawler-direktiv. Använd llms.txt för sammanhang.
En förenklad uppdelning:
| Fil | Huvudsyfte | Verkställbar? | Används bäst för | |---|---|---:|---| | robots.txt | Behörigheter för genomsökning | Frivillig men brett erkänd | Tillåta eller neka crawlers efter sökväg och user agent | | llms.txt | LLM-riktad sammanfattning och vägledning | För närvarande inte standardiserad | Kanoniska länkar, innehållspolicy, tolkningsanteckningar | | Villkor-sida | Juridiska villkor | Beror på jurisdiktion och fakta | Licensiering, tillåten återanvändning, kommersiella begränsningar | | HTTP-headers | Tekniska signaler på sidnivå | Beror på crawler-stöd | Indexering, cachelagring och svarsbeteende |
Om du redan felsöker crawler-beteende, stanna inte vid textfilen. Kontrollera om din webbplats faktiskt serverar filen korrekt, om omdirigeringar beter sig som förväntat och om headers matchar din policy. Vi skrev en separat guide till felsökning av omdirigeringar och HTTP-headers i produktion, eftersom det är här många ”policybeslut” misslyckas i det tysta.
En praktisk skrivprocess
Här är ett rimligt arbetsflöde.
1. Bestäm filens uppgift
Välj ett primärt mål:
- hjälpa AI-system att beskriva din webbplats korrekt;
- vägleda agenter mot aktuell dokumentation;
- ange preferenser för återanvändning och attribution;
- minska förvirring kring arkiverat eller användargenererat innehåll.
Om du försöker få llms.txt att lösa alla AI-styrningsproblem kommer den inte att lösa något av dem.
2. Identifiera kanoniska sidor
Välj de 5–20 URL:er som bäst representerar webbplatsen. Föredra stabila, underhållna sidor framför sidor med mycket trafik. För ett SaaS-företag kan det vara startsidan, dokumentation, prissättning, säkerhet, integritet, API-referens, status och kontakt. För en publicist kan det vara ämneshubbar, redaktionella standarder, författarsidor, rättelsepolicy och licensiering.
3. Skriv för maskiner och människor
Använd tydliga Markdown-rubriker. Undvik marknadsföringstext. Säg vad webbplatsen är i en eller två meningar.
Dåligt:
Vi revolutionerar framtiden för digital excellens med nästa generations lösningar.
Bättre:
Acme Docs publicerar teknisk dokumentation för Acmes betalnings-API, inklusive autentisering, webhooks, SDK:er och migreringsguider.
4. Lägg till policyspråk varsamt
Ditt policyavsnitt bör vara begripligt utan att vara överdrivet självsäkert. Till exempel:
Offentliga sidor får sammanfattas för sök, tillgänglighet och användarstöd med attribution. Masskopiering, skapande av dataset eller modellträning kräver tillstånd.
Det garanterar inte efterlevnad, men det är tydligare än tystnad.
5. Publicera och underhåll den
Placera den på /llms.txt. Servera den som text/plain eller ett kompatibelt textsvar. Länka bara till kanoniska URL:er. Granska den när din informationsarkitektur ändras.
En föråldrad llms.txt är värre än ingen fil, eftersom den ger självsäkra instruktioner som inte längre stämmer.
Bör varje webbplats ha en?
Nej.
En broschyrwebbplats på fem sidor behöver förmodligen inte llms.txt. En lokal restaurang behöver ingen om den inte har strukturerade policyer eller bokningsinformation som AI-assistenter ofta återger felaktigt.
Den blir mer användbar när:
- din webbplats har mycket dokumentation;
- gammalt innehåll konkurrerar med nytt innehåll;
- du publicerar forskning eller redaktionellt material;
- licensiering och attribution spelar roll;
- AI-assistenter ofta sammanfattar dina sidor;
- interna team behöver en gemensam policy för offentligt innehåll.
Den är också användbar som en del av en intern styrningsövning. Många företag har redan anställda som klistrar in webbsidor, dokumentation och kundmaterial i AI-system. Om det låter bekant, gör en grundläggande shadow AI-granskning innan du antar att en offentlig textfil kommer att åtgärda risken.
SEO-konsekvenser
llms.txt är inte en rankingfaktor i någon etablerad mening. Skriv inte en för att du förväntar dig en trafikökning nästa vecka.
Det indirekta SEO-argumentet är mer begränsat:
- den tvingar fram kanoniskt tänkande;
- den kan hjälpa AI-medierade sök- och svarssystem att förstå din webbplats;
- den förtydligar preferenser för attribution;
- den minskar oklarhet kring arkiverade sidor;
- den skapar en offentlig, granskningsbar policy för AI-innehållsanvändning.
Det är värdefullt för vissa webbplatser. Det är inte ett magiskt optimeringslager.
Den bästa versionen av llms.txt är liten, aktuell och i linje med resten av din webbplats. Om dina robots-regler, villkor-sida, sitemap, canonical tags och llms.txt alla säger olika saker är problemet inte AI-genomsökning. Problemet är styrning.
<!-- tool-cta:start -->
💡 Prova detta: Eftersom llms.txt inte kan verkställas, kombinera den med verkställbara regler och kontrollera dem i Robots.txt Tester, så att crawlare som följer standarder beter sig korrekt.
<!-- tool-cta:end -->
En slutlig rekommendation
Om din webbplats har dokumentation, redaktionellt innehåll eller licensieringsfrågor, skapa en enkel llms.txt. Håll den under några dussin rader. Använd den för att peka på kanoniska resurser och ange dina preferenser för återanvändning.
Men blanda inte ihop kommunikation med kontroll.
För blockering, använd de crawler-mekanismer som finns tillgängliga för dig och förstå deras begränsningar. För policy, publicera tydliga villkor. För förtroende, var transparent med läsarna. llms.txt hör hemma i den uppsättningen som en hjälpsam signal – inte som en sköld.
Vanliga frågor
Är llms.txt en officiell standard?
Kommer llms.txt att stoppa AI-företag från att träna på mitt innehåll?
Var ska jag placera llms.txt?
Bör llms.txt innehålla varje sida på min webbplats?
Hjälper llms.txt SEO?
Källor och vidare läsning