Jak psát llms.txt — a jestli vůbec něco dělá
Praktický průvodce vznikajícím souborem pro AI crawlery, souhrny obsahu a instrukce webu určené modelům.
Obsah
- Stručná verze
- Co má llms.txt řešit
- Dělá llms.txt opravdu něco?
- Spolehlivě neblokuje AI crawlery
- Může pomoci s interpretací
- Může vyjasnit vaši obsahovou politiku
- Co do llms.txt vložit
- Co do llms.txt nevkládat
- Jak llms.txt souvisí s robots.txt
- Praktický postup psaní
- 1. Rozhodněte, jakou práci má soubor dělat
- 2. Určete kanonické stránky
- 3. Pište pro stroje i lidi
- 4. Přidávejte formulace politiky opatrně
- 5. Publikujte a udržujte ho
- Měl by ho mít každý web?
- Dopady na SEO
- Závěrečné doporučení
Stručná verze
llms.txt je vznikající konvence, jak velkým jazykovým modelům sdělit, co je váš web zač, které stránky jsou důležité a jak má být váš obsah chápán. Obvykle se nachází na https://example.com/llms.txt, je napsaný v Markdownu a odkazuje na čisté, užitečné zdroje.
Není to totéž co robots.txt. Není to oficiální webový standard. Spolehlivě neblokuje trénování AI. Nenutí AI společnost řídit se vašimi přáními.
Přesto může mít smysl ho napsat.
Dobrý llms.txt je levný způsob, jak AI systémům, agentům, vyhledávacím asistentům a interním nástrojům usnadnit správné shrnutí vašeho webu. Je to také nutící mechanismus: musíte rozhodnout, který obsah je kanonický, který je zastaralý a jaké podmínky platí pro opětovné použití. To je užitečné i tehdy, když soubor v současnosti čte jen několik systémů.
Co má llms.txt řešit
Většina webů je postavena pro lidi a vyhledávací crawlery. Obsahují navigaci, lišty se souhlasem s cookies, produktové karty, duplicitní stránky kategorií, stará PDF, sledovací parametry a obsah, který dává smysl jen vizuálně.
LLM nepotřebují stejnou prezentační vrstvu. Potřebují:
- stručný popis webu;
- odkazy na nejautoritativnější stránky;
- srozumitelný kontext k produktům, dokumentaci, zásadám nebo autorství;
- licenční a uživatelské preference;
- odkazy na strukturované nebo Markdown verze, pokud jsou k dispozici.
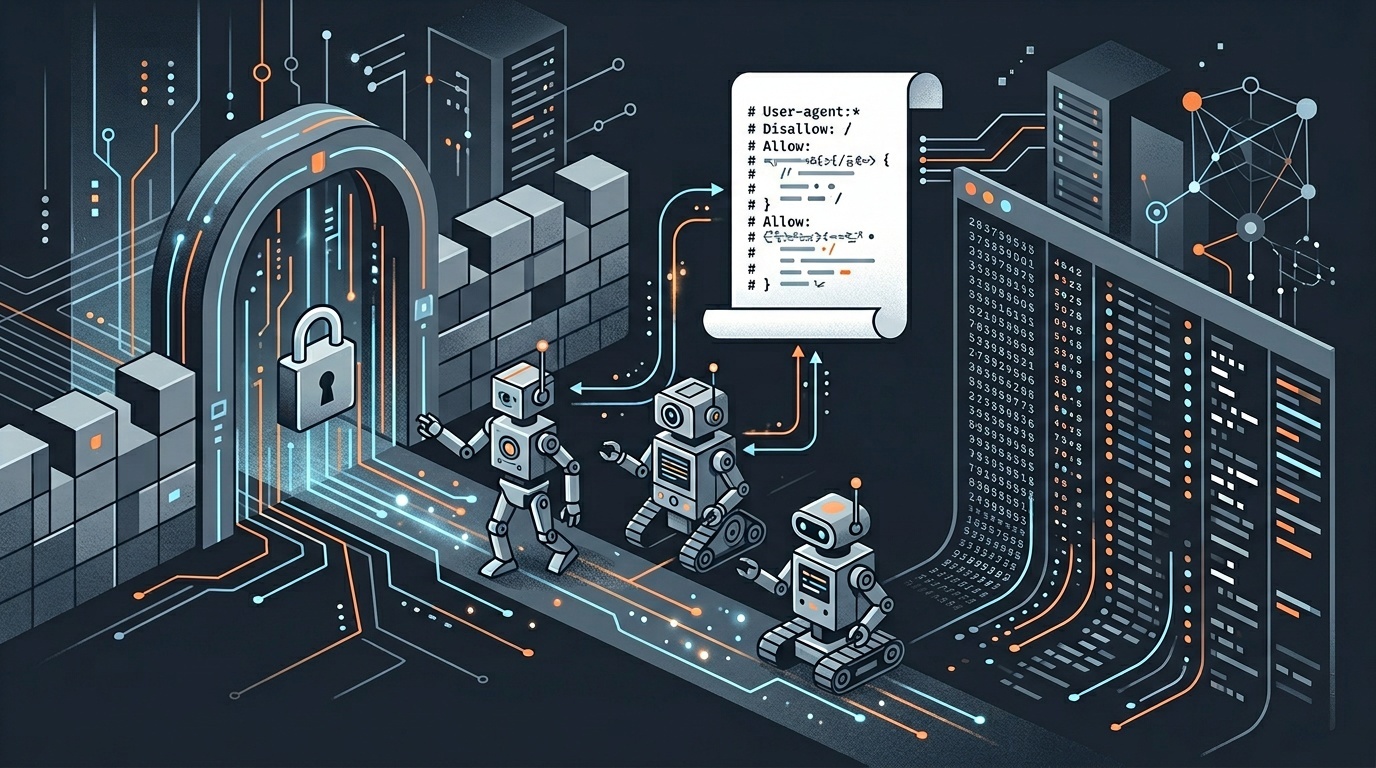
Návrh llms.txt si půjčuje známou webovou myšlenku: umístit předvídatelný textový soubor do kořene domény. Na rozdíl od robots.txt, který se týká především oprávnění ke crawlování, je llms.txt hlavně o orientaci.
Berte ho jako mapu, ne jako bránu.
Dělá llms.txt opravdu něco?
Dnes zní poctivá odpověď: někdy ano, ale ne tak, jak si mnoho lidí přeje.
Spolehlivě neblokuje AI crawlery
Pokud je vaším cílem zabránit crawlování nebo trénování, llms.txt je nesprávný primární mechanismus. Crawlery, které respektují pravidla vyloučení, se spíše podívají na robots.txt, specifické direktivy pro user-agenty, HTTP hlavičky nebo smluvní/licenční signály. I tehdy však dodržování závisí na provozovateli crawleru.
Web má v tomto ohledu dlouhou historii. Samotný robots.txt je dobrovolný protokol, později formalizovaný v RFC 9309. Funguje proto, že se ho hlavní crawlery rozhodly respektovat, ne proto, že by měl soubor magickou vynucovací sílu.
llms.txt má menší přijetí a menší standardizaci než robots.txt. K jakémukoli tvrzení, že „chrání váš obsah před AI“, přistupujte s nedůvěrou.
Může pomoci s interpretací
Slibnější je llms.txt v oblasti interpretace obsahu.
Pokud se AI asistent snaží odpovídat na otázky o vaší společnosti, dokumentaci, výzkumu, cenách, API nebo redakčních zásadách, stručný soubor v kořeni webu může omezit dohady. Může systém nasměrovat na stránky, které skutečně udržujete, a odvést ho od zastaralých útržků.
To je důležité u webů s rozsáhlými archivy. Model nebo agent může najít článek podpory z roku 2019 dříve než stránku se zásadami z roku 2026. Váš llms.txt může v podstatě říct: „Začněte tady. Toto jsou autoritativní zdroje.“
Není to okázalé, ale je to užitečné.
Může vyjasnit vaši obsahovou politiku
Veřejná politika určená pro AI je lepší než mlčení, zvlášť pro vydavatele, dokumentační týmy a společnosti s citlivým značkovým, lékařským, právním nebo finančním materiálem.
Neznamená to, že máte napsat výhrůžnou zeď právního textu. Znamená to, že můžete jasně uvést:
- zda AI systémy mohou shrnovat vaše veřejné stránky;
- zda lze váš obsah používat pro trénování modelů;
- jak chcete řešit atribuci;
- které stránky mají být považovány za kanonické;
- koho kontaktovat kvůli licencování nebo datovým partnerstvím.
Dobře to zapadá do širší redakční transparentnosti. Pokud publikujete obsah vytvořený s pomocí AI, váš llms.txt by neměl být v rozporu s vaším veřejným prohlášením. Praktický základ najdete v našem průvodci poctivým označováním AI na malém webu.
Co do llms.txt vložit
Neexistuje univerzálně vynucované schéma, ale současnou konvencí je Markdown. Držte ho krátký, explicitní a nudný.
Užitečná struktura vypadá takto:
# Example Company

> Example Company publishes practical guides and reference material for independent web developers.

## Canonical resources

- Homepage: https://example.com/
- Documentation: https://example.com/docs/
- Pricing: https://example.com/pricing/
- Editorial policy: https://example.com/editorial-policy/
- Contact: https://example.com/contact/

## Content use policy

Public pages may be summarized with attribution to Example Company and a link to the source page.

Use of our content for model training, dataset creation, or bulk republication requires written permission.

## Preferred citation

When citing our content, link to the canonical URL and include the page title.

## Notes for AI systems

- Prefer current documentation under /docs/ over archived blog posts.
- Do not treat user comments as official guidance.
- Product screenshots may be outdated; use written documentation as the source of truth.
To pro mnoho webů stačí.
U větších webů přidejte sekce pro produktové oblasti, API dokumentaci, výzkum, stránky pro média nebo právní zásady. Odolejte nutkání vypsat všechno. Čím úplnější soubor bude, tím méně užitečný bude jako výchozí bod.
Co do llms.txt nevkládat
Nevkládejte do něj soukromé informace. Zní to samozřejmě, ale textové soubory v kořeni webu se často stávají odkladištěm provozních poznámek.
Vyhněte se uvádění:
- nepublikovaných URL;
- interních odkazů na staging;
- API klíčů nebo tokenů;
- soukromých kontaktních údajů;
- bezpečnostních instrukcí;
- embargovaných produktových informací;
- „tajných“ stránek, o nichž doufáte, že je crawlery budou ignorovat.
Pokud něco nemá být veřejné, nezmiňujte to ve veřejném souboru.
Vyhněte se také vágnímu právnímu divadlu. „Veškeré použití AI je navždy zakázáno“ může vyjadřovat frustraci, ale nevytváří spolehlivou technickou kontrolu. Pokud vaše organizace skutečně potřebuje vymahatelná omezení, zapojte právní poradce a používejte společně crawler controls, licenční podmínky a řízení přístupu.
Jak llms.txt souvisí s robots.txt
Používejte robots.txt pro direktivy crawlování. Používejte llms.txt pro kontext.
Zjednodušené rozdělení:
| Soubor | Hlavní účel | Vymahatelné? | Nejvhodnější použití | |---|---|---:|---| | robots.txt | Oprávnění ke crawlování | Dobrovolné, ale široce uznávané | Povolení nebo zakázání crawlerů podle cesty a user agenta | | llms.txt | Shrnutí a doporučení určené pro LLM | V současnosti nestandardizované | Kanonické odkazy, obsahová politika, poznámky k interpretaci | | Stránka s podmínkami | Právní podmínky | Závisí na jurisdikci a faktech | Licencování, povolené opětovné použití, komerční omezení | | HTTP hlavičky | Technické signály na úrovni stránky | Závisí na podpoře crawleru | Indexování, cachování a chování odpovědi |
Pokud už ladíte chování crawlerů, nezastavujte se u textového souboru. Zkontrolujte, zda váš web soubor skutečně správně servíruje, zda se přesměrování chovají podle očekávání a zda hlavičky odpovídají vaší politice. Napsali jsme samostatného průvodce laděním přesměrování a HTTP hlaviček v produkci, protože právě tady mnoho „politických“ rozhodnutí tiše selhává.
Praktický postup psaní
Tady je rozumný workflow.
1. Rozhodněte, jakou práci má soubor dělat
Vyberte jeden hlavní cíl:
- pomoci AI systémům přesně popsat váš web;
- navést agenty k aktuální dokumentaci;
- uvést preference pro opětovné použití a atribuci;
- snížit zmatek kolem archivovaného nebo uživateli vytvářeného obsahu.
Pokud se pokusíte, aby llms.txt vyřešil každý problém správy AI, nevyřeší žádný.
2. Určete kanonické stránky
Vyberte 5–20 URL, které web nejlépe reprezentují. Upřednostněte stabilní a udržované stránky před stránkami s vysokou návštěvností. U SaaS společnosti to může být domovská stránka, dokumentace, ceny, bezpečnost, soukromí, API reference, status a kontakt. U vydavatele to mohou být tematická centra, redakční standardy, stránky autorů, politika oprav a licencování.
3. Pište pro stroje i lidi
Používejte jednoduché Markdown nadpisy. Vyhněte se marketingovým textům. Jednou nebo dvěma větami řekněte, co web je.
Špatně:
We are revolutionizing the future of digital excellence with next-generation solutions.
Lépe:
Acme Docs publishes technical documentation for Acme’s payments API, including authentication, webhooks, SDKs, and migration guides.
4. Přidávejte formulace politiky opatrně
Sekce s politikou by měla být srozumitelná, aniž by působila přehnaně sebejistě. Například:
Public pages may be summarized for search, accessibility, and user assistance with attribution. Bulk copying, dataset creation, or model training requires permission.
To nezaručuje dodržování, ale je to jasnější než mlčení.
5. Publikujte a udržujte ho
Umístěte ho na /llms.txt. Servírujte ho jako text/plain nebo kompatibilní textovou odpověď. Odkazujte pouze na kanonické URL. Revidujte ho, když se změní vaše informační architektura.
Zastaralý llms.txt je horší než žádný soubor, protože dává sebejisté instrukce, které už nejsou pravdivé.
Měl by ho mít každý web?
Ne.
Pětistránkový prezentační web pravděpodobně llms.txt nepotřebuje. Místní restaurace ho nepotřebuje, pokud nemá strukturované zásady nebo rezervační informace, které AI asistenti často zkreslují.
Užitečnější se stává, když:
- váš web má hodně dokumentace;
- starý obsah soupeří s novým obsahem;
- publikujete výzkumný nebo redakční materiál;
- záleží na licencování a atribuci;
- AI asistenti často shrnují vaše stránky;
- interní týmy potřebují sdílenou politiku pro veřejný obsah.
Je užitečný také jako součást interního cvičení správy. V mnoha firmách už zaměstnanci vkládají webové stránky, dokumenty a zákaznické materiály do AI systémů. Pokud vám to zní povědomě, proveďte základní audit shadow AI, než budete předpokládat, že veřejný textový soubor riziko vyřeší.
Dopady na SEO
llms.txt není rankingovým faktorem v žádném ustáleném smyslu. Nepište ho proto, že příští týden očekáváte nárůst návštěvnosti.
Nepřímý SEO argument je skromnější:
- nutí přemýšlet kanonicky;
- může pomoci vyhledávání zprostředkovanému AI a odpovědním systémům pochopit váš web;
- vyjasňuje preference atribuce;
- snižuje nejednoznačnost kolem archivovaných stránek;
- vytváří veřejnou, kontrolovatelnou politiku používání obsahu AI.
Pro některé weby to má hodnotu. Není to magická optimalizační vrstva.
Nejlepší verze llms.txt je malá, aktuální a sladěná se zbytkem webu. Pokud vaše pravidla pro robots, stránka s podmínkami, sitemap, kanonické značky a llms.txt říkají každý něco jiného, problémem není AI crawlování. Problémem je správa.
<!-- tool-cta:start -->
💡 Vyzkoušejte toto: Protože llms.txt není vymahatelný, spárujte ho s vymahatelnými pravidly a zkontrolujte je v Robots.txt Tester, aby se crawlery, které standardy dodržují, chovaly správně.
<!-- tool-cta:end -->
Závěrečné doporučení
Pokud má váš web dokumentaci, redakční obsah nebo licenční otázky, vytvořte jednoduchý llms.txt. Udržte ho pod několika desítkami řádků. Použijte ho k odkázání na kanonické zdroje a k uvedení preferencí pro opětovné použití.
Nepleťte si ale komunikaci s kontrolou.
Pro blokování používejte mechanismy pro crawlery, které máte k dispozici, a rozumějte jejich limitům. Pro politiku publikujte jasné podmínky. Pro důvěru buďte transparentní vůči čtenářům. llms.txt do této vrstvy patří jako užitečný signál — ne jako štít.
Často kladené otázky
Je llms.txt oficiální standard?
Zabrání llms.txt AI společnostem trénovat na mém obsahu?
Kam mám llms.txt umístit?
Měl by llms.txt obsahovat každou stránku mého webu?
Pomáhá llms.txt SEO?
Zdroje a další čtení