如何撰寫真正能封鎖 AI 擷取器的 robots.txt
一份實用指南:封鎖遵循規範的 AI 爬蟲、理解 robots.txt 的限制,並在關鍵處加入伺服器端控制。
目錄
關於 robots.txt 的不舒服真相
robots.txt 檔案不是鎖。它是門上的告示。
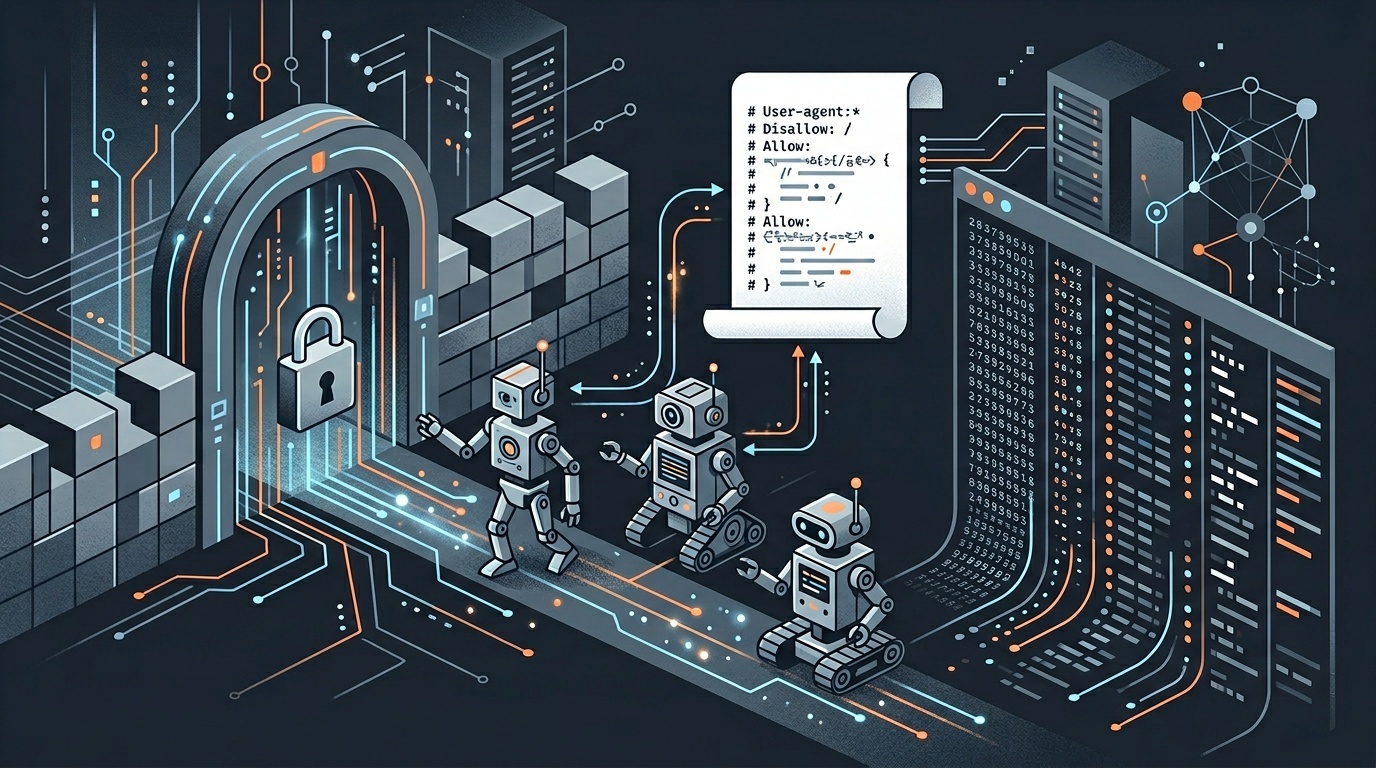
當團隊詢問是否能用一個小小的文字檔「封鎖 AI 擷取器」時,這個差異很重要。對於遵循 Robots Exclusion Protocol 的可靠爬蟲來說,可以:一份正確撰寫的 robots.txt 可以告訴它們不要爬取你的頁面。對於未知的擷取器、冒名者、瀏覽器自動化工具,以及根本不在乎規則的 bot,它本身不會有任何作用。
因此,實務目標不是「讓擷取變得不可能」。而是:
- 告訴遵循規範的 AI 爬蟲不要使用你的網站。
- 避免意外封鎖搜尋引擎或有用的服務。
- 針對濫用行為加入更強的伺服器端控制。
- 隨著爬蟲名稱改變,讓政策維持可維護性。
這是無趣的版本。也是有效的版本。
robots.txt 能做什麼,不能做什麼
robots.txt 檔案位於網站根目錄:
https://example.com/robots.txt爬蟲會在爬取前請求它。檔案包含多組規則。每一組規則以一個或多個 User-agent 行開頭,接著是 Allow 或 Disallow 指令。
一個簡單的全站封鎖如下:
User-agent: GPTBot
Disallow: /
意思是:如果你是 GPTBot,不要爬取這個網站上的任何內容。
但 robots.txt 有明確限制:
- 它是自願性的。惡意行為者可以忽略它。
- 它無法阻止一般瀏覽器或 script 請求某個 URL。
- 它不會移除已在其他地方被收集的內容。
- 它本身不定義著作權、授權或訓練權利。
- 它可能因設定錯誤而封鎖不該封鎖的 bot。
如果你需要真正的存取控制,請使用 authentication、authorization、rate limiting、IP-based controls、bot management 或法律控制。Robots.txt 仍然有用,但它應該屬於更廣泛的內容保護策略。
這類似其他網路治理問題:看得見的控制,通常不是全部的控制。如果你的組織內部已經有未受管理的 AI 使用,同樣的原則也適用;快速做一次 shadow AI audit,往往比假裝單一政策文件能解決問題更有用。
從你的政策決策開始
在編輯檔案之前,先決定你實際上想封鎖什麼。
人們說的「AI 擷取器」至少可能指四種不同東西:
- 用於收集訓練資料的爬蟲。
- AI 搜尋或答案引擎爬蟲。
- 由使用者觸發的擷取器,例如有人要求 AI 產品摘要某個 URL 時。
- 假裝成一般瀏覽器的通用擷取器。
你可能想全部封鎖。也可能想保留搜尋探索,同時選擇退出模型訓練。這些不是同一種政策。
例如,OpenAI 為不同用途記錄了不同的 user agent,包括 GPTBot、ChatGPT-User 和 OAI-SearchBot。Google 使用 Google-Extended 作為部分 Gemini 和 Vertex AI 使用情境的控制 token,而一般 Google Search 爬取則由其他 Googlebot user agent 處理。
這種區分很重要。如果你不謹慎地封鎖寬泛的 user agent,可能會在試圖封鎖 AI 訓練時,傷害一般搜尋能見度。
一份合理的 AI 封鎖 robots.txt 範本
以下是一個保守的起點,用來封鎖幾個常見且有文件記載的 AI 相關爬蟲,同時保留一般搜尋爬蟲:
# AI training and AI product crawlers
User-agent: GPTBot
Disallow: /

User-agent: ChatGPT-User
Disallow: /

User-agent: OAI-SearchBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Claude-Web
Disallow: /

User-agent: PerplexityBot
Disallow: /

User-agent: Amazonbot
Disallow: /

User-agent: Bytespider
Disallow: /

User-agent: Meta-ExternalAgent
Disallow: /

# Default rule for other crawlers
User-agent: *
Allow: /
這不是神奇的通用清單。它是一種可維護的模式。
幾點說明:
Disallow: /的意思是「不要爬取任何路徑」。User-agent: *適用於未被更具體規則匹配的爬蟲。- 對於預設群組,
Allow: /並非嚴格必要,但能清楚表達你的意圖。 - 註解保持簡短。有些解析器很寬容,但 robots.txt 應該保持無聊。
- 不要在 robots.txt 中包含私密 URL。這個檔案是公開的,列出敏感路徑可能等於替它們打廣告。
最後一點值得重複。Robots.txt 不是保密機制。如果 /client-contracts/ 不應該公開,請用 authentication 保護它。不要只是 disallow 它。
小心 Google-Extended
Google-Extended 很容易被誤解。它不等同於封鎖 Google Search。
根據 Google 的文件,Google-Extended 是一個獨立的產品 token,發布者可用來管理網站內容是否能協助改善特定 Gemini 和 Vertex AI 功能。封鎖它本身不應該阻止 Googlebot 為 Search 爬取網站。
也就是說,除非你真的有此意圖,否則不要把所有 Google 指令替換成這種寬泛封鎖:
User-agent: Googlebot
Disallow: /
這會告訴 Google Search 的主要爬蟲不要爬取你的網站。對大多數公開網站來說,這通常不是你想要的結果。
同樣的區分也適用於其他地方。有些供應商會區分訓練爬蟲、使用者觸發的瀏覽爬蟲或 AI 搜尋爬蟲。有些不會。你需要閱讀你在意的 bot 文件,並把你的 robots.txt 視為一個持續更新的檔案,而不是一次性的勾選項目。
像測試正式環境程式碼一樣測試檔案
Robots.txt 看起來很簡單,這也是它容易被弄壞的原因。
常見錯誤包括:
- 上傳到錯誤位置,例如
/assets/robots.txt而不是/robots.txt。 - 使用從文件編輯器複製來的智慧引號。
- 不小心用
User-agent: *和Disallow: /封鎖所有爬蟲。 - 以為某個網域的檔案會套用到另一個子網域。
- 忘記
http://、https://、www和非www主機可能會依設定而有不同處理方式。
對多網域網站來說,請檢查每個 canonical host。位於 https://www.example.com/robots.txt 的 robots 檔案,不會自動管轄 https://app.example.com/robots.txt。
除錯時,請檢查實際 HTTP 回應,而不只是你的 CMS 預覽顯示什麼。你想要的是 200 OK 回應、若可行則使用 text/plain content type,以及你預期的確切檔案。如果涉及 redirects、caching 或 CDN 規則,檢查原始 header 會有幫助。debugging redirects and HTTP headers in production 中的工作流程可以直接套用在這裡。
為忽略規則的 bot 加入伺服器端控制
如果爬蟲遵循規範,robots.txt 是最乾淨的訊號。如果爬蟲有濫用行為,你需要執行層面的控制。
實用控制包括:
Rate limiting
針對異常請求模式設定門檻:每分鐘太多頁面、深層分頁遍歷、重複 404,或來自少數 IP 的高請求量。Rate limits 應該足夠寬鬆,不會懲罰真實使用者,也要足夠嚴格,讓大量擷取變得昂貴。
User-agent filtering
你可以在 web server、reverse proxy、CDN 或 application layer 封鎖有文件記載的 AI 爬蟲 user agent。這比 robots.txt 更強,因為它會回傳實際的拒絕回應。
例如,Nginx 可以封鎖某個 user agent pattern,不過正式環境規則應該仔細測試:
if ($http_user_agent ~* "GPTBot|CCBot|ClaudeBot|Bytespider") {
    return 403;
}
這不是萬無一失。User-agent strings 很容易偽造。但它能擋下誠實或懶散的流量,並降低負載。
IP and ASN controls
有些營運者會公布 IP ranges,但許多擷取器生態系不會。IP-based blocking 可用於明顯濫用,特別是來自沒有正常使用者流量的 cloud hosting ranges,但也可能造成誤判。先看 logs,再寫規則。
Authentication and paywalls
如果內容不應被大規模複製,就不要把完整內容放在公開 URL 上。Robots.txt 不適合用於機密資料、licensed databases、private communities 或 paid archives。
Content minimization
有時最好的保護是架構層面的。若公開頁面只需要小部分內容,就不要暴露不必要的 APIs、大型 JSON payloads、隱藏 metadata、草稿 endpoints 或完整 archives。以圖片為主的網站也應思考自己發布了哪些 metadata;stripping EXIF metadata before sharing photos online 中的隱私邏輯也適用於內容營運。
使用 robots meta tags 設定頁面層級規則
Robots.txt 控制爬取。Robots meta tags 和 X-Robots-Tag headers 則控制遵循規範的搜尋引擎與爬蟲的索引和摘要行為。
例如:
<meta name="robots" content="noindex, noarchive">或作為 HTTP header:
X-Robots-Tag: noindex, noarchive這些不是專屬 AI 的防護盾。當你希望頁面可被存取但不要被索引時,它們很有用。不過,如果你在 robots.txt 中阻止某個爬蟲擷取頁面,它可能永遠看不到頁面層級的 meta tag。不要依賴一個放在禁止爬取 URL 上的 noindex tag。
粗略規則如下:
- 使用 robots.txt 來減少或阻止爬取。
- 使用 meta robots 或
X-Robots-Tag來控制索引行為。 - 使用伺服器端控制來執行存取限制。
發布後監控 logs
發布檔案只是第一步。之後,請檢查你的 logs。
留意:
- 你指定的 user agents 對
/robots.txt的請求。 - 在提供 disallow 規則後仍持續爬取。
- 高流量的可疑 user agents。
- 類似瀏覽器的 user agents 連續請求數千個頁面。
- 對 feeds、sitemaps、search pages 和 pagination 的重複存取。
如果某個 bot 請求 robots.txt、看到完整 disallow,然後停止,robots.txt 就完成了它的工作。如果它繼續,就把那個 bot 移到執行層面:rate limits、blocks 或 authentication。
也請檢視你的 sitemap 暴露情況。Sitemaps 對搜尋引擎有用,但對擷取器來說也是方便的地圖。這不代表你應該從一般網站移除它們。它的意思是,你不該包含不希望公開系統發現的 URL。
讓檔案保持小而且有人審查
Robots.txt 往往會腐壞。行銷團隊新增一個活動 microsite。開發者新增一個 staging path。供應商改了爬蟲名稱。兩年後,沒有人知道一半規則為什麼存在。
把它當成 configuration:
- 可行時,將它存放在 version control 中。
- 為每個 AI 爬蟲群組加上簡短註解。
- 每季檢視一次。
- 新增寬泛規則前,先檢查供應商文件。
- 在 CDN、CMS 或 hosting 變更後進行測試。
如果你的網站發布 AI 協助產出的內容,也請將爬蟲政策與編輯透明度分開。封鎖 AI 擷取器關乎存取與再利用。揭露則關乎讀者信任。兩者在倫理上有重疊,但不是同一種控制。what honest AI disclosure looks like on a small website 中介紹了一種實用的揭露做法。
<!-- tool-cta:start -->
💡 試試這個: 為 AI 爬蟲新增規則後,請使用 Robots.txt Tester 確認語法,以免也意外封鎖合法機器人。
<!-- tool-cta:end -->
重點結論
一份好的 robots.txt 檔案會封鎖遵循規範的 AI 爬蟲。它無法阻止有決心的擷取、被複製的 user-agent strings、遭入侵的瀏覽器,或人們手動把你的內容貼進 AI 系統。
這不代表它沒用。這代表它是一層防護。
為有文件記載的 AI 爬蟲撰寫明確規則。避免會傷害搜尋能見度的寬泛封鎖。測試實際提供的檔案,而不是草稿。觀察 logs。當行為從不受歡迎變成濫用時,用伺服器端控制執行限制。
Web 一直都依靠 protocol、norms 和 enforcement 的混合運作。Robots.txt 是 norms 層。使用它,但不要把它誤認為一堵牆。
常見問題
robots.txt 能阻止 AI 公司用我的內容進行訓練嗎?
我應該封鎖 User-agent: * 來阻止所有擷取器嗎?
Google-Extended 和 Googlebot 一樣嗎?
如果 AI 擷取器忽略 robots.txt 怎麼辦?
我需要同時使用 robots.txt 和 meta robots tags 嗎?
來源與進一步閱讀