Како написати llms.txt — и да ли заиста ишта ради
Практичан водич за нову датотеку за AI кроулере, сажетке садржаја и упутства за сајт намењена моделима.

Sadržaj
- Кратка верзија
- Шта llms.txt треба да реши
- Да ли llms.txt заиста нешто ради?
- Не блокира поуздано AI кроулере
- Може помоћи у тумачењу
- Може разјаснити вашу политику садржаја
- Шта ставити у llms.txt
- Шта не стављати у llms.txt
- Како се llms.txt односи према robots.txt
- Практичан процес писања
- 1. Одлучите шта је посао датотеке
- 2. Идентификујте канонске странице
- 3. Пишите за машине и људе
- 4. Пажљиво додајте језик политике
- 5. Објавите и одржавајте
- Да ли сваки сајт треба да га има?
- SEO импликације
- Завршна препорука
Кратка верзија
llms.txt је конвенција у настајању за саопштавање великим језичким моделима шта је ваш сајт, које странице су важне и како ваш садржај треба разумети. Обично се налази на https://example.com/llms.txt, пише се у Markdown-у и води ка чистим, корисним ресурсима.
То није исто што и robots.txt. Није званични веб стандард. Не блокира поуздано AI training. Не приморава AI компанију да поштује ваше жеље.
Ипак, може вредети да га напишете.
Добар llms.txt је јефтин начин да ваш сајт буде лакши за тачно сажимање AI системима, агентима, асистентима за претрагу и интерним алатима. Он је и корисна дисциплина: морате да одлучите који садржај је канонски, који је застарео и који услови важе за поновну употребу. То је корисно чак и ако тренутно само неколико система чита ову датотеку.
Шта llms.txt треба да реши
Већина сајтова је направљена за људе и кроулере претраживача. Они садрже навигацију, банере за колачиће, картице производа, дуплиране странице категорија, старе PDF-ове, параметре за праћење и садржај који има смисла само визуелно.
LLM-овима није потребан исти презентациони слој. Њима је потребно:
- сажет опис сајта;
- линкови ка најмеродавнијим страницама;
- контекст једноставним језиком о производима, документацији, политикама или ауторству;
- лиценцне и употребне преференције;
- упућивање на структуриране или Markdown верзије, где постоје.
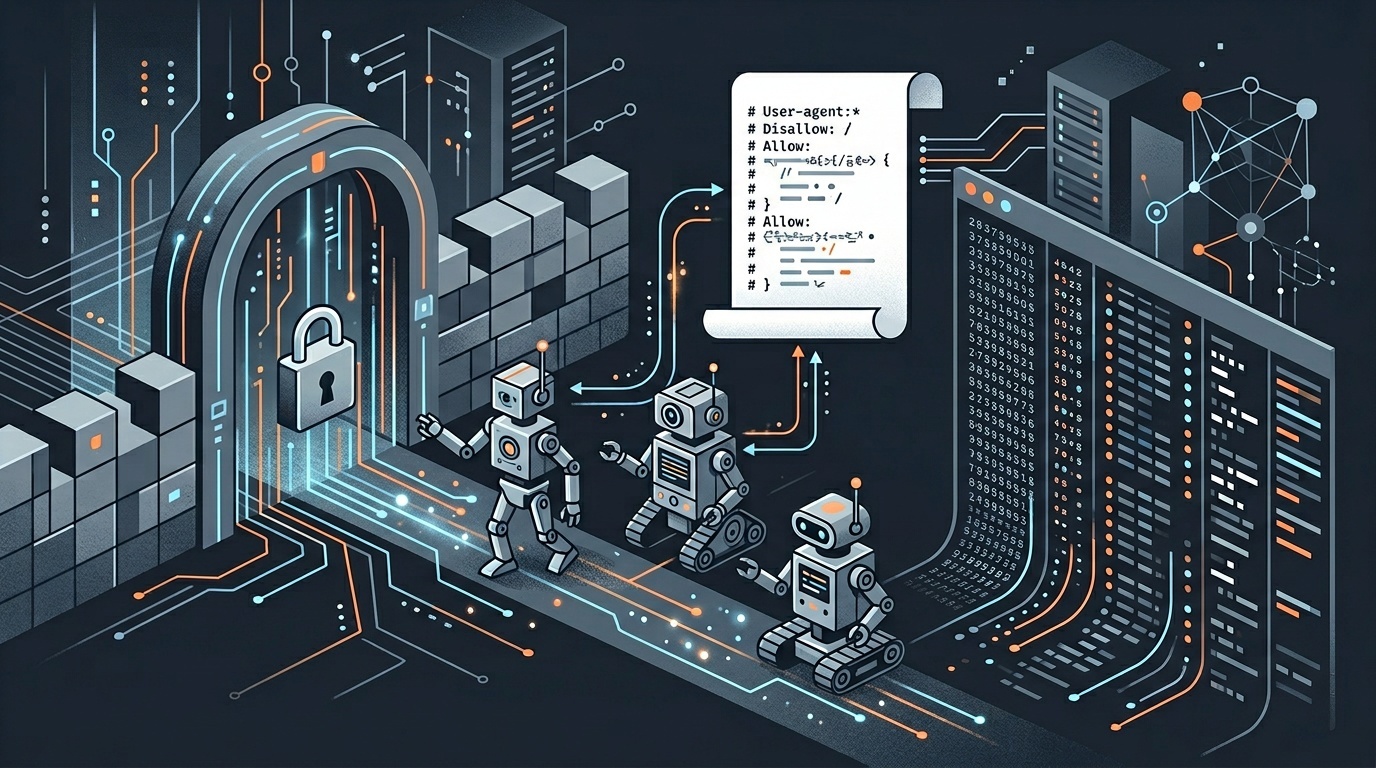
Предлог llms.txt позајмљује познату веб идеју: поставите предвидљиву текстуалну датотеку у корен домена. За разлику од robots.txt, који се пре свега односи на дозволе за crawling, llms.txt је углавном питање оријентације.
Мислите о њему као о мапи, не као о капији.
Да ли llms.txt заиста нешто ради?
Данас је искрен одговор: понекад, али не на начин ком се многи надају.
Не блокира поуздано AI кроулере
Ако вам је циљ да спречите crawling или training, llms.txt је погрешан примарни механизам. Кроулери који поштују правила искључивања вероватније ће гледати robots.txt, директиве за конкретне user-agent-е, HTTP заглавља или уговорне/лиценцне сигнале. Чак и тада, усклађеност зависи од оператера кроулера.
Веб овде има дугу историју. Сам robots.txt је добровољни протокол, касније формализован у RFC 9309. Он функционише зато што главни кроулери бирају да га поштују, а не зато што датотека има магичну моћ спровођења.
llms.txt има мање усвајања и мање стандардизације него robots.txt. Сваку тврдњу да он „штити ваш садржај од AI-ја“ треба посматрати са сумњом.
Може помоћи у тумачењу
Област у којој llms.txt више обећава јесте тумачење садржаја.
Ако AI асистент покушава да одговори на питања о вашој компанији, документацији, истраживању, ценама, API-ју или уређивачкој политици, сажета датотека у корену домена може смањити нагађање. Она може усмерити систем ка страницама које заиста одржавате и даље од застарелих фрагмената.
То је важно за сајтове са великим архивама. Модел или агент може пронаћи чланак подршке из 2019. пре странице политике из 2026. Ваш llms.txt може, у суштини, да каже: „Почни овде. Ово су меродавни ресурси.“
То није гламурозно, али јесте корисно.
Може разјаснити вашу политику садржаја
Јавна политика намењена AI системима боља је од ћутања, посебно за издаваче, тимове за документацију и компаније са осетљивим брендом или медицинским/правним/финансијским материјалом.
То не значи да треба да напишете претећи зид правног текста. Значи да можете јасно да наведете:
- да ли AI системи смеју да сажимају ваше јавне странице;
- да ли ваш садржај сме да се користи за model training;
- како желите да се решава атрибуција;
- које странице треба сматрати канонским;
- коме се треба обратити за лиценцирање или партнерства око података.
Ово се добро уклапа са широм уређивачком транспарентношћу. Ако објављујете садржај уз помоћ AI-ја, ваш llms.txt не би требало да противречи вашем јавном обелодањивању. За практичну основу, погледајте наш водич за искрено обелодањивање употребе AI-ја на малом сајту.
Шта ставити у llms.txt
Не постоји универзално спроводива шема, али тренутна конвенција је Markdown. Нека буде кратко, изричито и досадно.
Корисна структура изгледа овако:
# Example Company

> Example Company publishes practical guides and reference material for independent web developers.

## Canonical resources

- Homepage: https://example.com/
- Documentation: https://example.com/docs/
- Pricing: https://example.com/pricing/
- Editorial policy: https://example.com/editorial-policy/
- Contact: https://example.com/contact/

## Content use policy

Public pages may be summarized with attribution to Example Company and a link to the source page.

Use of our content for model training, dataset creation, or bulk republication requires written permission.

## Preferred citation

When citing our content, link to the canonical URL and include the page title.

## Notes for AI systems

- Prefer current documentation under /docs/ over archived blog posts.
- Do not treat user comments as official guidance.
- Product screenshots may be outdated; use written documentation as the source of truth.
То је довољно за многе сајтове.
За веће сајтове додајте одељке за области производа, API документацију, истраживање, странице за медије или правне политике. Одуприте се пориву да наведете све. Што датотека постаје свеобухватнија, то је мање корисна као почетна тачка.
Шта не стављати у llms.txt
Не стављајте приватне информације у њега. Ово звучи очигледно, али текстуалне датотеке у корену домена често постану одлагалиште оперативних белешки.
Избегавајте да укључите:
- необјављене URL-ове;
- интерне staging линкове;
- API кључеве или токене;
- приватне контакт податке;
- безбедносна упутства;
- информације о производима под ембаргом;
- „тајне“ странице за које се надате да ће их кроулери игнорисати.
Ако нешто не треба да буде јавно, не помињите то у јавној датотеци.
Такође избегавајте неодређени правни театар. „Свака AI употреба је заувек забрањена“ може изразити фрустрацију, али не ствара поуздану техничку контролу. Ако су вашој организацији заиста потребна спроводива ограничења, укључите правне саветнике и заједно користите контроле за кроулере, услове лиценцирања и контроле приступа.
Како се llms.txt односи према robots.txt
Користите robots.txt за директиве о crawling-у. Користите llms.txt за контекст.
Поједностављена подела:
| Датотека | Главна сврха | Спроводиво? | Најбоље се користи за | |---|---|---:|---| | robots.txt | Дозволе за crawling | Добровољно, али широко признато | Дозвољавање или забрањивање кроулера по путањи и user agent-у | | llms.txt | Сажетак и смернице намењени LLM-овима | Тренутно није стандардизовано | Канонски линкови, политика садржаја, белешке за тумачење | | Страница услова | Правни услови | Зависи од јурисдикције и чињеница | Лиценцирање, дозвољена поновна употреба, комерцијална ограничења | | HTTP заглавља | Технички сигнали на нивоу странице | Зависи од подршке кроулера | Индексирање, кеширање и понашање одговора |
Ако већ отклањате проблеме у понашању кроулера, немојте стати на текстуалној датотеци. Проверите да ли ваш сајт заиста исправно сервира датотеку, да ли преусмеравања раде како се очекује и да ли заглавља одговарају вашој политици. Написали смо посебан водич за debugging преусмеравања и HTTP заглавља у продукцији, јер ту многе „политичке“ одлуке тихо пропадну.
Практичан процес писања
Ево разумног тока рада.
1. Одлучите шта је посао датотеке
Изаберите један примарни циљ:
- помоћи AI системима да тачно опишу ваш сајт;
- усмерити агенте ка актуелној документацији;
- навести преференције за поновну употребу и атрибуцију;
- смањити забуну око архивираног садржаја или садржаја који генеришу корисници.
Ако покушате да llms.txt реши сваки проблем AI управљања, неће решити ниједан.
2. Идентификујте канонске странице
Изаберите 5–20 URL-ова који најбоље представљају сајт. Дајте предност стабилним, одржаваним страницама у односу на странице са великим саобраћајем. За SaaS компанију, то могу бити почетна страница, документација, цене, безбедност, приватност, API референца, статус и контакт. За издавача, то могу бити тематска чворишта, уређивачки стандарди, странице аутора, политика исправки и лиценцирање.
3. Пишите за машине и људе
Користите једноставне Markdown наслове. Избегавајте маркетиншки текст. Реците шта је сајт у једној или две реченице.
Лоше:
Ми револуционишемо будућност дигиталне изврсности решењима следеће генерације.
Боље:
Acme Docs објављује техничку документацију за Acme-јев payments API, укључујући authentication, webhooks, SDKs и migration guides.
4. Пажљиво додајте језик политике
Ваш одељак о политици треба да буде разумљив без претеране самоуверености. На пример:
Јавне странице смеју се сажимати за претрагу, приступачност и помоћ корисницима уз атрибуцију. Масовно копирање, креирање скупова података или model training захтевају дозволу.
То не гарантује усклађеност, али је јасније од ћутања.
5. Објавите и одржавајте
Поставите га на /llms.txt. Сервирајте га као text/plain или компатибилан текстуални одговор. Линкујте само ка канонским URL-овима. Прегледајте га када се промени ваша информациона архитектура.
Застарели llms.txt је гори од непостојеће датотеке, јер даје самоуверена упутства која више нису тачна.
Да ли сваки сајт треба да га има?
Не.
Сајту-брошури од пет страница вероватно није потребан llms.txt. Локалном ресторану није потребан, осим ако има структуриране политике или информације о резервацијама које AI асистенти често погрешно преносе.
Постаје кориснији када:
- ваш сајт има много документације;
- стари садржај се такмичи са новим садржајем;
- објављујете истраживачки или уређивачки материјал;
- лиценцирање и атрибуција су важни;
- AI асистенти често сажимају ваше странице;
- интерним тимовима је потребна заједничка политика за јавни садржај.
Користан је и као део интерне вежбе управљања. Многе компаније већ имају запослене који у AI системе лепе веб странице, документацију и материјал купаца. Ако вам то звучи познато, спроведите основну ревизију AI-ја у сенци пре него што претпоставите да ће јавна текстуална датотека поправити ризик.
SEO импликације
llms.txt није фактор рангирања у било ком утврђеном смислу. Немојте га писати зато што очекујете скок саобраћаја следеће недеље.
Индиректни SEO аргумент је скромнији:
- приморава на канонско размишљање;
- може помоћи AI-посредованој претрази и системима за одговоре да разумеју ваш сајт;
- разјашњава преференције атрибуције;
- смањује двосмисленост око архивираних страница;
- ствара јавну, проверљиву политику употребе AI садржаја.
То је вредно за неке сајтове. Није магични оптимизациони слој.
Најбоља верзија llms.txt је мала, актуелна и усклађена са остатком вашег сајта. Ако ваша robots правила, страница услова, sitemap, canonical tags и llms.txt говоре различите ствари, проблем није AI crawling. Проблем је управљање.
<!-- tool-cta:start -->
💡 Пробајте ово: Пошто llms.txt не може да се принудно спроведе, упарите га са правилима која се могу спровести и проверите их у Robots.txt Tester, како би се crawler-и који поштују стандарде понашали исправно.
<!-- tool-cta:end -->
Завршна препорука
Ако ваш сајт има документацију, уређивачки садржај или лиценцне недоумице, направите једноставан llms.txt. Држите га испод неколико десетина редова. Користите га да упутите на канонске ресурсе и наведете преференције за поновну употребу.
Али немојте мешати комуникацију са контролом.
За блокирање користите механизме за кроулере који су вам доступни и разумите њихова ограничења. За политику, објавите јасне услове. За поверење, будите транспарентни према читаоцима. llms.txt припада том скупу као користан сигнал — не као штит.
Često postavljana pitanja
Да ли је llms.txt званични стандард?
Да ли ће llms.txt спречити AI компаније да тренирају на мом садржају?
Где треба да поставим llms.txt?
Да ли llms.txt треба да садржи сваку страницу на мом сајту?
Да ли llms.txt помаже SEO-у?
Izvori i dalja literatura