วิธีเขียน llms.txt—และมันทำอะไรได้จริงหรือไม่
คู่มือเชิงปฏิบัติสำหรับไฟล์เกิดใหม่ที่ใช้กับตัวรวบรวมข้อมูล AI สรุปเนื้อหา และคำแนะนำของเว็บไซต์ที่มุ่งให้โมเดลอ่าน
สารบัญ
- ฉบับสั้น
- llms.txt ถูกออกแบบมาเพื่อแก้ปัญหาอะไร
- llms.txt ทำอะไรได้จริงหรือไม่
- มันไม่ได้บล็อกตัวรวบรวมข้อมูล AI ได้อย่างเชื่อถือได้
- มันช่วยเรื่องการตีความได้
- มันช่วยทำให้นโยบายเนื้อหาของคุณชัดเจนขึ้นได้
- ควรใส่อะไรใน llms.txt
- ไม่ควรใส่อะไรใน llms.txt
- llms.txt เกี่ยวข้องกับ robots.txt อย่างไร
- กระบวนการเขียนที่ใช้ได้จริง
- 1. กำหนดหน้าที่ของไฟล์
- 2. ระบุหน้า canonical
- 3. เขียนเพื่อทั้งเครื่องและมนุษย์
- 4. เพิ่มภาษานโยบายอย่างระมัดระวัง
- 5. เผยแพร่และดูแลรักษา
- ทุกเว็บไซต์ควรมีหรือไม่
- ผลต่อ SEO
- คำแนะนำสุดท้าย
ฉบับสั้น
llms.txt เป็นแนวปฏิบัติที่กำลังเกิดขึ้นสำหรับบอกโมเดลภาษาขนาดใหญ่ว่าเว็บไซต์ของคุณคืออะไร หน้าใดสำคัญ และควรเข้าใจเนื้อหาของคุณอย่างไร โดยทั่วไปไฟล์นี้จะอยู่ที่ https://example.com/llms.txt เขียนด้วย Markdown และลิงก์ไปยังทรัพยากรที่สะอาดและมีประโยชน์
มันไม่เหมือนกับ robots.txt ไม่ใช่มาตรฐานเว็บอย่างเป็นทางการ ไม่ได้บล็อกการฝึก AI ได้อย่างเชื่อถือได้ และไม่ได้บังคับให้บริษัท AI ทำตามความต้องการของคุณ
ถึงอย่างนั้น ก็ยังอาจคุ้มค่าที่จะเขียน
llms.txt ที่ดีเป็นวิธีต้นทุนต่ำในการทำให้ระบบ AI เอเจนต์ ผู้ช่วยค้นหา และเครื่องมือภายใน สรุปเว็บไซต์ของคุณได้ถูกต้องมากขึ้น อีกทั้งยังเป็นกลไกบังคับให้คุณต้องตัดสินใจว่าเนื้อหาใดเป็น canonical เนื้อหาใดล้าสมัย และเงื่อนไขใดใช้กับการนำไปใช้ซ้ำ สิ่งนี้มีประโยชน์ แม้ในปัจจุบันจะมีเพียงไม่กี่ระบบที่อ่านไฟล์นี้ก็ตาม
llms.txt ถูกออกแบบมาเพื่อแก้ปัญหาอะไร
เว็บไซต์ส่วนใหญ่สร้างขึ้นสำหรับมนุษย์และตัวรวบรวมข้อมูลของเครื่องมือค้นหา เว็บไซต์เหล่านี้มีเมนูนำทาง แบนเนอร์คุกกี้ การ์ดสินค้า หน้าหมวดหมู่ที่ซ้ำกัน PDF เก่า พารามิเตอร์ติดตาม และเนื้อหาที่เข้าใจได้ดีเมื่อมองเห็นเท่านั้น
LLM ไม่ต้องการชั้นการนำเสนอแบบเดียวกัน สิ่งที่ต้องการคือ:
- คำอธิบายเว็บไซต์ที่กระชับ;
- ลิงก์ไปยังหน้าที่น่าเชื่อถือที่สุด;
- บริบทภาษาธรรมดาเกี่ยวกับผลิตภัณฑ์ เอกสาร นโยบาย หรือความเป็นผู้เขียน;
- ความต้องการด้านไลเซนส์และการใช้งาน;
- ตัวชี้ไปยังเวอร์ชันแบบมีโครงสร้างหรือ Markdown หากมี
ข้อเสนอ llms.txt ยืมแนวคิดเว็บที่คุ้นเคยมาใช้: วางไฟล์ข้อความที่คาดเดาตำแหน่งได้ไว้ที่รากของโดเมน ต่างจาก robots.txt ซึ่งเน้นเรื่องสิทธิ์ในการรวบรวมข้อมูลเป็นหลัก llms.txt ส่วนใหญ่เน้นเรื่องการปฐมนิเทศและให้บริบท
ให้คิดว่ามันเป็นแผนที่ ไม่ใช่ประตู
llms.txt ทำอะไรได้จริงหรือไม่
ในวันนี้ คำตอบที่ตรงไปตรงมาคือ: บางครั้ง แต่ไม่ใช่ในแบบที่หลายคนคาดหวัง
มันไม่ได้บล็อกตัวรวบรวมข้อมูล AI ได้อย่างเชื่อถือได้
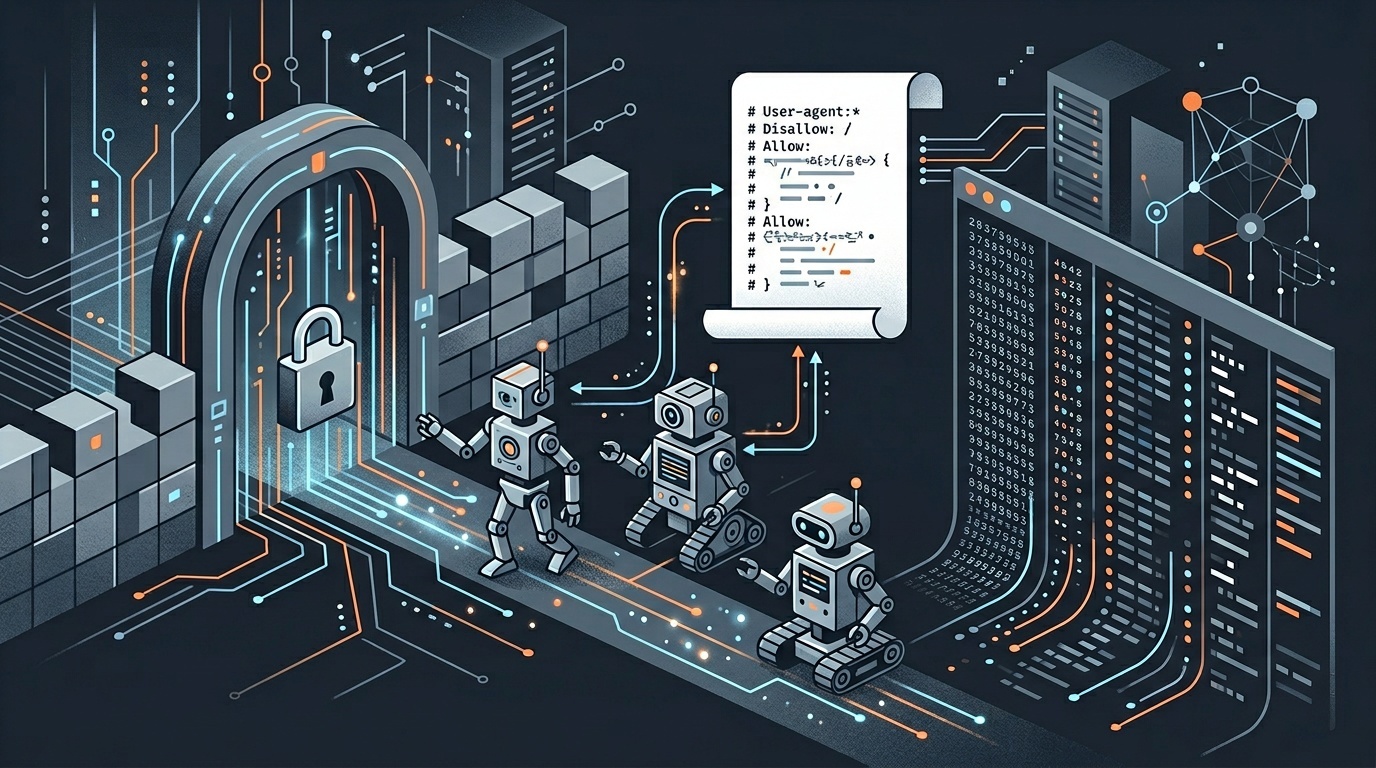
หากเป้าหมายของคุณคือป้องกันการรวบรวมข้อมูลหรือการฝึกโมเดล llms.txt ไม่ใช่กลไกหลักที่ถูกต้อง ตัวรวบรวมข้อมูลที่เคารพกฎการยกเว้นมีแนวโน้มจะดู robots.txt คำสั่งเฉพาะ user-agent, HTTP headers หรือสัญญาณด้านสัญญา/ไลเซนส์มากกว่า แม้เช่นนั้น การปฏิบัติตามก็ขึ้นอยู่กับผู้ดำเนินการตัวรวบรวมข้อมูล
เว็บมีประวัติยาวนานในเรื่องนี้ robots.txt เองก็เป็นโปรโตคอลโดยสมัครใจ ซึ่งภายหลังถูกทำให้เป็นทางการใน RFC 9309 มันทำงานได้เพราะตัวรวบรวมข้อมูลรายใหญ่เลือกที่จะเคารพ ไม่ใช่เพราะไฟล์มีพลังบังคับใช้แบบวิเศษ
llms.txt มีการนำไปใช้น้อยกว่าและมีการทำให้เป็นมาตรฐานน้อยกว่า robots.txt ให้ระวังข้อกล่าวอ้างใด ๆ ที่บอกว่ามัน “ปกป้องเนื้อหาของคุณจาก AI”
มันช่วยเรื่องการตีความได้
จุดที่ llms.txt มีแนวโน้มมีประโยชน์มากกว่าคือการตีความเนื้อหา
หากผู้ช่วย AI กำลังพยายามตอบคำถามเกี่ยวกับบริษัท เอกสาร งานวิจัย ราคา API หรือนโยบายบรรณาธิการของคุณ ไฟล์สั้น ๆ ที่ระดับรากโดเมนสามารถลดการคาดเดาได้ มันสามารถชี้ระบบไปยังหน้าที่คุณดูแลจริง และพาออกจากชิ้นส่วนข้อมูลที่ล้าสมัย
เรื่องนี้สำคัญสำหรับเว็บไซต์ที่มีคลังเนื้อหาขนาดใหญ่ โมเดลหรือเอเจนต์อาจพบบทความสนับสนุนจากปี 2019 ก่อนหน้าหน้านโยบายปี 2026 llms.txt ของคุณสามารถบอกโดยนัยได้ว่า: “เริ่มที่นี่ ทรัพยากรเหล่านี้คือแหล่งอ้างอิงที่เชื่อถือได้”
สิ่งนี้อาจไม่หวือหวา แต่มีประโยชน์
มันช่วยทำให้นโยบายเนื้อหาของคุณชัดเจนขึ้นได้
นโยบายสาธารณะที่มุ่งให้ AI อ่านย่อมดีกว่าความเงียบ โดยเฉพาะสำหรับผู้เผยแพร่ ทีมเอกสาร และบริษัทที่มีเนื้อหาเกี่ยวกับแบรนด์ หรือเนื้อหาทางการแพทย์/กฎหมาย/การเงินที่อ่อนไหว
นี่ไม่ได้หมายความว่าคุณควรเขียนกำแพงข้อความกฎหมายที่ข่มขู่ แต่หมายความว่าคุณสามารถระบุอย่างเรียบง่ายว่า:
- ระบบ AI อาจสรุปหน้าสาธารณะของคุณได้หรือไม่;
- เนื้อหาของคุณอาจถูกใช้สำหรับการฝึกโมเดลได้หรือไม่;
- คุณต้องการให้จัดการการอ้างอิงแหล่งที่มาอย่างไร;
- หน้าใดควรถูกถือว่าเป็น canonical;
- ควรติดต่อใครสำหรับไลเซนส์หรือความร่วมมือด้านข้อมูล
สิ่งนี้เข้ากันได้ดีกับความโปร่งใสด้านบรรณาธิการที่กว้างขึ้น หากคุณเผยแพร่เนื้อหาที่มี AI ช่วย llms.txt ของคุณไม่ควรขัดแย้งกับการเปิดเผยต่อสาธารณะของคุณ สำหรับแนวทางพื้นฐานที่ใช้ได้จริง โปรดดูคู่มือของเราเรื่อง การเปิดเผยการใช้ AI อย่างซื่อสัตย์บนเว็บไซต์ขนาดเล็ก
ควรใส่อะไรใน llms.txt
ยังไม่มี schema ที่บังคับใช้เป็นสากล แต่แนวปฏิบัติปัจจุบันคือ Markdown เขียนให้สั้น ชัดเจน และเรียบง่าย
โครงสร้างที่มีประโยชน์มีลักษณะเช่นนี้:
# Example Company

> Example Company publishes practical guides and reference material for independent web developers.

## Canonical resources

- Homepage: https://example.com/
- Documentation: https://example.com/docs/
- Pricing: https://example.com/pricing/
- Editorial policy: https://example.com/editorial-policy/
- Contact: https://example.com/contact/

## Content use policy

Public pages may be summarized with attribution to Example Company and a link to the source page.

Use of our content for model training, dataset creation, or bulk republication requires written permission.

## Preferred citation

When citing our content, link to the canonical URL and include the page title.

## Notes for AI systems

- Prefer current documentation under /docs/ over archived blog posts.
- Do not treat user comments as official guidance.
- Product screenshots may be outdated; use written documentation as the source of truth.
เท่านี้ก็เพียงพอสำหรับหลายเว็บไซต์
สำหรับเว็บไซต์ขนาดใหญ่ ให้เพิ่มส่วนสำหรับกลุ่มผลิตภัณฑ์ เอกสาร API งานวิจัย หน้าข่าวประชาสัมพันธ์ หรือนโยบายทางกฎหมาย พยายามไม่ใส่ทุกอย่างลงไป ยิ่งไฟล์ครอบคลุมมากเท่าไร ก็ยิ่งมีประโยชน์น้อยลงในฐานะจุดเริ่มต้น
ไม่ควรใส่อะไรใน llms.txt
อย่าใส่ข้อมูลส่วนตัวลงไป ฟังดูชัดเจน แต่ไฟล์ข้อความระดับรากโดเมนมักกลายเป็นที่ทิ้งบันทึกเชิงปฏิบัติการ
หลีกเลี่ยงการใส่:
- URL ที่ยังไม่เผยแพร่;
- ลิงก์ staging ภายใน;
- API keys หรือ tokens;
- รายละเอียดติดต่อส่วนตัว;
- คำสั่งด้านความปลอดภัย;
- ข้อมูลผลิตภัณฑ์ที่ยังอยู่ภายใต้ embargo;
- หน้า “ลับ” ที่คุณหวังว่าตัวรวบรวมข้อมูลจะไม่สนใจ
หากบางสิ่งไม่ควรเป็นสาธารณะ ก็อย่าเอ่ยถึงมันในไฟล์สาธารณะ
และควรหลีกเลี่ยงการแสดงเชิงกฎหมายที่คลุมเครือ “ห้ามใช้ AI ทุกกรณีตลอดไป” อาจสื่อความคับข้องใจได้ แต่มันไม่ได้สร้างการควบคุมทางเทคนิคที่เชื่อถือได้ หากองค์กรของคุณต้องการข้อจำกัดที่บังคับใช้ได้จริง ให้ปรึกษาที่ปรึกษากฎหมาย และใช้การควบคุมตัวรวบรวมข้อมูล เงื่อนไขไลเซนส์ และการควบคุมการเข้าถึงร่วมกัน
llms.txt เกี่ยวข้องกับ robots.txt อย่างไร
ใช้ robots.txt สำหรับคำสั่งการรวบรวมข้อมูล ใช้ llms.txt สำหรับบริบท
การแบ่งอย่างง่าย:
| ไฟล์ | วัตถุประสงค์หลัก | บังคับใช้ได้หรือไม่ | เหมาะที่สุดสำหรับ | |---|---|---:|---| | robots.txt | สิทธิ์ในการรวบรวมข้อมูล | โดยสมัครใจ แต่เป็นที่ยอมรับอย่างกว้างขวาง | อนุญาตหรือไม่อนุญาตตัวรวบรวมข้อมูลตาม path และ user agent | | llms.txt | สรุปและแนวทางสำหรับ LLM | ปัจจุบันยังไม่ได้ทำให้เป็นมาตรฐาน | ลิงก์ canonical นโยบายเนื้อหา บันทึกด้านการตีความ | | หน้า Terms | เงื่อนไขทางกฎหมาย | ขึ้นอยู่กับเขตอำนาจศาลและข้อเท็จจริง | ไลเซนส์ การใช้ซ้ำที่ได้รับอนุญาต ข้อจำกัดเชิงพาณิชย์ | | HTTP headers | สัญญาณทางเทคนิคระดับหน้า | ขึ้นอยู่กับการรองรับของตัวรวบรวมข้อมูล | การจัดทำดัชนี แคช และพฤติกรรมการตอบกลับ |
หากคุณกำลังดีบักพฤติกรรมของตัวรวบรวมข้อมูลอยู่แล้ว อย่าหยุดแค่ไฟล์ข้อความ ตรวจสอบว่าเว็บไซต์ของคุณเสิร์ฟไฟล์ได้ถูกต้องจริงหรือไม่ redirect ทำงานตามคาดหรือไม่ และ headers สอดคล้องกับนโยบายของคุณหรือไม่ เราเขียนคู่มือแยกเกี่ยวกับ การดีบัก redirects และ HTTP headers ใน production เพราะนี่คือจุดที่การตัดสินใจด้าน “นโยบาย” จำนวนมากล้มเหลวอย่างเงียบ ๆ
กระบวนการเขียนที่ใช้ได้จริง
ต่อไปนี้คือ workflow ที่สมเหตุสมผล
1. กำหนดหน้าที่ของไฟล์
เลือกเป้าหมายหลักหนึ่งข้อ:
- ช่วยให้ระบบ AI อธิบายเว็บไซต์ของคุณได้แม่นยำ;
- ชี้นำเอเจนต์ไปยังเอกสารปัจจุบัน;
- ระบุความต้องการด้านการใช้ซ้ำและการอ้างอิงแหล่งที่มา;
- ลดความสับสนเกี่ยวกับเนื้อหาเก่าหรือเนื้อหาที่ผู้ใช้สร้าง
หากคุณพยายามทำให้ llms.txt แก้ปัญหาธรรมาภิบาล AI ทุกเรื่อง มันจะไม่แก้ได้สักเรื่อง
2. ระบุหน้า canonical
เลือก URL 5–20 รายการที่เป็นตัวแทนของเว็บไซต์ได้ดีที่สุด ให้ความสำคัญกับหน้าที่เสถียรและได้รับการดูแล มากกว่าหน้าที่มีทราฟฟิกสูง สำหรับบริษัท SaaS อาจเป็นหน้าแรก เอกสาร ราคา ความปลอดภัย ความเป็นส่วนตัว API reference สถานะ และติดต่อ สำหรับผู้เผยแพร่ อาจเป็นศูนย์รวมหัวข้อ มาตรฐานบรรณาธิการ หน้าผู้เขียน นโยบายการแก้ไข และไลเซนส์
3. เขียนเพื่อทั้งเครื่องและมนุษย์
ใช้หัวข้อ Markdown แบบเรียบง่าย หลีกเลี่ยงข้อความการตลาด บอกว่าเว็บไซต์คืออะไรในหนึ่งหรือสองประโยค
ไม่ดี:
We are revolutionizing the future of digital excellence with next-generation solutions.
ดีกว่า:
Acme Docs publishes technical documentation for Acme’s payments API, including authentication, webhooks, SDKs, and migration guides.
4. เพิ่มภาษานโยบายอย่างระมัดระวัง
ส่วนของนโยบายควรเข้าใจได้โดยไม่มั่นใจเกินจริง ตัวอย่างเช่น:
Public pages may be summarized for search, accessibility, and user assistance with attribution. Bulk copying, dataset creation, or model training requires permission.
สิ่งนี้ไม่ได้รับประกันการปฏิบัติตาม แต่ชัดเจนกว่าความเงียบ
5. เผยแพร่และดูแลรักษา
วางไว้ที่ /llms.txt เสิร์ฟเป็น text/plain หรือ response แบบข้อความที่เข้ากันได้ ลิงก์เฉพาะไปยัง URL canonical ตรวจทานเมื่อสถาปัตยกรรมข้อมูลของคุณเปลี่ยน
llms.txt ที่ล้าสมัยแย่กว่าการไม่มีไฟล์ เพราะมันให้คำสั่งอย่างมั่นใจที่ไม่เป็นจริงอีกต่อไป
ทุกเว็บไซต์ควรมีหรือไม่
ไม่
เว็บไซต์แนะนำธุรกิจห้าหน้าอาจไม่จำเป็นต้องมี llms.txt ร้านอาหารท้องถิ่นก็ไม่จำเป็นต้องมี เว้นแต่มันมีนโยบายเชิงโครงสร้างหรือข้อมูลการจองที่ผู้ช่วย AI มักกล่าวผิด
มันจะมีประโยชน์มากขึ้นเมื่อ:
- เว็บไซต์ของคุณมีเอกสารจำนวนมาก;
- เนื้อหาเก่าแข่งขันกับเนื้อหาใหม่;
- คุณเผยแพร่งานวิจัยหรือเนื้อหาเชิงบรรณาธิการ;
- ไลเซนส์และการอ้างอิงแหล่งที่มามีความสำคัญ;
- ผู้ช่วย AI มักสรุปหน้าของคุณ;
- ทีมภายในต้องการนโยบายร่วมสำหรับเนื้อหาสาธารณะ
มันยังมีประโยชน์ในฐานะส่วนหนึ่งของการฝึกธรรมาภิบาลภายใน หลายบริษัทมีพนักงานที่คัดลอกหน้าเว็บ เอกสาร และข้อมูลลูกค้าไปวางในระบบ AI อยู่แล้ว หากเรื่องนี้ฟังดูคุ้นเคย ให้ทำ การตรวจสอบ shadow AI ขั้นพื้นฐานก่อนจะสมมติว่าไฟล์ข้อความสาธารณะจะแก้ความเสี่ยงได้
ผลต่อ SEO
llms.txt ไม่ใช่ปัจจัยการจัดอันดับในความหมายที่เป็นที่ยอมรับ อย่าเขียนมันเพราะคุณคาดหวังว่าทราฟฟิกจะเพิ่มขึ้นในสัปดาห์หน้า
กรณี SEO ทางอ้อมนั้นถ่อมตัวกว่า:
- มันบังคับให้คิดเรื่อง canonical;
- มันอาจช่วยให้การค้นหาและระบบตอบคำถามที่มี AI เป็นตัวกลางเข้าใจเว็บไซต์ของคุณ;
- มันทำให้ความต้องการด้านการอ้างอิงแหล่งที่มาชัดเจนขึ้น;
- มันลดความกำกวมรอบหน้าเก่า;
- มันสร้างนโยบายการใช้เนื้อหาโดย AI ที่เป็นสาธารณะและตรวจสอบได้
สิ่งนี้คุ้มค่าสำหรับบางเว็บไซต์ แต่ไม่ใช่ชั้นเพิ่มประสิทธิภาพวิเศษ
llms.txt เวอร์ชันที่ดีที่สุดคือเล็ก เป็นปัจจุบัน และสอดคล้องกับส่วนที่เหลือของเว็บไซต์ หากกฎ robots หน้า terms sitemap canonical tags และ llms.txt ของคุณพูดกันคนละอย่าง ปัญหาไม่ใช่การรวบรวมข้อมูลโดย AI ปัญหาคือธรรมาภิบาล
<!-- tool-cta:start -->
💡 ลองทำสิ่งนี้: เนื่องจาก llms.txt ไม่สามารถบังคับใช้ได้ ให้จับคู่กับกฎที่บังคับใช้ได้และตรวจสอบกฎเหล่านั้นใน Robots.txt Tester เพื่อให้ครอว์เลอร์ที่ปฏิบัติตามมาตรฐานทำงานได้อย่างถูกต้อง
<!-- tool-cta:end -->
คำแนะนำสุดท้าย
หากเว็บไซต์ของคุณมีเอกสาร เนื้อหาเชิงบรรณาธิการ หรือข้อกังวลด้านไลเซนส์ ให้สร้าง llms.txt แบบเรียบง่าย รักษาให้ไม่เกินไม่กี่สิบบรรทัด ใช้มันเพื่อชี้ไปยังทรัพยากร canonical และระบุความต้องการด้านการใช้ซ้ำของคุณ
แต่อย่าสับสนระหว่างการสื่อสารกับการควบคุม
สำหรับการบล็อก ให้ใช้กลไกตัวรวบรวมข้อมูลที่คุณมี และเข้าใจข้อจำกัดของมัน สำหรับนโยบาย ให้เผยแพร่เงื่อนไขที่ชัดเจน สำหรับความไว้วางใจ ให้โปร่งใสกับผู้อ่าน llms.txt ควรอยู่ในชุดเครื่องมือนั้นในฐานะสัญญาณที่เป็นประโยชน์—ไม่ใช่โล่ป้องกัน
คำถามที่พบบ่อย
llms.txt เป็นมาตรฐานอย่างเป็นทางการหรือไม่?
llms.txt จะหยุดบริษัท AI ไม่ให้ฝึกโมเดลจากเนื้อหาของฉันได้หรือไม่?
ควรวาง llms.txt ไว้ที่ไหน?
llms.txt ควรรวมทุกหน้าในเว็บไซต์ของฉันหรือไม่?
llms.txt ช่วย SEO หรือไม่?
แหล่งข้อมูล & การอ่านเพิ่มเติม