小型網站上誠實的 AI 揭露應該是什麼樣子
目前沒有法律範本能告訴讀者:這些文字是由模型寫成的。以下是我們要求自己的編輯標準,以及它為什麼比你想的更重要。
 The Wux Webtools Team
4 分鐘閱讀
廉價版本到處都是
今天,只要搜尋幾乎任何實用問題,你都很可能進入一個由語言模型在不到一分鐘內組裝出的頁面。有時,模型被要求摘要一個真實來源;有時,模型被要求編造一個來源。不論哪一種,結果都讀起來像那麼回事,頁面排名也還可以,而發布者則省下了聘請作者的費用。
AI 發布內容的廉價版本通常有三個共同特徵:
- 沒有揭露。 讀者不會被告知這個頁面是由模型寫成的。
- 沒有編輯。 文字以模型產出的樣子直接發布。
- 沒有問責。 沒有人類姓名、沒有簡介,頁面出錯時也沒有人可以聯絡。
這對讀者不好,對開放網路不好,而且——雖然不那麼顯而易見——對發布者也不好。搜尋平台已開始懲罰這類內容,讀者也學會辨識它;隨著越來越多網站做完全相同的事,長尾 SEO 優勢每一季都更快被侵蝕。
有一條更好的路。它也沒有那麼複雜。
涵蓋大部分情況的三項承諾
我們確實會在本站部分寫作中使用語言模型——通常作為快速產出初稿的工具,偶爾用於翻譯,但絕不用於查找事實。以下標準是我們要求自己的做法。我們不聲稱這是唯一正道;我們公開它們,是為了讓你能監督我們,也讓其他小型發布者有一個起點。
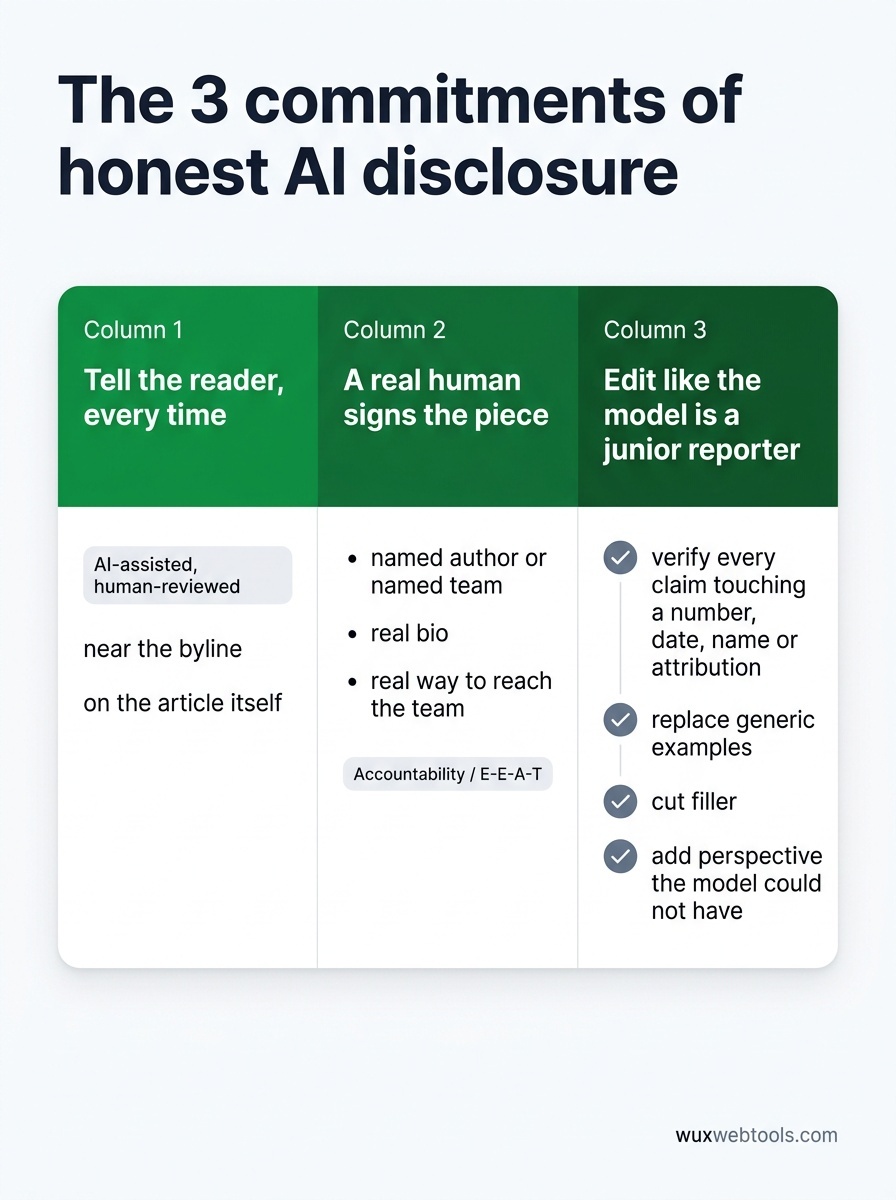
1. 每一次都告訴讀者
如果一篇文章的初稿是由模型寫成的,文章會在作者署名附近放上一個小標章說明這件事。不是埋在隱私權政策裡。不是放在全站頁尾。是在文章本身,在讀者信任這些文字之前就能看到的地方。
這個標章不會寫「100% AI 生成」,因為那會造成誤導——每篇文章也都經過人工編輯。它會寫像是「AI 輔助,人工審閱」這樣誠實的說法,並連到一個頁面,清楚說明這究竟代表什麼。
2. 由真實的人為文章署名
每篇文章都有具名作者,包含真實簡介、真實專業背景,以及能聯絡團隊的真實方式。即使署名是集體形式(「The Wux Webtools Team」),團隊也必須可被識別,編輯標準必須寫下來,並且有人對已發布的內容負責。
這也正是滿足 E-E-A-T 中 Authoritativeness 與 Trust 的部分。現在搜尋引擎會看這件事。好的讀者也會。
3. 像對待初階記者一樣編輯模型
語言模型是一位快速、自信、但有點不可靠的作者。它會寫出流暢的文字,裡面卻藏著錯誤事實,而且從不提醒你。因此,編輯流程不是可有可無;它才是整件事的核心。
真正的編輯意味著:
- 查證每一項主張,只要它涉及數字、日期、姓名或歸屬。
- 替換通用範例,改用團隊實際在現場看過的例子。
- 刪除填充文字。 模型喜歡三句話的轉場;讀者不喜歡。
- 加入模型不可能擁有的觀點。「根據我們的經驗……」是 AI 輔助寫作中最昂貴的一句話,因為你必須真的有那份經驗。
如果文章無法通過這一關——如果編輯的工作主要只是修飾表面——那篇文章就不該發布。每季十篇誠實的作品,勝過五十篇流暢但單薄的文章。
這在頁面上會是什麼樣子
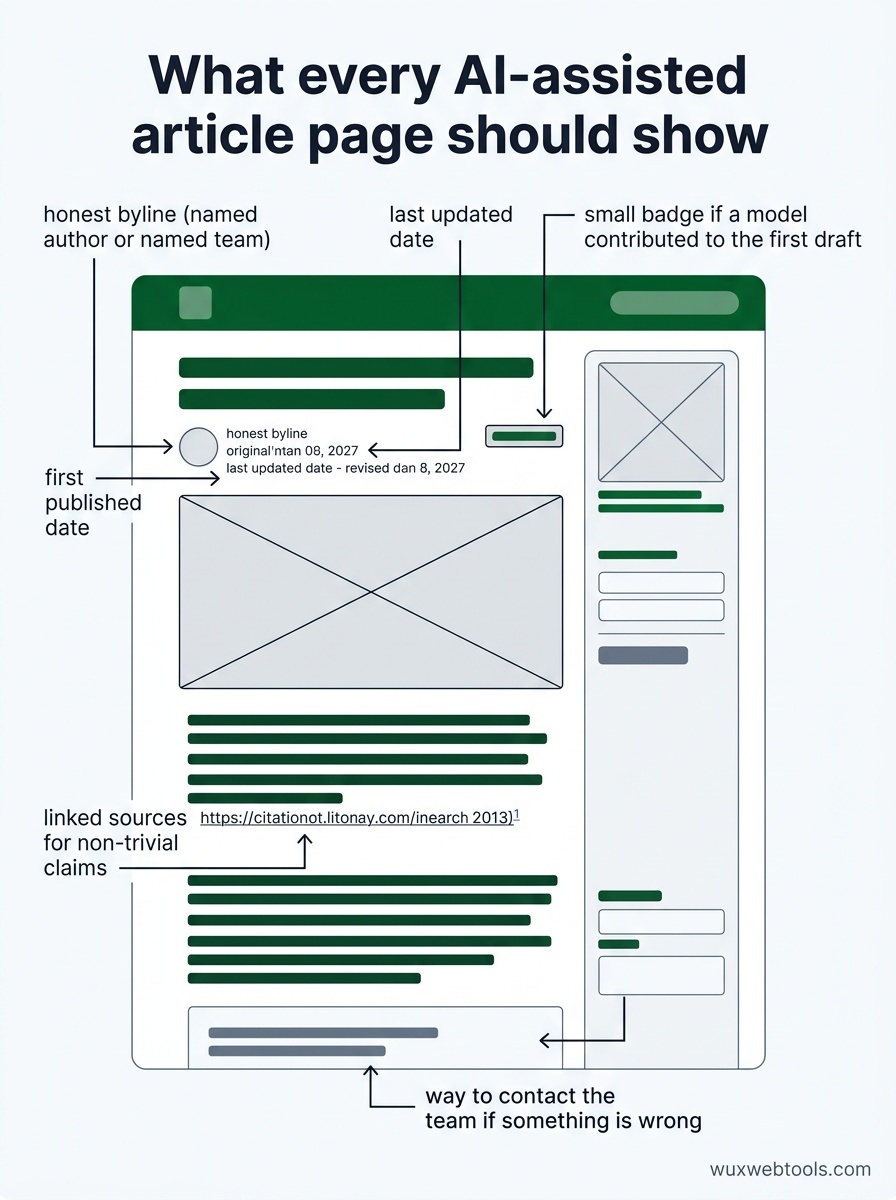
對任何想確認這項標準的讀者而言,這個部落格上的每篇文章都應該顯示:
- 誠實的署名(具名作者或具名團隊)
- 首次發布日期以及最後更新日期
- 如果模型參與了初稿,會有一個小標章
- 對非顯而易見主張提供連結來源
- 如果有錯,能聯絡團隊的方式
如果你正在讀的某篇文章缺少其中任何一項,請告訴我們——那是我們流程中的錯誤,而不是刻意的選擇。
<!-- tool-cta:start -->
💡 試試這個: 如果你想了解你的 AI 揭露對爬蟲的可見程度,AI Markdown Checker 會檢查頁面如何表明 AI 參與。
<!-- tool-cta:end -->
更深層的原因
我們很容易把 AI 揭露視為一種防禦動作:讓搜尋引擎滿意、避免反彈、勾選合規方框。但這種框架錯過了重點。
揭露的真正理由在於:讀者與發布者之間的信任契約,是小型網站擁有的最有價值資產。人們把幾分鐘的注意力交給你。他們認真看待你說的話,有時甚至認真到會據此行動。如果他們後來發現署名是一場虛構——那些句子背後其實沒有任何人真正站出來負責——他們失去的不是對你的信任。他們失去的是對這個媒介的信任。而這種損失會在整個開放網路上持續累積。
在每個 AI 輔助頁面上放上一句簡短、誠實的說明,是對抗這件事最便宜的保險。
常見問題
如果我只是用 AI 檢查文法,也需要揭露嗎?
揭露不會傷害我的 SEO 嗎?
翻譯怎麼辦?
什麼是 E-E-A-T?為什麼它一直被提到?
來源與進一步閱讀