Como escrever llms.txt — e se ele realmente faz alguma coisa
Um guia prático para o arquivo emergente voltado a crawlers de IA, resumos de conteúdo e instruções de site para modelos.
Tabela de conteúdos
- A versão curta
- O que o llms.txt pretende resolver
- O llms.txt realmente faz alguma coisa?
- Ele não bloqueia crawlers de IA de forma confiável
- Ele pode ajudar na interpretação
- Ele pode esclarecer sua política de conteúdo
- O que colocar no llms.txt
- O que não colocar no llms.txt
- Como o llms.txt se relaciona com o robots.txt
- Um processo prático de escrita
- 1. Decida o papel do arquivo
- 2. Identifique páginas canônicas
- 3. Escreva para máquinas e humanos
- 4. Adicione linguagem de política com cuidado
- 5. Publique e mantenha
- Todo site deveria ter um?
- Implicações para SEO
- Uma recomendação final
A versão curta
llms.txt é uma convenção emergente para informar a grandes modelos de linguagem o que é o seu site, quais páginas importam e como seu conteúdo deve ser entendido. Ele geralmente fica em https://example.com/llms.txt, é escrito em Markdown e aponta para recursos limpos e úteis.
Ele não é a mesma coisa que robots.txt. Não é um padrão oficial da web. Não bloqueia o treinamento de IA de forma confiável. Não obriga uma empresa de IA a seguir suas preferências.
Ainda assim, pode valer a pena escrevê-lo.
Um bom llms.txt é uma forma de baixo custo de tornar seu site mais fácil de ser resumido corretamente por sistemas de IA, agentes, assistentes de busca e ferramentas internas. Também é um mecanismo de disciplina: você precisa decidir qual conteúdo é canônico, qual conteúdo está desatualizado e quais termos se aplicam à reutilização. Isso é útil mesmo que, hoje, apenas alguns sistemas leiam o arquivo.
O que o llms.txt pretende resolver
A maioria dos sites é construída para humanos e crawlers de busca. Eles contêm navegação, banners de cookies, cartões de produto, páginas de categoria duplicadas, PDFs antigos, parâmetros de rastreamento e conteúdo que só faz sentido visualmente.
LLMs não precisam da mesma camada de apresentação. Eles precisam de:
- uma descrição concisa do site;
- links para as páginas mais autoritativas;
- contexto em linguagem simples sobre produtos, documentação, políticas ou autoria;
- preferências de licenciamento e uso;
- indicações para versões estruturadas ou em Markdown, quando disponíveis.
A proposta do llms.txt toma emprestada uma ideia familiar da web: colocar um arquivo de texto previsível na raiz do domínio. Ao contrário do robots.txt, que trata principalmente de permissões de rastreamento, o llms.txt trata sobretudo de orientação.
Pense nele como um mapa, não como um portão.
O llms.txt realmente faz alguma coisa?
Hoje, a resposta honesta é: às vezes, mas não da forma que muitas pessoas esperam.
Ele não bloqueia crawlers de IA de forma confiável
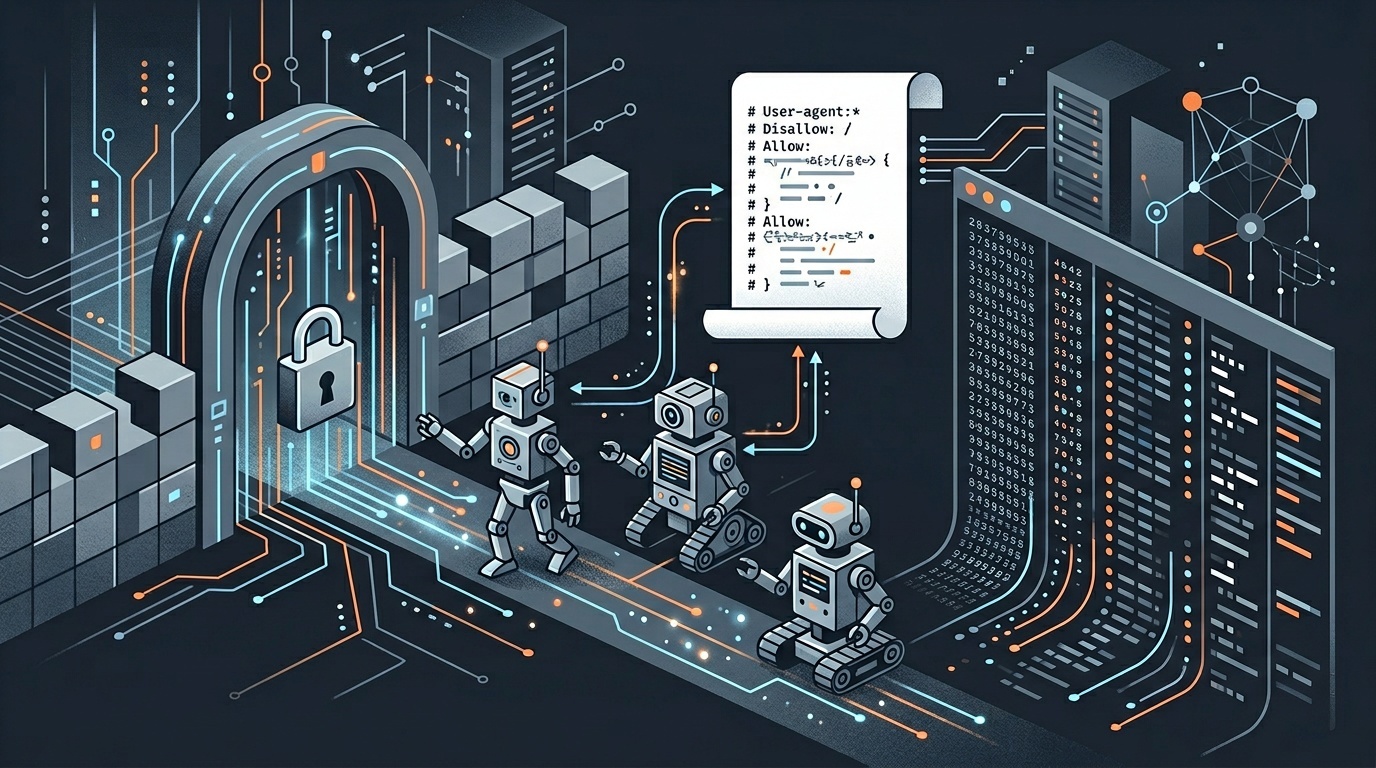
Se seu objetivo é impedir rastreamento ou treinamento, llms.txt é o mecanismo principal errado. Crawlers que respeitam regras de exclusão são mais propensos a consultar robots.txt, diretivas específicas de user-agent, cabeçalhos HTTP ou sinais contratuais/de licenciamento. Mesmo assim, a conformidade depende do operador do crawler.
A web tem uma longa história nesse ponto. O próprio robots.txt é um protocolo voluntário, posteriormente formalizado na RFC 9309. Ele funciona porque os principais crawlers escolhem respeitá-lo, não porque o arquivo tenha algum poder mágico de aplicação.
llms.txt tem menos adoção e menos padronização do que robots.txt. Trate com desconfiança qualquer afirmação de que ele “protege seu conteúdo da IA”.
Ele pode ajudar na interpretação
Onde o llms.txt é mais promissor é na interpretação do conteúdo.
Se um assistente de IA está tentando responder a perguntas sobre sua empresa, documentação, pesquisa, preços, API ou política editorial, um arquivo conciso no nível raiz pode reduzir suposições. Ele pode apontar o sistema para as páginas que você realmente mantém e afastá-lo de fragmentos desatualizados.
Isso importa para sites com grandes arquivos. Um modelo ou agente pode encontrar um artigo de suporte de 2019 antes de uma página de política de 2026. Seu llms.txt pode dizer, na prática: “Comece aqui. Estes são os recursos autoritativos.”
Isso não é glamouroso, mas é útil.
Ele pode esclarecer sua política de conteúdo
Uma política pública voltada à IA é melhor do que o silêncio, especialmente para publicações, equipes de documentação e empresas com material sensível de marca, médico, jurídico ou financeiro.
Isso não significa que você deva escrever uma parede ameaçadora de texto jurídico. Significa que você pode declarar, de forma simples:
- se sistemas de IA podem resumir suas páginas públicas;
- se seu conteúdo pode ser usado para treinamento de modelos;
- como você quer que a atribuição seja tratada;
- quais páginas devem ser consideradas canônicas;
- quem contatar para licenciamento ou parcerias de dados.
Isso combina bem com uma transparência editorial mais ampla. Se você publica conteúdo assistido por IA, seu llms.txt não deve contradizer sua divulgação pública. Para uma base prática, veja nosso guia sobre divulgação honesta de IA em um site pequeno.
O que colocar no llms.txt
Não há um esquema universalmente aplicado, mas a convenção atual é Markdown. Mantenha-o curto, explícito e sem floreios.
Uma estrutura útil se parece com isto:
# Example Company

> Example Company publishes practical guides and reference material for independent web developers.

## Canonical resources

- Homepage: https://example.com/
- Documentation: https://example.com/docs/
- Pricing: https://example.com/pricing/
- Editorial policy: https://example.com/editorial-policy/
- Contact: https://example.com/contact/

## Content use policy

Public pages may be summarized with attribution to Example Company and a link to the source page.

Use of our content for model training, dataset creation, or bulk republication requires written permission.

## Preferred citation

When citing our content, link to the canonical URL and include the page title.

## Notes for AI systems

- Prefer current documentation under /docs/ over archived blog posts.
- Do not treat user comments as official guidance.
- Product screenshots may be outdated; use written documentation as the source of truth.
Isso é suficiente para muitos sites.
Para sites maiores, adicione seções para áreas de produto, documentação de API, pesquisa, páginas de imprensa ou políticas legais. Resista à tentação de listar tudo. Quanto mais abrangente o arquivo se torna, menos útil ele é como ponto de partida.
O que não colocar no llms.txt
Não coloque informações privadas nele. Isso parece óbvio, mas arquivos de texto no nível raiz frequentemente viram depósitos para notas operacionais.
Evite incluir:
- URLs não publicados;
- links internos de staging;
- chaves de API ou tokens;
- dados de contato privados;
- instruções de segurança;
- informações de produto sob embargo;
- páginas “secretas” que você espera que crawlers ignorem.
Se algo não deve ser público, não o mencione em um arquivo público.
Também evite teatro jurídico vago. “Todo uso de IA é proibido para sempre” pode expressar frustração, mas não cria um controle técnico confiável. Se sua organização realmente precisa de restrições aplicáveis, envolva assessoria jurídica e use controles de crawlers, termos de licenciamento e controles de acesso em conjunto.
Como o llms.txt se relaciona com o robots.txt
Use robots.txt para diretivas de rastreamento. Use llms.txt para contexto.
Uma divisão simplificada:
| Arquivo | Finalidade principal | Aplicável? | Melhor uso | |---|---|---:|---| | robots.txt | Permissões de rastreamento | Voluntário, mas amplamente reconhecido | Permitir ou bloquear crawlers por caminho e user agent | | llms.txt | Resumo e orientação voltados a LLMs | Atualmente não padronizado | Links canônicos, política de conteúdo, notas de interpretação | | Página de termos | Condições legais | Depende da jurisdição e dos fatos | Licenciamento, reutilização permitida, restrições comerciais | | Cabeçalhos HTTP | Sinais técnicos no nível da página | Depende do suporte do crawler | Indexação, cache e comportamento de resposta |
Se você já está depurando o comportamento de crawlers, não pare no arquivo de texto. Verifique se seu site realmente serve o arquivo corretamente, se os redirecionamentos se comportam como esperado e se os cabeçalhos correspondem à sua política. Escrevemos um guia separado sobre depuração de redirecionamentos e cabeçalhos HTTP em produção porque é aí que muitas decisões de “política” falham silenciosamente.
Um processo prático de escrita
Aqui está um fluxo de trabalho sensato.
1. Decida o papel do arquivo
Escolha um objetivo principal:
- ajudar sistemas de IA a descrever seu site com precisão;
- orientar agentes para a documentação atual;
- declarar preferências de reutilização e atribuição;
- reduzir confusão em torno de conteúdo arquivado ou gerado por usuários.
Se você tentar fazer o llms.txt resolver todos os problemas de governança de IA, ele não resolverá nenhum.
2. Identifique páginas canônicas
Escolha as 5 a 20 URLs que melhor representam o site. Prefira páginas estáveis e mantidas a páginas de alto tráfego. Para uma empresa SaaS, isso pode incluir homepage, documentação, preços, segurança, privacidade, referência de API, status e contato. Para uma publicação, pode incluir hubs de tópicos, padrões editoriais, páginas de autores, política de correções e licenciamento.
3. Escreva para máquinas e humanos
Use títulos simples em Markdown. Evite texto de marketing. Diga o que o site é em uma ou duas frases.
Ruim:
Estamos revolucionando o futuro da excelência digital com soluções de última geração.
Melhor:
Acme Docs publica documentação técnica para a API de pagamentos da Acme, incluindo autenticação, webhooks, SDKs e guias de migração.
4. Adicione linguagem de política com cuidado
Sua seção de política deve ser compreensível sem ser excessivamente confiante. Por exemplo:
Páginas públicas podem ser resumidas para busca, acessibilidade e assistência ao usuário com atribuição. Cópia em massa, criação de datasets ou treinamento de modelos requer permissão.
Isso não garante conformidade, mas é mais claro do que o silêncio.
5. Publique e mantenha
Coloque-o em /llms.txt. Sirva-o como text/plain ou uma resposta de texto compatível. Link apenas para URLs canônicas. Revise-o quando sua arquitetura de informação mudar.
Um llms.txt desatualizado é pior do que não ter arquivo, porque fornece instruções confiantes que não são mais verdadeiras.
Todo site deveria ter um?
Não.
Um site institucional de cinco páginas provavelmente não precisa de llms.txt. Um restaurante local não precisa de um, a menos que tenha políticas estruturadas ou informações de reserva que assistentes de IA frequentemente apresentem de forma errada.
Ele se torna mais útil quando:
- seu site tem muita documentação;
- conteúdo antigo compete com conteúdo novo;
- você publica pesquisa ou material editorial;
- licenciamento e atribuição importam;
- assistentes de IA frequentemente resumem suas páginas;
- equipes internas precisam de uma política compartilhada para conteúdo público.
Ele também é útil como parte de um exercício interno de governança. Muitas empresas já têm funcionários colando páginas da web, documentos e material de clientes em sistemas de IA. Se isso soa familiar, faça uma auditoria básica de shadow AI antes de presumir que um arquivo de texto público corrigirá o risco.
Implicações para SEO
llms.txt não é um fator de ranqueamento em nenhum sentido estabelecido. Não escreva um esperando um aumento de tráfego na semana que vem.
O argumento indireto de SEO é mais modesto:
- ele força uma reflexão sobre o que é canônico;
- pode ajudar sistemas de busca e resposta mediados por IA a entender seu site;
- esclarece preferências de atribuição;
- reduz ambiguidade em torno de páginas arquivadas;
- cria uma política pública e inspecionável de uso de conteúdo por IA.
Isso vale a pena para alguns sites. Não é uma camada mágica de otimização.
A melhor versão de llms.txt é pequena, atual e alinhada ao restante do seu site. Se suas regras de robots, página de termos, sitemap, tags canônicas e llms.txt dizem coisas diferentes, o problema não é o rastreamento por IA. O problema é governança.
<!-- tool-cta:start -->
💡 Experimente isto: Como llms.txt não pode ser imposto, combine-o com regras que possam ser impostas e verifique-as no Robots.txt Tester para que os crawlers que seguem os padrões se comportem corretamente.
<!-- tool-cta:end -->
Uma recomendação final
Se seu site tem documentação, conteúdo editorial ou preocupações de licenciamento, crie um llms.txt simples. Mantenha-o com poucas dezenas de linhas. Use-o para apontar para recursos canônicos e declarar suas preferências de reutilização.
Mas não confunda comunicação com controle.
Para bloqueio, use os mecanismos de crawler disponíveis para você e entenda seus limites. Para política, publique termos claros. Para confiança, seja transparente com os leitores. llms.txt pertence a esse conjunto como um sinal útil — não como um escudo.
Perguntas frequentes
O llms.txt é um padrão oficial?
O llms.txt impedirá empresas de IA de treinar com meu conteúdo?
Onde devo colocar o llms.txt?
O llms.txt deve incluir todas as páginas do meu site?
O llms.txt ajuda em SEO?
Fontes e leituras adicionais