Како написати robots.txt који заиста блокира AI скрејпере
Практичан водич за блокирање AI кроулера који поштују правила, разумевање ограничења robots.txt и додавање серверских контрола тамо где су важне.
Sadržaj
- Непријатна истина о robots.txt
- Шта robots.txt може, а шта не може
- Почните од одлуке о политици
- Разуман robots.txt шаблон за блокирање AI кроулера
- Будите пажљиви са Google-Extended
- Тестирајте датотеку као продукциони код
- Додајте серверске контроле за ботове који игноришу правила
- Ограничење брзине захтева
- Филтрирање user-agent-а
- IP и ASN контроле
- Аутентификација и paywall-ови
- Минимизација садржаја
- Користите robots meta ознаке за правила на нивоу странице
- Пратите логове након објављивања
- Нека датотека буде мала и редовно прегледана
- Закључак
Непријатна истина о robots.txt
Датотека robots.txt није брава. Она је натпис на вратима.
Та разлика је важна када тимови питају да ли могу да „блокирају AI скрејпере” једном малом текстуалном датотеком. За реномиране кроулере који поштују Robots Exclusion Protocol, да: правилно написан robots.txt може да им каже да не пописују ваше странице. За непознате скрејпере, имитаторе, аутоматизацију прегледача и ботове које једноставно није брига, сам по себи неће урадити ништа.
Зато практичан циљ није „учинити скрејповање немогућим”. Циљ је:
- Рећи AI кроулерима који поштују правила да не користе ваш сајт.
- Избећи случајно блокирање претраживача или корисних сервиса.
- Додати јаче серверске контроле за злоупотребу.
- Одржавати политику тако да остане употребљива како се имена кроулера мењају.
То је досадна верзија. То је уједно и верзија која ради.
Шта robots.txt може, а шта не може
Датотека robots.txt налази се у корену сајта:
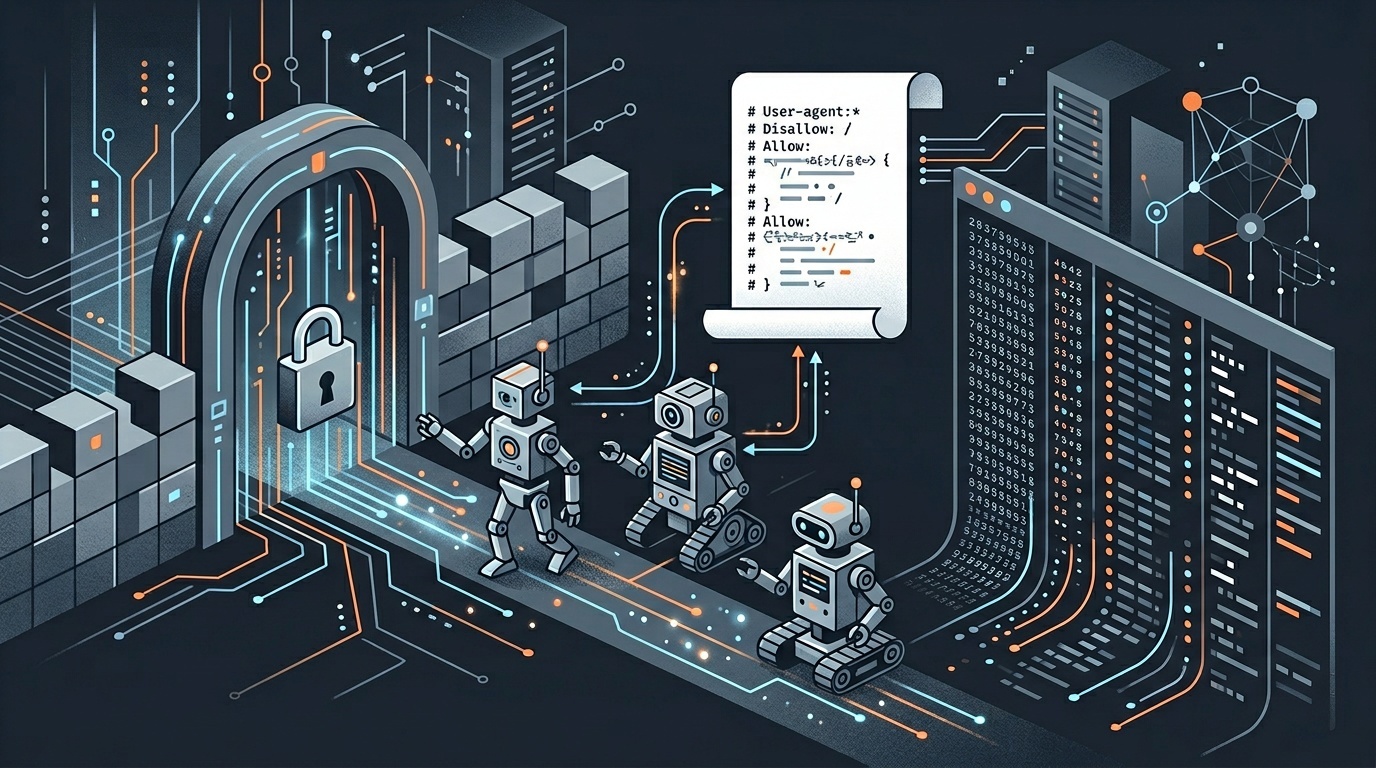
https://example.com/robots.txtКроулери је траже пре пописивања. Датотека садржи групе правила. Свака група почиње једном или више линија User-agent, након којих следе директиве Allow или Disallow.
Једноставно блокирање целог сајта изгледа овако:
User-agent: GPTBot
Disallow: /
То значи: ако си GPTBot, немој да пописујеш ништа на овом сајту.
Али robots.txt има чврста ограничења:
- Добровољан је. Злонамерни актери могу да га игноришу.
- Не спречава да URL буде затражен из обичног прегледача или скрипте.
- Не уклања садржај који је већ прикупљен негде другде.
- Сам по себи не дефинише ауторска права, лиценцирање или права на тренинг.
- Може бити погрешно конфигурисан тако да блокира погрешне ботове.
Ако вам је потребна стварна контрола приступа, користите аутентификацију, ауторизацију, ограничење брзине захтева, контроле засноване на IP адресама, управљање ботовима или правне механизме. Robots.txt је и даље користан, али припада широј стратегији заштите садржаја.
Ово је слично другим проблемима управљања на вебу: видљива контрола ретко је цела контрола. Ако ваша организација већ има неконтролисану интерну употребу AI алата, важи исти принцип; брза shadow AI провера често је кориснија од претварања да један документ политике решава проблем.
Почните од одлуке о политици
Пре уређивања датотеке, одлучите шта заправо покушавате да блокирате.
Постоје најмање четири различите ствари на које људи мисле када кажу „AI скрејпер”:
- Кроулери који се користе за прикупљање података за тренинг.
- Кроулери AI претраге или система за одговоре.
- Фетчери које покреће корисник, на пример када неко затражи од AI производа да сажме URL.
- Генерички скрејпери који се представљају као обични прегледачи.
Можда желите да блокирате све њих. Или можда желите видљивост у претрази, али да се изузмете из тренинга модела. То нису исте политике.
На пример, OpenAI документује засебне user agent вредности за различите намене, укључујући GPTBot, ChatGPT-User и OAI-SearchBot. Google користи Google-Extended као контролни токен за неке Gemini и Vertex AI случајеве употребе, док обично пописивање за Google Search обављају други Googlebot user agent-и.
Та раздвојеност је важна. Ако непажљиво блокирате широке user agent-е, можете оштетити уобичајену видљивост у претрази док покушавате да блокирате AI тренинг.
Разуман robots.txt шаблон за блокирање AI кроулера
Ево конзервативне почетне тачке за блокирање неколико често документованих AI кроулера, уз остављање општих кроулера претраживача на миру:
# AI training and AI product crawlers
User-agent: GPTBot
Disallow: /

User-agent: ChatGPT-User
Disallow: /

User-agent: OAI-SearchBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Claude-Web
Disallow: /

User-agent: PerplexityBot
Disallow: /

User-agent: Amazonbot
Disallow: /

User-agent: Bytespider
Disallow: /

User-agent: Meta-ExternalAgent
Disallow: /

# Default rule for other crawlers
User-agent: *
Allow: /
Ово није магична универзална листа. То је образац који се може одржавати.
Неколико напомена:
Disallow: /значи „не пописуј ниједну путању”.User-agent: *примењује се на кроулере који се не поклапају са специфичнијом групом.Allow: /није строго неопходан за подразумевану групу, али јасно показује вашу намеру.- Коментари нека буду кратки. Неки парсери су толерантни, али robots.txt треба да остане досадан.
- Не укључујте приватне URL-ове у robots.txt. Датотека је јавна, а навођење осетљивих путања може да их рекламира.
Последњу ставку вреди поновити. Robots.txt није механизам тајности. Ако /client-contracts/ не треба да буде јавно, заштитите га аутентификацијом. Немојте га само забранити.
Будите пажљиви са Google-Extended
Google-Extended се често погрешно разуме. То није исто што и блокирање Google Search-а.
Према Google документацији, Google-Extended је самосталан токен производа који издавачи могу да користе како би управљали тиме да ли садржај сајта може да помогне у побољшању одређених Gemini и Vertex AI могућности. Његово блокирање не би само по себи требало да блокира Googlebot у пописивању за Search.
Ипак, не замењујте све Google директиве широким блокирањем као што је ово, осим ако то заиста мислите:
User-agent: Googlebot
Disallow: /
То би рекло главном кроулеру Google Search-а да не пописује ваш сајт. За већину јавних веб-сајтова, то није оно што желите.
Иста разлика важи и другде. Неки добављачи раздвајају кроулере за тренинг од прегледања које покреће корисник или кроулера AI претраге. Други то не раде. Морате да прочитате документацију за ботове који су вам важни и да свој robots.txt третирате као живу датотеку, а не као једнократно поље за штиклирање.
Тестирајте датотеку као продукциони код
Robots.txt изгледа једноставно, због чега га је лако покварити.
Честе грешке укључују:
- Отпремање на погрешно место, као што је
/assets/robots.txtуместо/robots.txt. - Коришћење типографских наводника копираних из уређивача докумената.
- Случајно блокирање свих кроулера помоћу
User-agent: *иDisallow: /. - Претпоставку да датотека једног домена важи и за други поддомен.
- Заборављање да се
http://,https://,wwwи non-wwwхостови могу обрађивати различито у зависности од вашег подешавања.
За сајтове са више домена, проверите сваки канонски хост. Robots датотека на https://www.example.com/robots.txt не управља аутоматски адресом https://app.example.com/robots.txt.
Када отклањате грешке, прегледајте стварни HTTP одговор, а не само оно што приказује преглед у вашем CMS-у. Желите одговор 200 OK, тип садржаја text/plain ако је могуће и тачно ону датотеку коју очекујете. Ако су укључена преусмеравања, кеширање или CDN правила, преглед сирових заглавља помаже. Ток рада из текста отклањање грешака у преусмеравањима и HTTP заглављима у продукцији директно се примењује и овде.
Додајте серверске контроле за ботове који игноришу правила
Ако је кроулер усаглашен, robots.txt је најчистији сигнал. Ако је кроулер злоупотребљавајући, потребна вам је примена правила.
Практичне контроле укључују:
Ограничење брзине захтева
Поставите прагове за необичне обрасце захтева: превише страница у минути, дубоко пролазак кроз пагинацију, понављане 404 грешке или велики обим захтева са малог скупа IP адреса. Ограничења брзине треба да буду довољно великодушна да не кажњавају стварне кориснике и довољно строга да масовно извлачење учине скупим.
Филтрирање user-agent-а
Документоване user agent-е AI кроулера можете блокирати на веб-серверу, обрнутом проксију, CDN-у или слоју апликације. Ово је јаче од robots.txt јер враћа стварни одговор одбијања.
На пример, Nginx може да блокира образац user agent-а, мада продукциона правила треба пажљиво тестирати:
if ($http_user_agent ~* "GPTBot|CCBot|ClaudeBot|Bytespider") {
    return 403;
}
Ово није савршено решење. User-agent стрингове је лако лажирати. Али зауставља поштен или лењ саобраћај и смањује оптерећење.
IP и ASN контроле
Неки оператери објављују IP опсеге, али многи екосистеми скрејпера то не раде. Блокирање засновано на IP адресама може да ради за очигледну злоупотребу, посебно из опсега cloud хостинга без нормалног корисничког саобраћаја, али може да створи и лажно позитивне резултате. Користите логове пре правила.
Аутентификација и paywall-ови
Ако садржај не сме да се копира у великом обиму, немојте стављати цео садржај на јавни URL. Robots.txt није погодан за поверљив материјал, лиценциране базе података, приватне заједнице или плаћене архиве.
Минимизација садржаја
Понекад је најбоља заштита архитектонска. Не излажите непотребне API-је, велике JSON payload-е, скривене метаподатке, draft endpoint-е или целе архиве ако јавној страници треба само мали подскуп. Сајтови са много слика такође треба да размисле које метаподатке објављују; логика приватности из текста уклањање EXIF метаподатака пре дељења фотографија на интернету важи и за операције са садржајем.
Користите robots meta ознаке за правила на нивоу странице
Robots.txt контролише пописивање. Robots meta ознаке и X-Robots-Tag заглавља контролишу индексирање и понашање исечака за претраживаче и кроулере који поштују правила.
На пример:
<meta name="robots" content="noindex, noarchive">Или као HTTP заглавље:
X-Robots-Tag: noindex, noarchiveОво нису штитови специфични за AI. Корисни су када желите да страница буде доступна, али не и индексирана. Међутим, ако кроулеру блокирате преузимање странице у robots.txt, он можда никада неће видети meta ознаку на нивоу странице. Не ослањајте се на noindex ознаку на URL-у који је кроулеру забрањено да пописује.
Грубо правило:
- Користите robots.txt да смањите или спречите пописивање.
- Користите meta robots или
X-Robots-Tagда контролишете понашање индексирања. - Користите серверске контроле да спроведете приступ.
Пратите логове након објављивања
Објављивање датотеке је само први корак. Након тога, проверите логове.
Потражите:
- Захтеве ка
/robots.txtод user agent-а које сте навели. - Настављено пописивање након што су испоручена disallow правила.
- Сумњиве user agent-е са великим обимом саобраћаја.
- User agent-е налик прегледачима који траже хиљаде страница у низу.
- Поновљен приступ feed-овима, sitemap-овима, страницама претраге и пагинацији.
Ако бот затражи robots.txt, види потпуну забрану и затим стане, robots.txt је урадио свој посао. Ако настави, пребаците тог бота у примену правила: ограничења брзине, блокаде или аутентификацију.
Такође прегледајте изложеност својих sitemap-ова. Sitemap-ови су корисни за претраживаче, али су и погодне мапе за скрејпере. То не значи да треба да их уклоните са обичних сајтова. Значи да не треба да укључујете URL-ове које не желите да јавни системи открију.
Нека датотека буде мала и редовно прегледана
Robots.txt временом пропада. Маркетиншки тим дода campaign microsite. Developer дода staging путању. Добављач промени име кроулера. Две године касније нико не зна зашто постоји половина правила.
Третирајте га као конфигурацију:
- Чувајте га у систему за контролу верзија када је могуће.
- Додајте кратак коментар за сваку групу AI кроулера.
- Прегледајте га квартално.
- Проверите документацију добављача пре додавања широких правила.
- Тестирајте након промена на CDN-у, CMS-у или хостингу.
Ако ваш сајт објављује садржај потпомогнут AI алатима, такође раздвојте политику за кроулере од уредничке транспарентности. Блокирање AI скрејпера односи се на приступ и поновну употребу. Обелодањивање се односи на поверење читалаца. Етички се преклапају, али нису иста контрола. Практичан приступ обелодањивању обрађен је у тексту како изгледа искрено AI обелодањивање на малом веб-сајту.
<!-- tool-cta:start -->
💡 Испробајте ово: Након додавања правила за AI crawler-е, проверите синтаксу помоћу Robots.txt Tester како не бисте случајно блокирали и легитимне ботове.
<!-- tool-cta:end -->
Закључак
Добра датотека robots.txt блокираће AI кроулере који поштују правила. Неће зауставити упорно скрејповање, копиране user-agent стрингове, компромитоване прегледаче или људе који ручно налепљују ваш садржај у AI системе.
То је не чини бескорисном. То је чини једним слојем.
Напишите експлицитна правила за документоване AI кроулере. Избегавајте широка блокирања која оштећују видљивост у претрази. Тестирајте испоручену датотеку, не нацрт. Пратите логове. Спроводите правила серверским контролама тамо где понашање прелази из нежељеног у злоупотребљавајуће.
Веб је одувек функционисао као мешавина протокола, норми и примене правила. Robots.txt је слој норми. Користите га, али га немојте помешати са зидом.
Često postavljana pitanja
Може ли robots.txt да спречи AI компаније да тренирају моделе на мом садржају?
Да ли треба да блокирам User-agent: * да зауставим све скрејпере?
Да ли је Google-Extended исто што и Googlebot?
Шта ако AI скрејпер игнорише robots.txt?
Да ли су ми потребни и robots.txt и meta robots ознаке?
Izvori i dalja literatura