Varför din Time to First Byte är långsam och vad du kan göra åt det
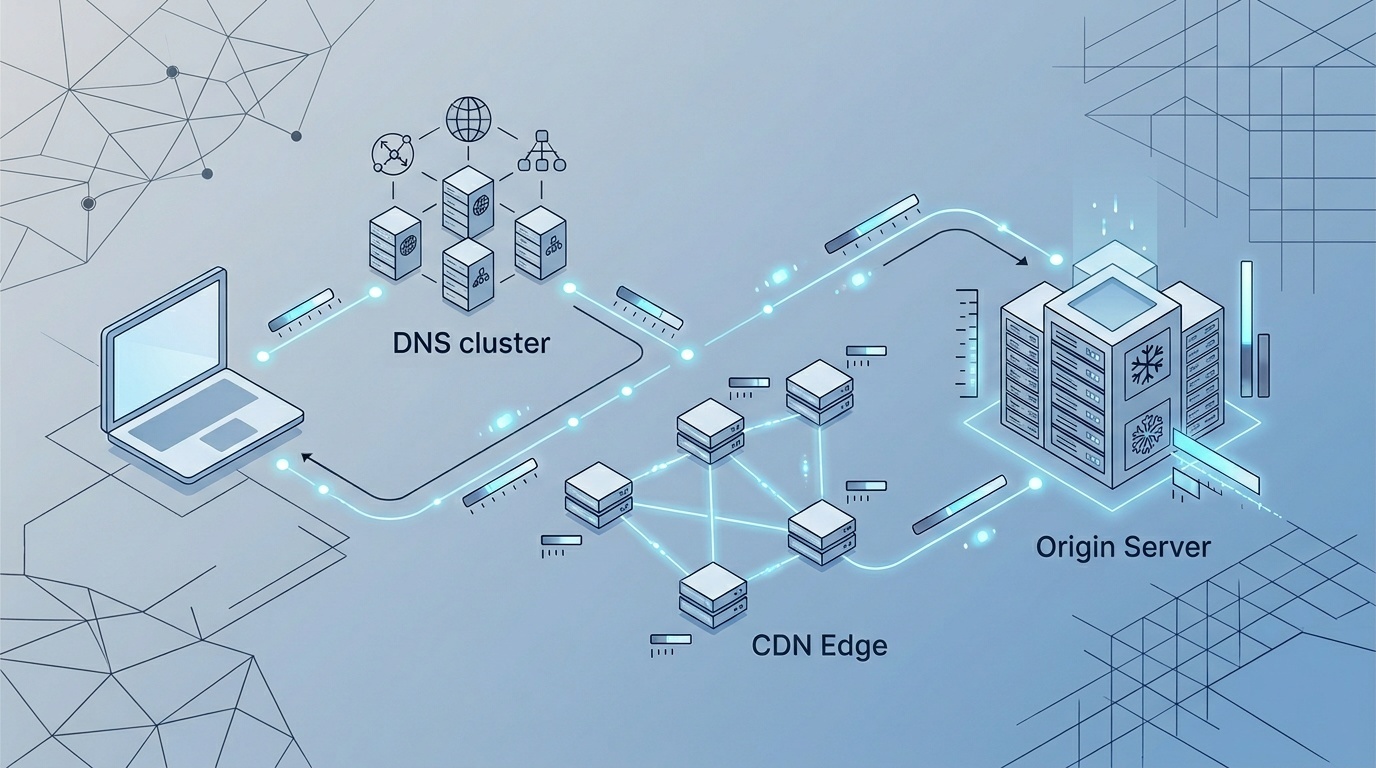
TTFB är inte en enskild bugg. Det är den synliga fördröjningen som orsakas av DNS, anslutningsetablering, CDN-routing, serverarbete, cachemissar och ibland en enda långsam databasfråga.
Innehållsförteckning
- Börja med vad TTFB faktiskt mäter
- Vad räknas som en långsam TTFB?
- Mät på mer än ett ställe
- 1. Webbläsarens utvecklarverktyg
- 2. Syntetiska tester från flera regioner
- 3. Real user monitoring eller serverloggar
- De vanliga orsakerna till långsam TTFB
- Din HTML cachas inte
- Ditt CDN cachar bara resurser
- Din server gör för mycket innan den svarar
- Databasfrågor är långsamma eller oförutsägbara
- Din applikation har cold starts
- Redirects slösar bort den första förfrågan
- En praktisk felsökningssekvens
- Steg 1: Testa huvuddokumentet, inte bara hela sidan
- Steg 2: Jämför regioner
- Steg 3: Granska svarshuvuden
- Steg 4: Kontrollera origin-timing
- Steg 5: Åtgärda den största bekräftade fördröjningen
- Åtgärder som brukar fungera
- Cacha publik HTML vid edge
- Flytta icke-kritiskt arbete ut ur förfrågningsvägen
- Minska backend-beroendekedjor
- Placera beräkning närmare användarna
- Håll redirects tråkiga
- Vad du inte ska göra
- Den lugna versionen av planen
Börja med vad TTFB faktiskt mäter
Time to First Byte, oftast förkortat TTFB, är tiden mellan att webbläsaren begär en resurs och att den tar emot den första byten i svaret.
Det låter som ett servermått, men det är inte bara ett servermått. TTFB omfattar flera steg:
- DNS-uppslagning, om värdnamnet inte redan är uppslaget
- Etablering av TCP-anslutning
- TLS-förhandling för HTTPS
- Förfrågans restid till servern eller CDN-noden
- Köande och bearbetning på servern
- Svarets restid tillbaka till webbläsaren
Så en hög TTFB kan betyda att din backend är långsam. Den kan också betyda att användaren är långt från ditt origin, att ditt CDN är felkonfigurerat, att din cache ständigt missar eller att din server lägger för lång tid på att bestämma vad den ska skicka.
Det här spelar roll eftersom TTFB ligger nära början av laddningskedjan. Om HTML-dokumentet kommer sent upptäcker webbläsaren även CSS, JavaScript, typsnitt och bilder sent. Du kan ha utmärkt front-end-optimering och ändå upplevas som långsam om det första dokumentsvaret tar 1,5 sekunder.
Vad räknas som en långsam TTFB?
Det finns inget universellt tal som passar varje webbplats, region och arkitektur. Ändå hjälper praktiska tröskelvärden.
Googles vägledning på web.dev klassificerar en bra TTFB som under 800 ms, där 800–1800 ms behöver förbättras och över 1800 ms anses dåligt. För en väl cachad marknadsföringssida som levereras nära användaren kan du ofta prestera mycket bättre än så. För en komplex autentiserad kontrollpanel som utför dynamiskt arbete kan den acceptabla siffran vara högre, men den bör fortfarande gå att förklara.
Den viktiga vanan är att segmentera siffran. En global genomsnittlig TTFB på 900 ms kan dölja ett svar på 150 ms för användare nära din CDN-nod och ett svar på 2200 ms för användare i en annan region. På samma sätt kan din startsida vara okej medan sök-, kategori- eller inloggade sidor är tyst plågsamma.
Mät på mer än ett ställe
Diagnostisera inte TTFB utifrån en enda Lighthouse-körning. Lighthouse är användbart, men det är ett test från en miljö. Om du är ny på att tolka det, börja med en lugn genomgång av hur man läser en Lighthouse-rapport utan att få panik — huvudpoängen är att skilja labbsignaler från verkligheten i fält.
För TTFB vill du ha minst tre vyer:
1. Webbläsarens utvecklarverktyg
Öppna Network-panelen, ladda om med cache inaktiverad och granska förfrågan för huvuddokumentet. Tidsuppdelningen visar faserna DNS, anslutning, TLS, väntan och nedladdning. Fasen ”waiting” är ofta det folk menar med backend-tid, även om den kan inkludera uppströmslatens.
2. Syntetiska tester från flera regioner
Kör tester från platser som ligger nära och långt från dina användare. Om TTFB är låg i en region och hög i en annan, misstänk geografi, CDN-routing, origin-placering eller cachetäckning innan du skriver om applikationskod.
3. Real user monitoring eller serverloggar
Fältdata berättar vad verkliga användare upplever över enheter, nätverk och sessioner. Serverloggar kan berätta om origin genererade ett svar snabbt. Skillnaden mellan klientobserverad TTFB och origin-bearbetningstid är ofta där CDN- och nätverksproblem blir synliga.
De vanliga orsakerna till långsam TTFB
Din HTML cachas inte
Det här är det vanligaste problemet på innehållssajter och e-handelssajter. Statiska resurser cachas aggressivt, men HTML-dokumentet — det webbläsaren behöver först — genereras vid varje förfrågan.
Ibland är det nödvändigt. Ofta är det inte det.
Om en publik sida ändras några gånger per dag bör den förmodligen inte kräva en färsk databasrendering för varje anonym besökare. Använd helsidscache, edge-cache, statisk generering eller stale-while-revalidate-mönster där det är lämpligt.
Kontrollera svarshuvuden efter signaler som Cache-Control, CDN-Cache-Status, Age, Vary och Set-Cookie. En sida som skickar en unik cookie till varje besökare kan av misstag göra sig själv omöjlig att cacha. Om du behöver ett praktiskt sätt att resonera om det här lagret gäller samma felsökningsvanor i vår guide till redirects och HTTP-headers i produktion direkt för TTFB-arbete.
Ditt CDN cachar bara resurser
Många team lägger till ett CDN och antar att prestandajobbet är klart. Men om CDN:et bara levererar bilder, CSS och JavaScript kan den första HTML-förfrågan fortfarande behöva gå hela vägen till en enda origin-server.
Det kan fungera bra för en lokal företagssajt med lokala användare. Det fungerar inte bra för en internationell publik. Ju längre användaren är från origin, desto mer latens betalar du innan backend-arbetet ens börjar.
Bra CDN-konfiguration för TTFB innebär vanligtvis att du:
- Cachar publik HTML där det är säkert
- Respekterar avsiktliga bypass-regler för autentiserade eller personaliserade sidor
- Undviker onödiga
Vary-headers som delar upp cachen för fint - Använder cachetömning eller revalidering i stället för att inaktivera cache helt
- Bekräftar att edge-platser faktiskt levererar träffar, inte vidarebefordrar varje förfrågan
Ett CDN är inte magi. Det är ett cache- och routinglager. Behandla det som ett sådant.
Din server gör för mycket innan den svarar
En långsam backend-väg kan komma från många små fördröjningar: databasfrågor, API-anrop, mallrendering, feature flag-kontroller, autentisering, personalisering, loggning och cold starts.
Det värsta mönstret är seriellt beroendearbete. Till exempel:
- Hämta siddata
- Hämta sedan relaterade produkter
- Hämta sedan priser
- Anropa sedan en rekommendationstjänst
- Rendera sedan HTML
Om varje steg väntar på det föregående växer TTFB snabbt. Parallellisera oberoende arbete, ta bort icke-kritiska anrop från det första svaret och cacha kostsamma resultat.
En användbar regel: om användaren inte kan se eller använda resultatet omedelbart bör det förmodligen inte blockera den första byten.
Databasfrågor är långsamma eller oförutsägbara
Databaser orsakar ofta TTFB-problem eftersom de beter sig bra i utveckling och dåligt under verklig trafik. Saknade index, stora joins, N+1-frågor, låskontention och överdimensionerade resultatmängder visar sig alla som ”servern är långsam”.
Gissa inte här. Fånga frågetider för långsamma förfrågningar. Titta på p95 och p99, inte bara genomsnitt. En sida som vanligtvis svarar på 120 ms men ibland blockerar i 4 sekunder skapar ändå en dålig användarupplevelse.
Vanliga åtgärder inkluderar:
- Lägga till eller korrigera index
- Ta bort N+1-frågemönster
- Cacha lästung data
- Paginera stora frågor
- Flytta rapporterings- eller analysfrågor bort från förfrågningstid
- Sätta rimliga timeouts för nedströmsanrop
Din applikation har cold starts
Serverless- och containeriserade plattformar kan vara utmärkta, men cold starts kan skada TTFB när trafiken är ryckig eller regioner är underprovisionerade.
Om din första förfrågan efter inaktiv tid är mycket långsammare än senare förfrågningar, undersök cold starts. Du kan behöva provisioned concurrency, mindre bundles, färre startberoenden, varmare funktioner eller en annan deploymentsform för latenskänsliga routes.
Det här är inte ett argument mot serverless. Det är ett argument mot att låtsas att runtime-modellen är osynlig.
Redirects slösar bort den första förfrågan
En redirect lägger till ytterligare en förfrågan–svar-cykel innan webbläsaren tar emot det slutliga dokumentet. En redirect från http:// till https:// kan vara oundviklig för gamla länkar, men kedjor är slösaktiga.
Vanliga kedjor inkluderar:
http://example.com→https://example.com→https://www.example.com- normalisering av avslutande snedstreck efter protokollnormalisering
- geo- eller språk-redirects före cacheuppslagning
- äldre kampanjlänkar som hoppar genom flera URL:er
Åtgärda källänkarna där det är möjligt, slå ihop redirect-regler och gör kanoniska URL:er direkta. Redirect-tid rapporteras inte alltid som TTFB för den slutliga förfrågan, men användaren betalar ändå för den.
En praktisk felsökningssekvens
När TTFB ser långsam ut, använd den här ordningen. Den undviker det vanliga misstaget att optimera applikationskod innan cache- och routingbeteende har bekräftats.
Steg 1: Testa huvuddokumentet, inte bara hela sidan
Hitta förfrågan för HTML-dokumentet. Registrera total TTFB och tidsuppdelningen. Upprepa med och utan webbläsarcache. Testa en publik sida, en dynamisk sida och en inloggad sida om det är relevant.
Steg 2: Jämför regioner
Kör samma URL från flera geografiska platser. Om de långsamma regionerna korrelerar med avstånd från origin, prioritera CDN och edge-cache. Om varje region är långsam, titta på backend-bearbetning och origin-kapacitet.
Steg 3: Granska svarshuvuden
Leta efter cache-headers, cookies, Age, CDN-status och Vary. En saknad Age-header eller upprepade cachemissar är ledtrådar. En bred Vary: Cookie-header på publik HTML är ofta en cachedödare.
Steg 4: Kontrollera origin-timing
Lägg till server timing-instrumentering. Headern Server-Timing kan exponera backend-faser som databastid, renderingstid och tid för uppströms-API. Även enkla etiketter är användbara:
Server-Timing: db;dur=82, render;dur=41, api;dur=210Nu kan dina webbläsartider visa om servern lade 300 ms på faktiskt arbete eller om fördröjningen uppstod innan förfrågan nådde din applikation.
Steg 5: Åtgärda den största bekräftade fördröjningen
Det låter självklart, men team åtgärdar ofta det som är bekant snarare än det som är uppmätt. Om cachemissar dominerar, åtgärda cachning. Om databasen dominerar, åtgärda frågor. Om TLS och anslutningsetablering dominerar för globala användare, åtgärda routing, CDN-täckning eller origin-geografi.
Front-end-arbete spelar fortfarande roll. Typsnitt, bilder och JavaScript påverkar vad som händer efter att HTML har kommit. Men de ersätter inte ett snabbt första svar. Om du också arbetar med renderingsprestanda är web fonts fortfarande en av de enklaste vinsterna på många sajter eftersom de påverkar hur snabbt text blir användbar efter att dokumentet har kommit.
Åtgärder som brukar fungera
Cacha publik HTML vid edge
För marknadsföringssidor, dokumentation, bloggar, landningssidor och kategorisidor är edge-cache ofta den största TTFB-förbättringen. Använd korta TTL:er om innehållet ändras ofta. Använd stale-while-revalidate om något inaktuellt innehåll är acceptabelt medan cachen uppdateras i bakgrunden.
Var försiktig med personalisering. Om en sida varierar efter valuta, språk, inloggningsstatus eller experimentgrupp, definiera dessa varianter explicit. Oavsiktlig variation per användare förstör cacheeffektiviteten.
Flytta icke-kritiskt arbete ut ur förfrågningsvägen
E-postutskick, analysberikning, rekommendationsgenerering, webhook-anrop och tung loggning bör sällan blockera den första byten. Lägg dem i köer eller kör dem efter att svaret har påbörjats.
Minska backend-beroendekedjor
Parallellisera oberoende anrop. Cacha svar från långsamma API:er. Sätt timeouts. Utforma fallback-innehåll för tjänster som är hjälpsamma men inte nödvändiga.
En långsam rekommendationswidget bör inte fördröja hela produktsidan.
Placera beräkning närmare användarna
Om dina användare är globala och ditt origin ligger i en region är latens strukturell. CDN-cache kan dölja mycket av detta för publikt innehåll. För dynamiskt innehåll kan du överväga regionala deployments, edge-rendering för lämpliga routes eller att flytta API:er närmare publiken.
Håll redirects tråkiga
Kanonisera URL:er i ett hopp. Uppdatera interna länkar så att användare och crawlers går direkt till slutdestinationen. Granska gamla kampanj-URL:er och plattformsmigreringar. Redirects är lätta att ignorera eftersom de är osynliga när de fungerar, men de kostar fortfarande tid.
Vad du inte ska göra
Jaga inte en perfekt TTFB-siffra för varje route. En autentiserad rapport som utför verklig beräkning kommer inte att bete sig som ett cachat blogginlägg.
Använd inte genomsnittlig TTFB som ditt enda mått. Percentiler spelar roll. Geografi spelar roll. Sidtyp spelar roll.
Anta inte att ett CDN innebär att din HTML är cachad. Verifiera det.
Och behandla inte TTFB som skilt från produktbeslut. Personalisering, experiment, realtidslager och tredjepartstjänster har alla latenskostnader. Vissa är värda det. Vissa är bara vana.
<!-- tool-cta:start -->
💡 Prova detta: När du diagnostiserar TTFB avslöjar Get Headers cachestatus, servertider och omdirigeringar som ofta förklarar var fördröjningen kommer ifrån.
<!-- tool-cta:end -->
Den lugna versionen av planen
En långsam TTFB går oftast att åtgärda när du slutar behandla den som ett vagt ”serverproblem”. Mät dokumentförfrågan. Segmentera efter region och sidtyp. Granska headers. Jämför klienttiming med origin-timing. Åtgärda sedan den största bekräftade flaskhalsen.
De flesta sajter behöver inte exotisk arkitektur. De behöver färre undvikbara cachemissar, mindre blockerande backend-arbete, renare redirects och en tydligare bild av vad som måste hända innan den första byten skickas.
Vanliga frågor
Är TTFB ett Core Web Vitals-mått?
Vad är ett bra TTFB-mål?
Kommer ett CDN automatiskt att åtgärda TTFB?
Kan JavaScript-optimering förbättra TTFB?
Varför är min TTFB långsam bara för inloggade användare?
Källor och vidare läsning