Perché il tuo Time to First Byte è lento e cosa fare al riguardo
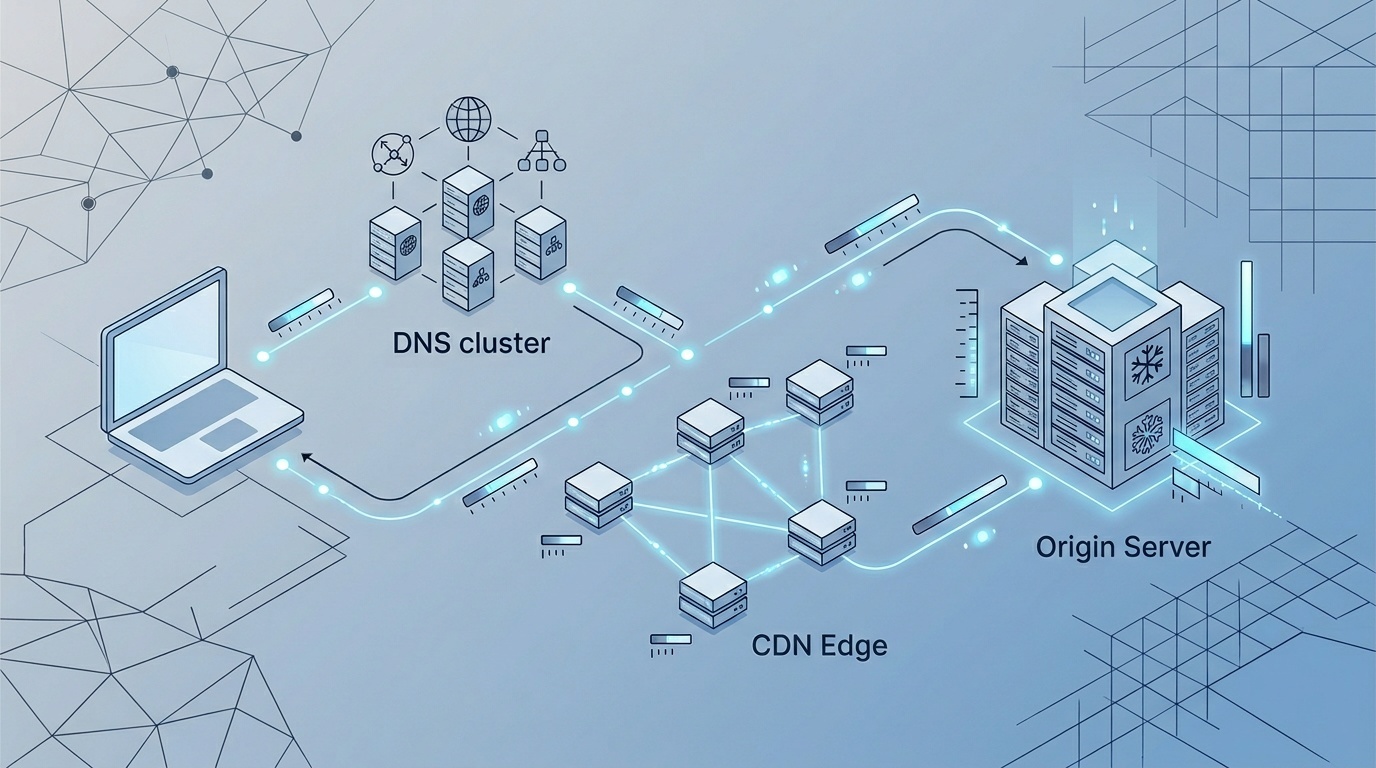
Il TTFB non è un singolo bug. È il ritardo visibile causato da DNS, configurazione della connessione, routing CDN, lavoro del server, cache miss e, a volte, una singola query di database lenta.
Indice
- Parti da ciò che il TTFB misura davvero
- Cosa conta come TTFB lento?
- Misuralo in più di un punto
- 1. Strumenti per sviluppatori del browser
- 2. Test sintetici da più regioni
- 3. Real user monitoring o log del server
- Le cause abituali di un TTFB lento
- Il tuo HTML non viene memorizzato in cache
- La tua CDN memorizza in cache solo gli asset
- Il tuo server fa troppo prima di rispondere
- Le query di database sono lente o imprevedibili
- La tua applicazione ha cold start
- I redirect stanno sprecando la prima richiesta
- Una sequenza pratica di debug
- Step 1: Testa il documento principale, non solo l’intera pagina
- Step 2: Confronta le regioni
- Step 3: Ispeziona gli header di risposta
- Step 4: Controlla i tempi dell’origin
- Step 5: Correggi il maggiore ritardo confermato
- Correzioni che di solito funzionano
- Memorizza in cache l’HTML pubblico all’edge
- Sposta il lavoro non critico fuori dal percorso della richiesta
- Riduci le catene di dipendenze backend
- Metti il calcolo più vicino agli utenti
- Mantieni i redirect noiosi
- Cosa non fare
- La versione calma del piano
Parti da ciò che il TTFB misura davvero
Time to First Byte, di solito abbreviato in TTFB, è il tempo che passa tra la richiesta di una risorsa da parte del browser e la ricezione del primo byte della risposta.
Sembra una metrica del server, ma non è solo una metrica del server. Il TTFB include diversi passaggi:
- Lookup DNS, se l’hostname non è già risolto
- Configurazione della connessione TCP
- Negoziazione TLS per HTTPS
- Tempo di percorrenza della richiesta verso il server o l’edge CDN
- Accodamento ed elaborazione sul server
- Tempo di percorrenza della risposta verso il browser
Quindi un TTFB elevato può significare che il tuo backend è lento. Può anche significare che l’utente è lontano dalla tua origin, che la tua CDN è configurata male, che la tua cache manca continuamente, o che il server impiega troppo tempo a decidere cosa inviare.
Questo conta perché il TTFB si trova vicino all’inizio della catena di caricamento. Se il documento HTML arriva in ritardo, il browser scopre in ritardo anche CSS, JavaScript, font e immagini. Puoi avere un’ottima ottimizzazione front-end e risultare comunque lento se la prima risposta del documento richiede 1,5 secondi.
Cosa conta come TTFB lento?
Non esiste un numero universale adatto a ogni sito, regione e architettura. Tuttavia, soglie pratiche aiutano.
Le linee guida di Google web.dev classificano come buono un TTFB inferiore a 800 ms, tra 800 e 1800 ms come da migliorare, e sopra 1800 ms come scarso. Per una pagina marketing ben memorizzata in cache e servita vicino all’utente, spesso puoi fare molto meglio. Per una dashboard autenticata complessa che esegue lavoro dinamico, il numero accettabile può essere più alto, ma dovrebbe comunque essere spiegabile.
L’abitudine importante è segmentare il numero. Una media globale del TTFB di 900 ms può nascondere una risposta da 150 ms per utenti vicini al tuo edge CDN e una risposta da 2200 ms per utenti in un’altra regione. Allo stesso modo, la homepage può andare bene mentre pagine di ricerca, categoria o utenti loggati sono silenziosamente dolorose.
Misuralo in più di un punto
Non diagnosticare il TTFB da una singola esecuzione di Lighthouse. Lighthouse è utile, ma è un test da un solo ambiente. Se sei alle prime armi nell’interpretarlo, inizia con una lettura calma di come leggere un report Lighthouse senza farti prendere dal panico: la lezione principale è separare i segnali di laboratorio dalla realtà sul campo.
Per il TTFB, ti servono almeno tre viste:
1. Strumenti per sviluppatori del browser
Apri il pannello Network, ricarica con la cache disabilitata e ispeziona la richiesta del documento principale. La scomposizione dei tempi mostra le fasi DNS, connessione, TLS, attesa e download. La fase “waiting” è spesso ciò che le persone intendono per tempo backend, anche se può includere latenza upstream.
2. Test sintetici da più regioni
Esegui test da località vicine e lontane dai tuoi utenti. Se il TTFB è basso in una regione e alto in un’altra, sospetta geografia, routing CDN, posizionamento dell’origin o copertura della cache prima di riscrivere il codice applicativo.
3. Real user monitoring o log del server
I dati sul campo ti dicono cosa sperimentano gli utenti reali su dispositivi, reti e sessioni diverse. I log del server possono dirti se l’origin ha generato rapidamente una risposta. La differenza tra il TTFB osservato dal client e il tempo di elaborazione dell’origin è spesso il punto in cui emergono problemi di CDN e rete.
Le cause abituali di un TTFB lento
Il tuo HTML non viene memorizzato in cache
Questo è il problema più comune sui siti di contenuto e sui siti ecommerce. Gli asset statici vengono memorizzati in cache in modo aggressivo, ma il documento HTML — la cosa di cui il browser ha bisogno per prima — viene generato a ogni richiesta.
A volte è necessario. Spesso no.
Se una pagina pubblica cambia poche volte al giorno, probabilmente non dovrebbe richiedere un nuovo render da database per ogni visitatore anonimo. Usa full-page caching, edge caching, generazione statica o pattern stale-while-revalidate dove appropriato.
Controlla gli header di risposta per segnali come Cache-Control, CDN-Cache-Status, Age, Vary e Set-Cookie. Una pagina che invia un cookie univoco a ogni visitatore può rendersi accidentalmente non cacheabile. Se ti serve un modo pratico per ragionare su questo livello, le stesse abitudini di debug in la nostra guida a redirect e header HTTP in produzione si applicano direttamente al lavoro sul TTFB.
La tua CDN memorizza in cache solo gli asset
Molti team aggiungono una CDN e presumono che il lavoro sulle performance sia finito. Ma se la CDN serve solo immagini, CSS e JavaScript, la prima richiesta HTML potrebbe comunque viaggiare fino a un singolo server origin.
Può andare bene per il sito di un’attività locale con utenti locali. Non va bene per un pubblico internazionale. Più l’utente è lontano dall’origin, più latenza paghi prima ancora che il lavoro backend inizi.
Una buona configurazione CDN per il TTFB di solito significa:
- Memorizzare in cache l’HTML pubblico dove è sicuro
- Rispettare le regole intenzionali di bypass per pagine autenticate o personalizzate
- Evitare header
Varynon necessari che frammentano troppo la cache - Usare purging della cache o revalidation invece di disabilitare completamente la cache
- Confermare che le edge location stiano davvero servendo hit, non inoltrando ogni richiesta
Una CDN non è magia. È un livello di cache e routing. Trattala come tale.
Il tuo server fa troppo prima di rispondere
Un percorso backend lento può derivare da molti piccoli ritardi: query di database, chiamate API, rendering dei template, controlli di feature flag, autenticazione, personalizzazione, logging e cold start.
Il pattern peggiore è il lavoro seriale sulle dipendenze. Per esempio:
- Recupera i dati della pagina
- Poi recupera i prodotti correlati
- Poi recupera i prezzi
- Poi chiama un servizio di raccomandazioni
- Poi renderizza l’HTML
Se ogni passaggio aspetta quello precedente, il TTFB cresce rapidamente. Parallelizza il lavoro indipendente, rimuovi dalla prima risposta le chiamate non critiche e memorizza in cache i risultati costosi.
Una regola utile: se l’utente non può vedere o usare subito il risultato, probabilmente non dovrebbe bloccare il primo byte.
Le query di database sono lente o imprevedibili
I database causano spesso problemi di TTFB perché si comportano bene in sviluppo e male sotto traffico reale. Indici mancanti, join ampie, query N+1, contesa sui lock e result set troppo grandi compaiono tutti come “il server è lento”.
Qui non tirare a indovinare. Raccogli i tempi delle query per le richieste lente. Guarda p95 e p99, non solo le medie. Una pagina che di solito risponde in 120 ms ma occasionalmente si blocca per 4 secondi creerà comunque una cattiva esperienza utente.
Le correzioni comuni includono:
- Aggiungere o correggere indici
- Rimuovere pattern di query N+1
- Memorizzare in cache dati ad alta lettura
- Paginare query grandi
- Spostare query di reporting o analytics fuori dal tempo di richiesta
- Impostare timeout sensati per le chiamate downstream
La tua applicazione ha cold start
Le piattaforme serverless e containerizzate possono essere eccellenti, ma i cold start possono danneggiare il TTFB quando il traffico è intermittente o le regioni sono sotto-provisionate.
Se la prima richiesta dopo un periodo di inattività è molto più lenta delle richieste successive, indaga sui cold start. Potresti aver bisogno di provisioned concurrency, bundle più piccoli, meno dipendenze all’avvio, funzioni più calde o una forma di deployment diversa per le route sensibili alla latenza.
Questo non è un argomento contro il serverless. È un argomento contro il fingere che il modello runtime sia invisibile.
I redirect stanno sprecando la prima richiesta
Un redirect aggiunge un altro ciclo richiesta-risposta prima che il browser riceva il documento finale. Un redirect da http:// a https:// può essere inevitabile per vecchi link, ma le catene sono uno spreco.
Le catene comuni includono:
http://example.com→https://example.com→https://www.example.com- normalizzazione dello slash finale dopo la normalizzazione del protocollo
- redirect geografici o linguistici prima del lookup in cache
- vecchi link di campagna che saltano attraverso diversi URL
Correggi i link alla fonte dove possibile, consolida le regole di redirect e rendi diretti gli URL canonici. Il tempo di redirect non viene sempre riportato come TTFB della richiesta finale, ma l’utente lo paga comunque.
Una sequenza pratica di debug
Quando il TTFB sembra lento, usa questo ordine. Evita l’errore comune di ottimizzare il codice applicativo prima di confermare il comportamento di cache e routing.
Step 1: Testa il documento principale, non solo l’intera pagina
Trova la richiesta del documento HTML. Registra il TTFB totale e la scomposizione dei tempi. Ripeti con e senza cache del browser. Testa una pagina pubblica, una pagina dinamica e una pagina da utente loggato se rilevante.
Step 2: Confronta le regioni
Esegui lo stesso URL da diverse località geografiche. Se le regioni lente correlano con la distanza dall’origin, dai priorità a CDN ed edge caching. Se ogni regione è lenta, guarda l’elaborazione backend e la capacità dell’origin.
Step 3: Ispeziona gli header di risposta
Cerca header di cache, cookie, Age, stato CDN e Vary. Un header Age mancante o cache miss ripetuti sono indizi. Un header ampio Vary: Cookie sull’HTML pubblico è spesso un killer della cache.
Step 4: Controlla i tempi dell’origin
Aggiungi strumentazione di server timing. L’header Server-Timing può esporre fasi backend come tempo di database, tempo di render e tempo API upstream. Anche etichette semplici sono utili:
Server-Timing: db;dur=82, render;dur=41, api;dur=210Ora i timing del browser possono mostrare se il server ha speso 300 ms in lavoro reale o se il ritardo si è verificato prima che la richiesta raggiungesse la tua applicazione.
Step 5: Correggi il maggiore ritardo confermato
Sembra ovvio, ma i team spesso correggono ciò che è familiare invece di ciò che è misurato. Se dominano i cache miss, correggi la cache. Se domina il database, correggi le query. Se TLS e configurazione della connessione dominano per gli utenti globali, correggi routing, copertura CDN o geografia dell’origin.
Il lavoro front-end conta ancora. Font, immagini e JavaScript influenzano ciò che accade dopo l’arrivo dell’HTML. Ma non sostituiscono una prima risposta veloce. Se stai lavorando anche sulle performance di rendering, i web font restano una delle vittorie più facili su molti siti perché influenzano quanto rapidamente il testo diventa utilizzabile dopo l’arrivo del documento.
Correzioni che di solito funzionano
Memorizza in cache l’HTML pubblico all’edge
Per pagine marketing, documentazione, blog, landing page e pagine di categoria, l’edge caching è spesso il maggiore miglioramento del TTFB. Usa TTL brevi se il contenuto cambia spesso. Usa stale-while-revalidate se contenuti leggermente obsoleti sono accettabili mentre la cache si aggiorna in background.
Fai attenzione alla personalizzazione. Se una pagina varia per valuta, lingua, stato di login o gruppo di esperimento, definisci esplicitamente quelle varianti. La variazione accidentale per singolo utente distrugge l’efficienza della cache.
Sposta il lavoro non critico fuori dal percorso della richiesta
Invio email, arricchimento analytics, generazione di raccomandazioni, chiamate webhook e logging pesante dovrebbero raramente bloccare il primo byte. Mettili in code o eseguili dopo che la risposta è iniziata.
Riduci le catene di dipendenze backend
Parallelizza le chiamate indipendenti. Memorizza in cache le risposte da API lente. Imposta timeout. Progetta contenuti di fallback per servizi utili ma non essenziali.
Un widget di raccomandazioni lento non dovrebbe ritardare l’intera pagina prodotto.
Metti il calcolo più vicino agli utenti
Se i tuoi utenti sono globali e la tua origin è in una sola regione, la latenza è strutturale. La cache CDN può nasconderne molta per i contenuti pubblici. Per contenuti dinamici, valuta deployment regionali, edge rendering per route adatte, o lo spostamento delle API più vicino al pubblico.
Mantieni i redirect noiosi
Canonicalizza gli URL in un solo hop. Aggiorna i link interni così utenti e crawler vanno direttamente alla destinazione finale. Fai audit dei vecchi URL di campagna e delle migrazioni di piattaforma. I redirect sono facili da ignorare perché sono invisibili quando funzionano, ma costano comunque tempo.
Cosa non fare
Non inseguire un numero TTFB perfetto per ogni route. Un report autenticato che esegue calcoli reali non si comporterà come un post di blog in cache.
Non usare il TTFB medio come unica metrica. I percentili contano. La geografia conta. Il tipo di pagina conta.
Non presumere che una CDN significhi che il tuo HTML è in cache. Verificalo.
E non trattare il TTFB come separato dalle decisioni di prodotto. Personalizzazione, sperimentazione, inventario in tempo reale e servizi di terze parti hanno tutti costi di latenza. Alcuni valgono la pena. Alcuni sono solo abitudine.
<!-- tool-cta:start -->
💡 Prova questo: Durante la diagnosi del TTFB, Get Headers rivela lo stato della cache, i tempi del server e i reindirizzamenti che spesso spiegano da dove proviene il ritardo.
<!-- tool-cta:end -->
La versione calma del piano
Un TTFB lento di solito è risolvibile quando smetti di trattarlo come un vago “problema del server”. Misura la richiesta del documento. Segmenta per regione e tipo di pagina. Ispeziona gli header. Confronta il timing del client con il timing dell’origin. Poi correggi il maggiore collo di bottiglia confermato.
La maggior parte dei siti non ha bisogno di architetture esotiche. Ha bisogno di meno cache miss evitabili, meno lavoro backend bloccante, redirect più puliti e un’idea più chiara di cosa deve accadere prima che il primo byte venga inviato.
Domande frequenti
Il TTFB è una metrica Core Web Vitals?
Qual è un buon obiettivo per il TTFB?
Aggiungere una CDN risolverà automaticamente il TTFB?
L’ottimizzazione di JavaScript può migliorare il TTFB?
Perché il mio TTFB è lento solo per gli utenti loggati?
Fonti e letture ulteriori